Frontier3DBench:跨物件、場景 & 開放世界的 3D 創作編碼代理基準測試
Frontier3DBench 評估編碼代理在物件、場景及互動式開放世界中建立可編輯且可執行的 3D 專案的能力。
原始論文:Frontier3DBench: Benchmarking Coding Agents for 3D Creation across Objects, Scenes, and Interactive Open Worlds(2026 年 11 月 6 日;v1)。
重點與結果
Frontier3DBench 探討 coding agent 是否能跨物件、場景和互動式世界交付可編輯、可執行的 3D 專案。對於選擇 AI 創作工作流程的團隊而言,其貢獻是一套通用的評估框架:涵蓋九個類別的 145 項任務,包括 65 項 Blender 物件任務、65 項 Blender 場景任務,以及 15 項 Unreal Engine 世界任務。輸入內容包括指令、參考圖片、照片和現有場景。
作者評估了 11 種模型–harness 配置。GPT-6.1-sol 搭配 Codex 以 66.02/100 的成績取得整體領先;GPT-6-astra 搭配 Codex 則在互動式世界項目中以 61.28 領先。每種配置在參考重建上的表現都比文字驅動的物件和場景生成更差。在 165 個世界提交結果中,區域機制平均得分為 83.08,移動部件間隙為 20.82,有狀態工作流程為 30.26。這些是元件分數,而不是成功完成世界的百分比。
一項人工研究提供了有限的校準:八名評分者針對 45 個受參考條件約束的物件/場景項目,各自對四個候選方案進行排名。自動分數的 Kendall tau-b 平均值為 0.727,在勝出者上的一致率為 79.2%,但在完整排名上的一致率只有 44.7%。這並不能驗證每個任務類別或世界行為。請參閱實驗。
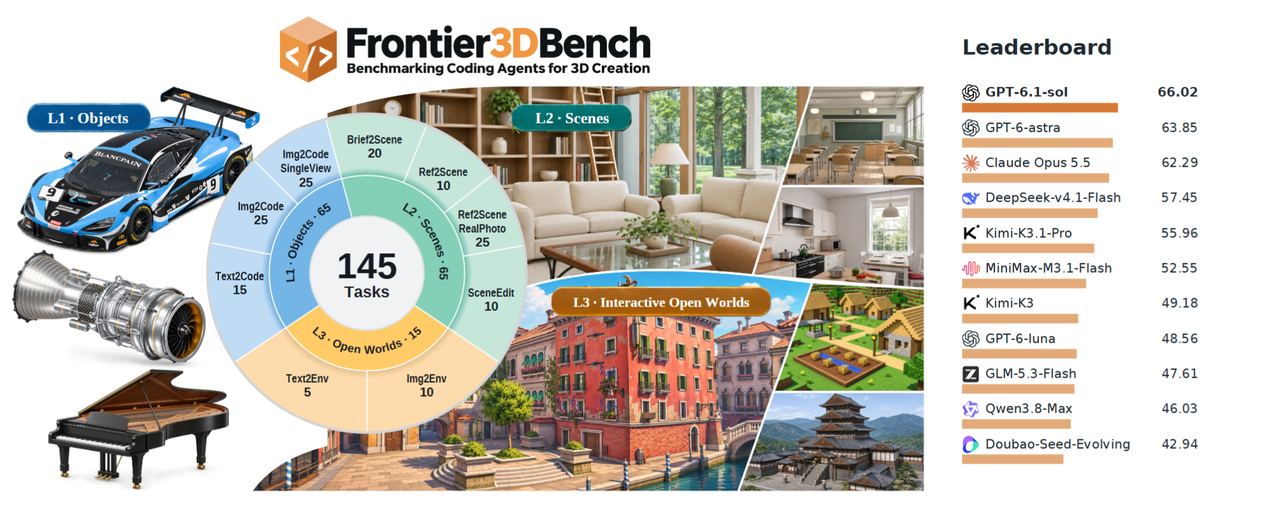
評估方式
Agent 會收到一份任務契約:所需的幾何結構和外觀、適用時的參考圖片,以及用於編輯的初始資產。世界任務另外定義實體、初始狀態、允許的操作和前置條件。Agent 編寫並執行建構程式碼,然後提交原生 Blender 或 Unreal 專案,以及必要的匯出檔案。評估檔案會保留在其工作區之外。
在已發布的協調器中,公開的執行檢查可以觸發修復,但 agent 收到的是錯誤,而不是私有分數。評估前,接受的原始碼會被凍結並雜湊。獨立的評估器會重新執行程式、檢查原生幾何結構、算繪視圖並判定任務是否完成。論文使用 Blender 5.2.1 和 Unreal Engine 5.8.3;L1/L2 生成最多允許在 32 小時內嘗試六次。這些是預算上限,不是實測完成時間。
評分會依任務而變化。參考重建由 50% 圖像相似度、20% 投影物件定位、20% 視覺判斷和 10% 細節組成。圖像相似度衡量結構、邊緣、色彩和色調;定位會比對物件邊界框,並對缺少或多出的實例進行懲罰。GPT-6-astra 以中等推理強度,並在隱藏生成器身分的情況下,依固定的視覺標準進行判斷。細節檢查使用涵蓋率乘以一減偏差,然後取所需執行/匯出變體中最弱的一項。一般 L1 任務會以原生格式和 GLB 格式檢查四次執行結果;L2 則使用四個原生變體。
場景編輯會分別衡量要求的修改,以及受保護周邊環境的保留情況。世界評估會使用獨立觀察者重建提交的專案,並測試可見的動作效果、移動部件的交集、角色的實際移動和持久狀態。連續工作流程禁止傳送和重設。因此,單獨開啟一扇門,不能取代完成一條要求抵達、解鎖並通過該門的路線。
世界分數按照 60/20/5/15 的比例加權視覺品質、任務忠實度、佈局和互動。最終基準總分按照 30/30/40 的比例加權 L1/L2/L3。評分契約區分已確認的候選方案缺陷與缺少技術證據:API 或測量失敗不得悄悄變成零分。
應用與未解決挑戰
此基準支援選擇 coding-agent 工作流程,並診斷失敗涉及外觀、幾何結構、編輯還是行為。其開放儲存庫包含任務輸入、生成/評估程式碼和評分契約;基準軟體使用 Apache-2.0,而任務資產保留其各自的授權。Blender、Unreal Engine 和模型存取都需要另外設定。
論文指出兩項核心未解決挑戰:匹配指定的幾何結構和佈局,以及協調移動部件、動作和持久狀態。這些是作者的研究方向,而非已宣布的產品功能。比較結果描述的是完整的模型–harness 設定,視覺判斷仍有校準限制;照片任務也缺乏通用的原生 3D 真值。本文閱讀了論文和實作,但沒有重新執行該基準。
常見問題
Frontier3DBench 本身是一個 3D 生成模型嗎?
不。它為建構 Blender 和 Unreal 專案的程式編碼代理提供任務與評估器。它並未引入經過訓練的網格生成器或新的 3D 潛在表示法。
為什麼僅有螢幕截圖不足以提交?
合約要求提供可編輯的原生資產及可執行的行為。評估人員會檢查幾何結構、重新渲染已儲存的場景,並測試互動,因此僅憑外觀無法證明其正確性。
最高的整體分數是否能找出每項工作的最佳代理人?
不是。不同任務家族的領先者各異,而且分數包含測試框架與推理設定。選擇工作流程前,請先比較相關的任務設定檔。




