SeMo3D: Thống nhất việc tạo, chỉnh sửa và hoàn thiện 3D thông qua mô hình hóa có chọn lọc
SeMo3D giới thiệu một phương pháp tiếp cận thống nhất để tạo 3D, chỉnh sửa cục bộ và hoàn thiện bằng mô hình hóa có chọn lọc.

Điểm nổi bật và Kết quả: Thay đổi Điều Quan trọng
Bài báo gốc: SeMo3D: Thống nhất việc Tạo sinh, Chỉnh sửa và Hoàn thiện 3D thông qua Mô hình hóa Chọn lọc
SeMo3D, được các nhà nghiên cứu tại Đại học Nam Kinh giới thiệu, đưa tạo sinh 3D, chỉnh sửa cục bộ và hoàn thiện vào cùng một khung. Đối với các nhóm đang khám phá việc tạo tài sản bằng AI, điểm hứa hẹn cốt lõi của nó là tính liên tục: tạo một đối tượng, sửa đổi một vùng được chọn hoặc tái dựng một phần bị thiếu trong khi vẫn giữ lại ngữ cảnh hiện có. Tên gọi này là viết tắt của Selective Modeling (Mô hình hóa Chọn lọc), một chiến lược biến vùng cần tổng hợp thành giao diện chung giữa các tác vụ này. Kho lưu trữ chính thức.
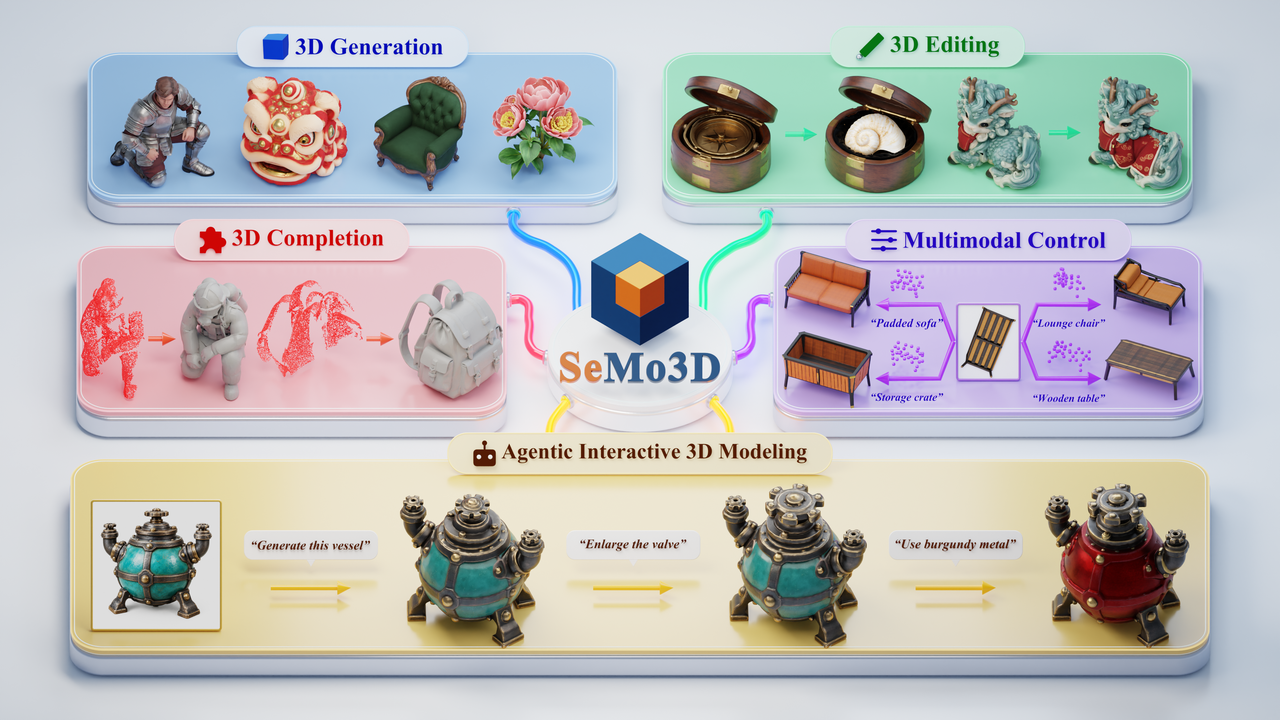
Trên Toys4K, các tác giả báo cáo Chamfer Distance hình học là 0.0118 so với 0.0330 của TRELLIS.2 (thấp hơn là tốt hơn). Khả năng bảo toàn khi chỉnh sửa đạt 37.39 dB PSNR so với 31.55 dB của VoxHammer. F-score khi hoàn thiện đạt 0.541 so với 0.412 của HY3D-Omni với hướng dẫn điểm bổ sung. Đầu vào được hỗ trợ khác nhau giữa các phương pháp, và các gợi ý điểm đến từ ground truth; những so sánh này không cô lập mức cải thiện do kiến trúc. Bài báo, Bảng 1–3.
Cách hoạt động: Chọn, Tổng hợp, Bảo toàn
Sự trừu tượng hóa cốt lõi chia một tài sản thành vùng được chọn S và ngữ cảnh được bảo toàn C. Tạo sinh chọn mọi thứ; chỉnh sửa chọn mục tiêu; hoàn thiện chọn phần bị thiếu. Với một chiếc ghế, cùng một giao diện có thể tạo toàn bộ chiếc ghế, thay phần tựa lưng hoặc tái dựng một chân bị thiếu. Đây là những cách sử dụng minh họa cho định nghĩa tác vụ. Mô hình học một bài toán tổng hợp vùng dùng chung thay vì yêu cầu một quy trình huấn luyện riêng cho từng tác vụ. Tổng quan kho lưu trữ.
SeMo3D tinh chỉnh ba mô hình flow của TRELLIS.2 trên Trellis-500K và tái sử dụng SC-VAE của mô hình này. Cấu trúc thưa dự đoán mức chiếm chỗ trên lưới latent 16³; hình dạng và kết cấu hoạt động tại các vị trí bị chiếm chỗ trong lưới 32³, tạo ra hình học và vật liệu PBR. Mặt nạ được truyền qua các giai đoạn. Do đó, việc thống nhất tác vụ vẫn sử dụng ba mô hình dành riêng cho từng giai đoạn. Bài báo, chi tiết về phương pháp và huấn luyện.
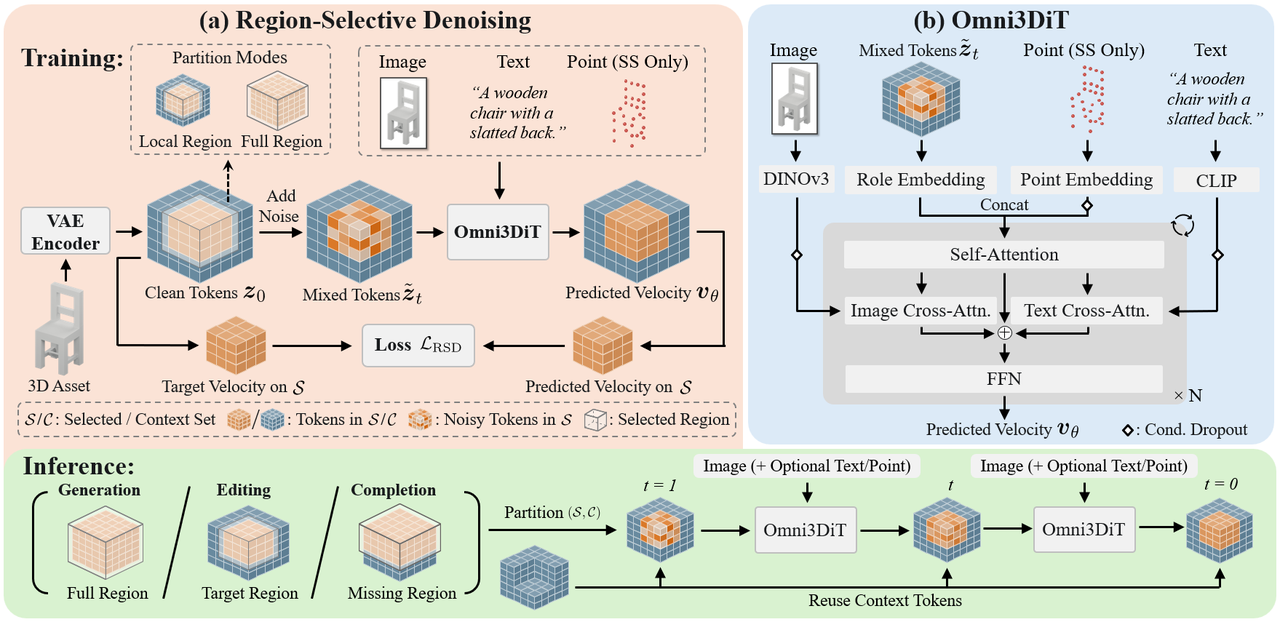
Khử nhiễu chọn lọc theo vùng tạo ra các mẫu huấn luyện từ những tài sản thông thường. Một vùng ngẫu nhiên nhận nhiễu trong khi phần xung quanh vẫn sạch; chỉ các dự đoán trong vùng đó đóng góp vào hàm mất mát. Quá trình huấn luyện trải dài từ các hộp cục bộ đến toàn bộ tài sản, không cần các bộ dữ liệu chỉnh sửa hoặc hoàn thiện theo cặp trước-sau. Khi suy luận, các token được chọn bắt đầu từ nhiễu và tiến hóa dưới sự hướng dẫn, trong khi các token ngữ cảnh ban đầu được sử dụng lại ở mọi bước. Vì vậy, mô hình có thể tham chiếu toàn bộ đối tượng mà không cần tổng hợp lại toàn bộ đối tượng đó. Giải thích phương pháp chính thức.
Omni3DiT giúp hiểu đầu vào hỗn hợp này. Các embedding vai trò xác định token được chọn và token ngữ cảnh. Các nhánh cross-attention song song đưa đặc trưng hình ảnh DINOv3 và đặc trưng văn bản CLIP vào; token điểm đi vào self-attention trong giai đoạn cấu trúc thưa. Hình ảnh định hướng diện mạo, văn bản bổ sung ý định ngữ nghĩa, còn các điểm ràng buộc bố cục không gian. Việc loại bỏ điều kiện thay đổi hướng dẫn khả dụng trong quá trình huấn luyện, khuyến khích mô hình sử dụng các tín hiệu bổ sung cho nhau. Sơ đồ kiến trúc chính thức.
Hình ảnh vẫn là bắt buộc. Tạo sinh sử dụng 12 bước Euler cho mỗi giai đoạn; chỉnh sửa/hoàn thiện sử dụng 50 bước cho cấu trúc và 12 bước cho hình dạng và kết cấu. Việc bảo toàn nghiêm ngặt áp dụng cho các token latent, không nhất thiết áp dụng cho mọi đỉnh được giải mã. Bài báo và phụ lục suy luận.
Ứng dụng và Những bước tiếp theo
Cơ hội thực tiễn nằm ở công việc lặp lại: khám phá các biến thể đạo cụ, sửa chữa các tham chiếu chưa hoàn chỉnh và tinh chỉnh tài sản thông qua các chỉ dẫn liên tiếp. Dự án chính thức cũng trình diễn các quy trình tác vụ của agent, trong đó chuẩn bị hình ảnh tham chiếu, xác định vùng chỉnh sửa và gọi SeMo3D. Điều này gợi ý một sự phân công hữu ích: agent chuyển ý định thành yêu cầu mô hình hóa, còn mô hình 3D xử lý việc tổng hợp vùng. Các bản trình diễn tương tác của dự án.
Mức độ sẵn sàng vẫn còn hạn chế. Theo kiểm tra vào ngày 6 tháng 11 năm 2026, kho lưu trữ chính thức chứa tài liệu và tài sản trình diễn; trọng số cùng mã huấn luyện, suy luận và đánh giá vẫn chưa được phát hành. Giấy phép MIT không xác lập các điều khoản cấp phép cho những trọng số trong tương lai. Bài viết này đánh giá bài báo và kho lưu trữ hiện có, không tuyên bố đã tái tạo độc lập. Danh sách kiểm tra phát hành.
Các tác giả xác định hai hướng nghiên cứu. Các biểu diễn 3D có độ trung thực cao hơn có thể nắm bắt tốt hơn những cấu trúc mảnh như tàu lá cọ, vốn khó được các latent có cấu trúc hiện tại phân giải. Các bộ mã hóa thị giác-ngôn ngữ mạnh hơn có thể cải thiện khả năng hiểu các prompt tổng hợp phức tạp; bài báo cho thấy những quả màu cam trở thành kết cấu màu cam thay vì các đối tượng riêng biệt. Hạn chế và Công việc Tương lai. Các mốc phát hành còn lại của dự án là trọng số mô hình trên Hugging Face và mã suy luận, huấn luyện và đánh giá hoàn chỉnh. Danh sách TODO chính thức.
Câu hỏi thường gặp
SeMo3D có thể tạo hoặc chỉnh sửa tài nguyên chỉ bằng văn bản không?
Không. Bài báo yêu cầu hướng dẫn bằng hình ảnh; văn bản và các điểm thưa là những điều kiện bổ sung không bắt buộc. Việc chỉnh sửa cũng cần một vùng được chọn và ngữ cảnh nguồn. Các minh họa tác nhân bằng ngôn ngữ tự nhiên bao gồm bước chuẩn bị hình ảnh thay vì loại bỏ yêu cầu về hình ảnh. [Nguồn](https://arxiv.org/html/2611.02568v1#S3.SS2).
Tôi có thể thay lưng ghế mà vẫn giữ nguyên phần còn lại không?
Điều đó minh họa quy trình chỉnh sửa cục bộ dự kiến: chọn vùng tựa lưng, cung cấp hướng dẫn và tổng hợp các token của vùng đó trong khi tái sử dụng các token ngữ cảnh. Việc bảo toàn chính xác áp dụng cho các token tiềm ẩn; không nên hiểu đây là sự đảm bảo rằng mọi đỉnh được giải mã đều giữ nguyên. [Nguồn](https://arxiv.org/html/2611.02568v1#S3.SS3).
Bây giờ tôi có thể triển khai SeMo3D cục bộ không?
Theo kiểm tra ngày 6 tháng 11 năm 2026, trọng số mô hình cùng mã hoàn chỉnh cho suy luận, huấn luyện và đánh giá vẫn là các mốc phát hành chưa được đánh dấu hoàn tất. Bài báo công khai và các bản trình diễn hỗ trợ đánh giá kỹ thuật, nhưng kho lưu trữ vẫn chưa cung cấp đầy đủ bộ công cụ triển khai cục bộ. [Nguồn](https://github.com/XiaokunSun/SeMo3D#-todo).




