SeMo3D: Об’єднання генерації, редагування та доповнення 3D за допомогою вибіркового моделювання
SeMo3D представляє уніфікований підхід до 3D-генерації, локального редагування та доповнення за допомогою вибіркового моделювання.

Основні моменти та результати: змініть те, що має значення
Оригінальна стаття: SeMo3D: уніфікація 3D-генерації, редагування та доповнення за допомогою вибіркового моделювання
SeMo3D, представлена дослідниками Нанкінського університету, об’єднує 3D-генерацію, локальне редагування та доповнення в єдину структуру. Для команд, які досліджують створення ресурсів за допомогою ШІ, її головна перевага — безперервність: створювати об’єкт, змінювати вибрану область або реконструювати відсутню частину, зберігаючи наявний контекст. Назва розшифровується як Selective Modeling, тобто вибіркове моделювання — стратегія, за якої область для синтезу є спільним інтерфейсом між цими завданнями. Офіційний репозиторій.
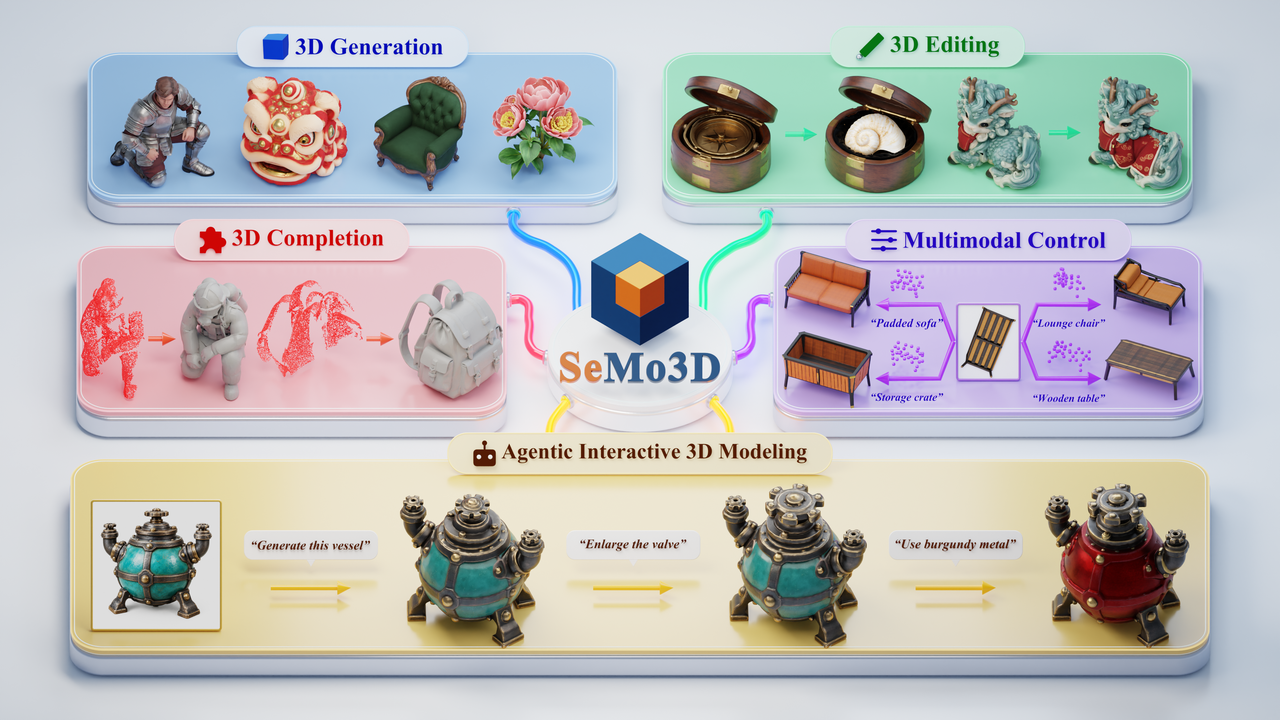
На Toys4K автори повідомляють про геометричну відстань Чамфера 0.0118 проти 0.0330 у TRELLIS.2 (менше — краще). Збереження під час редагування досягає 37.39 дБ PSNR проти 31.55 дБ у VoxHammer. F-міра доповнення досягає 0.541 проти 0.412 у HY3D-Omni за використання додаткових точкових підказок. Підтримувані вхідні дані відрізняються залежно від методу, а точкові підказки отримано з еталонних даних; ці порівняння не ізолюють переваги архітектури. Стаття, таблиці 1–3.
Як це працює: вибір, синтез, збереження
Ключова абстракція ділить ресурс на вибрану область S і збережений контекст C. Під час генерації вибирається все; під час редагування — цільова область; під час доповнення — відсутня частина. Для стільця той самий інтерфейс може створити весь стілець, замінити його спинку або реконструювати відсутню ніжку. Це ілюстративні приклади визначення завдання. Модель вивчає спільну задачу регіонального синтезу, а не потребує окремої специфічної для завдання процедури навчання. Огляд репозиторію.
SeMo3D донавчає три flow-моделі TRELLIS.2 на Trellis-500K і повторно використовує його SC-VAE. Розріджена структура прогнозує заповнення на латентній сітці 16³; форма й текстура працюють у зайнятих позиціях на сітці 32³, створюючи геометрію та PBR-матеріали. Маска переноситься між етапами. Отже, уніфікація завдань усе одно використовує три специфічні для етапів моделі. Стаття, деталі методу й навчання.
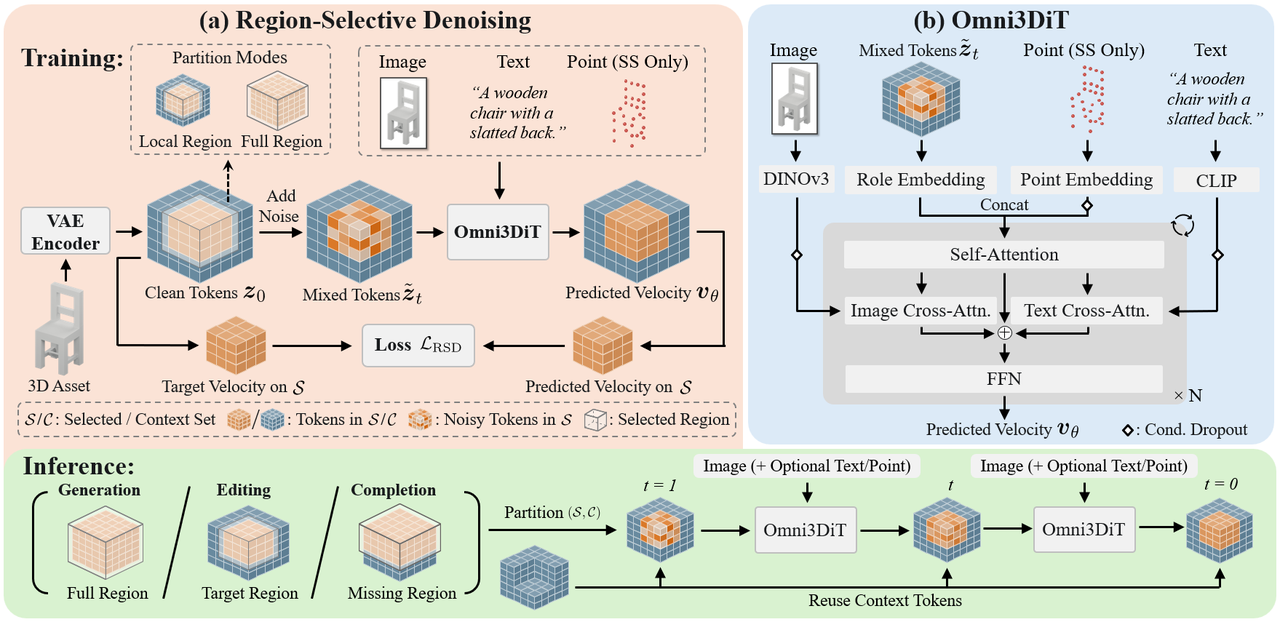
Регіонально-вибіркове видалення шуму створює навчальні приклади зі звичайних ресурсів. Випадкова область отримує шум, тоді як її оточення залишається чистим; до функції втрат додаються лише передбачення в цій області. Навчання охоплює діапазон від локальних блоків до цілих ресурсів, тому не потребує парних наборів даних до і після редагування або доповнення. Під час інференсу вибрані токени починають із шуму й еволюціонують під керуванням, тоді як токени оригінального контексту повторно використовуються на кожному кроці. Тому модель може звертатися до всього об’єкта, не синтезуючи його повністю заново. Офіційне пояснення методу.
Omni3DiT допомагає інтерпретувати цей змішаний вхід. Вбудовування ролей ідентифікують вибрані токени та токени контексту. Паралельні гілки перехресної уваги додають ознаки зображень DINOv3 та текстові ознаки CLIP; точкові токени входять у self-attention на етапі розрідженої структури. Зображення керують зовнішнім виглядом, текст додає семантичний намір, а точки обмежують просторове компонування. Відкидання умов варіює доступні підказки під час навчання, заохочуючи модель використовувати взаємодоповнювальні сигнали. Офіційна схема архітектури.
Зображення залишається обов’язковим. Генерація використовує 12 кроків Euler на кожному етапі; редагування/доповнення — 50 для структури та 12 для форми й текстури. Суворе збереження застосовується до латентних токенів, а не обов’язково до кожної декодованої вершини. Стаття та додаток про інференс.
Застосування та подальші перспективи
Практична можливість полягає в ітеративній роботі: дослідженні варіантів реквізиту, виправленні неповних референсів і вдосконаленні ресурсів за допомогою послідовних інструкцій. Офіційний проєкт також демонструє агентні робочі процеси, які готують референсні зображення, визначають області редагування та викликають SeMo3D. Це передбачає корисний розподіл праці: агент перетворює намір на запит до моделі, а 3D-модель виконує регіональний синтез. Інтерактивні демонстрації проєкту.
Готовність залишається обмеженою. Станом на 6 листопада 2026 року офіційний репозиторій містить документацію та демонстраційні ресурси; ваги, а також код навчання, інференсу й оцінювання ще не опубліковані. Ліцензія MIT не визначає умови ліцензування майбутніх ваг. У цій статті розглянуто публікацію та доступний репозиторій без заяв про незалежне відтворення. Список перевірки релізу.
Автори визначають два напрями досліджень. 3D-представлення з вищою точністю можуть краще відтворювати тонкі структури, як-от пальмове листя, із якими поточні структуровані латенти мають труднощі. Потужніші візуально-мовні енкодери можуть покращити розуміння складних композиційних запитів; у статті показано, як помаранчеві фрукти перетворюються на помаранчеву текстуру, а не на окремі об’єкти. Обмеження та подальша робота. Серед незавершених етапів релізу проєкту — ваги моделі на Hugging Face та повний код інференсу, навчання й оцінювання. Офіційний список TODO.
Поширені запитання
Чи може SeMo3D створювати або редагувати ресурс лише за текстовим описом?
Ні. У статті потрібне керування за допомогою зображення; текст і розріджені точки є необов’язковими додатковими умовами. Для редагування також потрібні вибрана область і контекст джерела. Демонстрації агента природною мовою включають підготовку зображення, а не усувають вимогу щодо зображення. [Джерело](https://arxiv.org/html/2611.02568v1#S3.SS2).
Чи можу я замінити спинку стільця, залишивши решту?
Це ілюструє передбачений робочий процес локального редагування: виберіть область спинки, надайте вказівки та синтезуйте її токени, повторно використовуючи контекстні токени. Точне збереження стосується латентних токенів; це не слід сприймати як гарантію того, що кожна декодована вершина залишиться ідентичною. [Джерело](https://arxiv.org/html/2611.02568v1#S3.SS3).
Чи можу я вже розгорнути SeMo3D локально?
Станом на 6 листопада 2026 року ваги моделі, а також повний код інференсу, навчання й оцінювання досі не позначені як виконані пункти плану релізу. Публічна стаття та демонстрації дають змогу провести технічне оцінювання, але репозиторій ще не містить повного стека для локального розгортання. [Джерело](https://github.com/XiaokunSun/SeMo3D#-todo).




