Frontier3DBench: Оцінювання агентів програмування для 3D-створення об'єктів, сцен і відкритих світів
Frontier3DBench оцінює здатність агентів програмування створювати редаговані та виконувані 3D-проєкти з об’єктами, сценами та інтерактивними відкритими світами.
Оригінальна стаття: Frontier3DBench: Benchmarking Coding Agents for 3D Creation across Objects, Scenes, and Interactive Open Worlds (6 листопада 2026 року; версія 1).
Основні моменти та результати
Frontier3DBench досліджує, чи можуть агенти програмування створювати редаговані й виконувані 3D-проєкти для об’єктів, сцен та інтерактивних світів. Для команд, які обирають робочий процес із використанням ШІ для створення контенту, його внесок полягає у спільній системі оцінювання: 145 завдань у дев’яти категоріях, зокрема 65 завдань для об’єктів у Blender, 65 завдань для сцен у Blender і 15 завдань для світів в Unreal Engine. Вхідні дані містять інструкції, еталонні зображення, фотографії та наявні сцени.
Автори оцінюють 11 конфігурацій моделей і середовищ виконання. GPT-6.1-sol із Codex лідирує загалом із результатом 66.02/100; GPT-6-astra із Codex лідирує в інтерактивних світах із результатом 61.28. Кожна конфігурація демонструє гірші результати під час реконструкції за еталоном, ніж під час генерації об’єктів і сцен на основі тексту. У 165 поданнях світів локальні механізми в середньому отримали 83.08, зазор між рухомими частинами — 20.82, а робочі процеси зі збереженням стану — 30.26. Це компонентні оцінки, а не відсотки успішно завершених світів.
Дослідження за участю людей забезпечує обмежене калібрування: вісім оцінювачів ранжують чотири кандидати для кожного з 45 об’єктів або сцен із референсами. Автоматичні оцінки досягають середнього Kendall tau-b 0.727 і 79.2% збігу щодо переможця, але лише 44.7% збігу щодо повного ранжування. Це не підтверджує коректність кожної категорії завдань або поведінки світів. Див. експерименти.
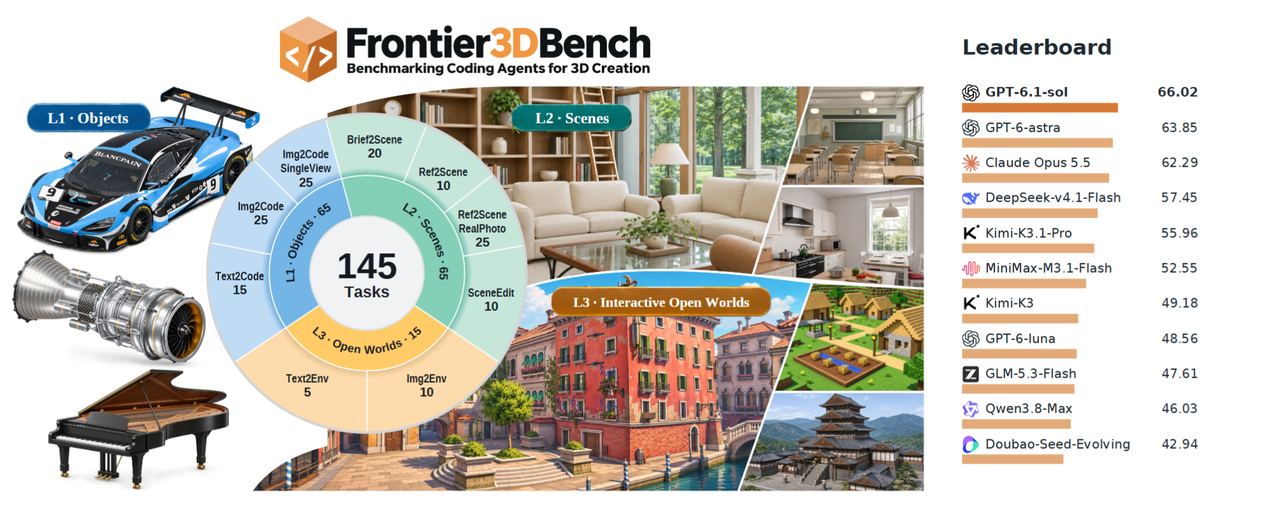
Як працює оцінювання
Агент отримує контракт завдання: необхідну геометрію та зовнішній вигляд, еталонні зображення, якщо вони потрібні, і початкові ресурси для редагування. Завдання зі світами додатково визначають сутності, початкові стани, дозволені операції та передумови. Агент пише й виконує код побудови, а потім надсилає нативний проєкт Blender або Unreal разом із необхідними експортованими файлами. Файли оцінювання залишаються за межами його робочого простору.
У опублікованому оркестраторі загальнодоступні перевірки виконання можуть запускати виправлення, але агент отримує помилки, а не приватні оцінки. Прийнятий вихідний код фіксується та хешується перед оцінюванням. Окремі оцінювачі повторно запускають програму, перевіряють нативну геометрію, рендерять подання та визначають виконання завдання. У статті використовуються Blender 5.2.1 і Unreal Engine 5.8.3; генерація L1/L2 допускає до шести спроб протягом 32 годин. Це граничні бюджети, а не виміряний час виконання.
Методика оцінювання змінюється залежно від завдання. Реконструкція за еталоном поєднує 50% схожості зображення, 20% локалізації об’єктів у проєкції, 20% візуального оцінювання та 10% деталізації. Схожість зображення вимірює структуру, краї, колір і тон; локалізація зіставляє рамки об’єктів і штрафує за відсутні або зайві екземпляри. GPT-6-astra із середнім рівнем зусиль оцінює фіксовані візуальні критерії, не знаючи ідентичності генератора. Для деталізації перевірка використовує покриття, помножене на одиницю мінус відхилення, а потім бере найслабший обов’язковий варіант виконання або експорту. Звичайні завдання L1 перевіряють чотири виконання у нативному форматі та GLB; L2 використовує чотири нативні варіанти.
Редагування сцен окремо вимірює запитану модифікацію та збереження захищеного оточення. Оцінювання світів перебудовує надісланий проєкт із незалежним спостерігачем і перевіряє видимі ефекти дій, перетини рухомих частин, фактичний рух персонажа та сталий стан. Безперервні робочі процеси забороняють телепортацію та скидання. Тому відчинення дверей в ізоляції не може замінити проходження маршруту, для якого потрібно дійти до дверей, відімкнути їх і пройти крізь них.
Оцінки світів зважують візуальну якість, відповідність завданню, компонування та взаємодію у співвідношенні 60/20/5/15. Підсумкова оцінка бенчмарку зважує L1/L2/L3 у співвідношенні 30/30/40. Контракт оцінювання розрізняє підтверджені дефекти кандидата та відсутні технічні докази: помилка API або вимірювання не повинна мовчки перетворюватися на нуль.
Застосування та відкриті проблеми
Бенчмарк підтримує вибір робочих процесів із агентами програмування та діагностику того, чи стосуються невдач зовнішнього вигляду, геометрії, редагування або поведінки. Його відкритий репозиторій містить вхідні дані завдань, код генерації й оцінювання та контракти оцінювання; програмне забезпечення бенчмарку використовує Apache-2.0, а ресурси завдань зберігають власні ліцензії. Blender, Unreal Engine і доступ до моделей потребують окремого налаштування.
У статті визначено дві центральні відкриті проблеми: відповідність заданій геометрії та компонуванню, а також координація рухомих частин, дій і сталого стану. Це дослідницькі напрями авторів, а не анонсовані функції продукту. Порівняння описують повні конфігурації моделей і середовищ виконання, а візуальне оцінювання зберігає обмеження калібрування; для фотографічних завдань також немає універсальної нативної 3D-еталонної істини. Цей огляд опрацьовує статтю та реалізацію, але не повторно запускає бенчмарк.
Поширені запитання
Чи є Frontier3DBench власне моделлю генерації 3D?
Ні. Він надає завдання та засоби оцінювання для агентів програмування, які створюють проєкти в Blender та Unreal. Він не представляє навчений генератор 3D-сіток або нове латентне 3D-представлення.
Чому скриншотів недостатньо для подання?
Контракт вимагає редагованих нативних артефактів і виконуваної поведінки. Оцінювачі перевіряють геометрію, повторно відтворюють збережені сцени та тестують взаємодії, тож сама лише зовнішність не може підтвердити правильність.
Чи визначає найвищий загальний бал найкращого агента для кожної роботи?
Ні. Лідери різняться залежно від сімейства завдань, а оцінка враховує тестовий стенд і конфігурацію міркувань. Порівняйте відповідний профіль завдання, перш ніж обирати робочий процес.
Пов’язані статті

Генератор 3D-моделей на основі ШІ: зображення в 3D проти тексту в 3D
 Tammy · 13 серп. 2026 р.

Порівняння платформ для створення 3D за допомогою ШІ: V2Fun проти Meshy та Tripo
 V2Fun Team · 2 вер. 2026 р.

Посібник із ШІ-інструмента для 3D-моделей: перетворюйте фотографії товарів на 3D-моделі
Tammy · 17 черв. 2026 р.