UltraTex: Pagpapakawala ng 2K Multi-View Diffusion para sa 3D Texturing
Ang UltraTex ay isang proyekto ng SIGGRAPH Asia 2026 na gumagamit ng mga multi-view diffusion model upang bumuo ng mga texture na may mataas na resolusyon (2K) para sa mga 3D mesh mula sa mga reference image, na tumutugon sa mga limitasyon ng mas mabababang resolusyon gaya ng 512 o 768.

Mga Tampok at Resulta: Mas Detalyado, Mas Kaunting Nasasayang na Compute
Orihinal na papel: UltraTex: Unleashing 2K Multi-View Diffusion for 3D Texturing
Gumagawa ang UltraTex ng mga detalyadong texture para sa isang umiiral na 3D mesh gamit ang isang reference image. Iniharap bilang proyekto para sa SIGGRAPH Asia 2026, tinutugunan nito ang isang karaniwang bottleneck: nawawala ang maliliit na pattern at detalye ng surface sa multi-view texturing sa 512 o 768 na resolution. Itinataas ng UltraTex ang mga ginawang view sa 2048 × 2048 sa pamamagitan ng pagtutuon ng computation sa foreground ng object. Ang pangunahing ambag nito ay ang pagiging praktikal ng high-resolution multi-view diffusion sa pamamagitan ng magkakaugnay na pagbabago sa token processing, attention, at decoding. Opisyal na proyekto.
Sa 100 TexVerse object na hindi isinama sa training, iniuulat ng UltraTex ang unshaded LPIPS na 0.082 kumpara sa 0.138 ng LumiTex, kung saan nangangahulugang mas malapit na perceptual agreement ang mas mababang halaga. Sa isang H200, iniulat ng mga may-akda ang 20.6–91.1× na training at 22.3–74.6× na inference speedup kumpara sa dense baseline para sa 10–30% foreground occupancy na may 20% attention-block retention. Nakadepende ang mga ito sa configuration at hindi kumakatawan sa isang nakapirming acceleration para sa bawat asset o kumpletong production workflow. Papel, mga eksperimento.
Paano Ito Gumagana: Mula sa Reference Image Patungo sa Textured Surface
Una munang nagre-render ang pipeline ng anim na normal map mula sa input mesh: apat na side view, isang top view, at isang bottom view. Ine-encode ng VAE ang geometry guidance at reference image bilang mga latent. Pagkatapos, gumagawa ang isang pretrained na FLUX diffusion transformer ng anim na katumbas na texture view sa pamamagitan ng flow matching; nire-reproject ng buong pipeline ng papel ang mga ito papunta sa mesh. Sa 2K, ang anim na target view, anim na geometry view, at isang reference ay bumubuo ng 212,992 image token, na nagpapaliwanag kung bakit nagiging magastos ang dense processing. Pipeline; paliwanag sa token cost.
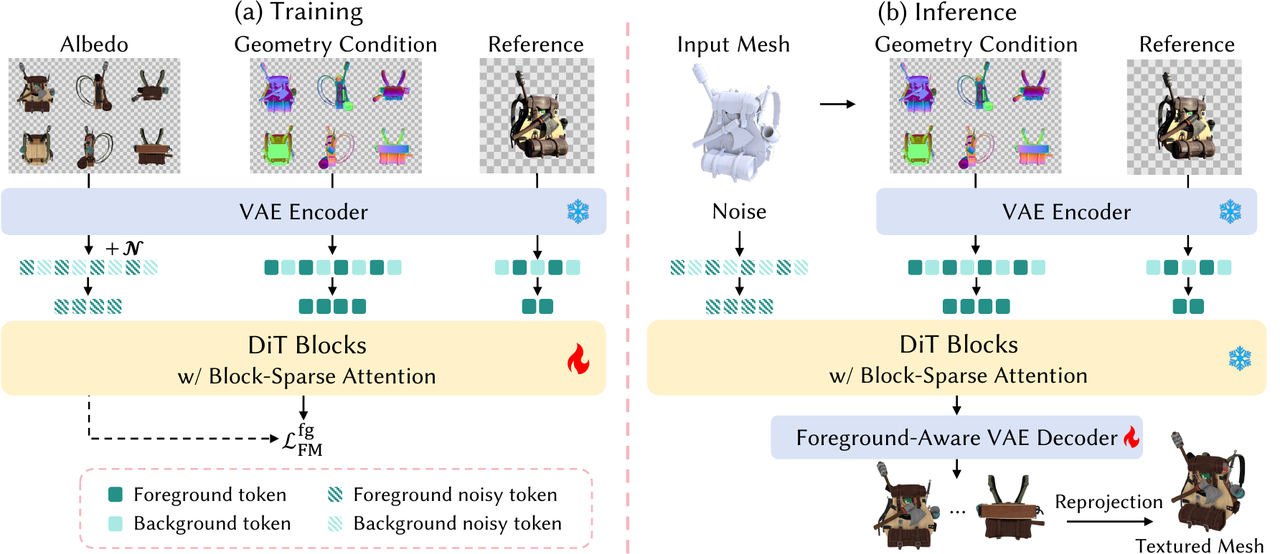
Background Token Dropping ang nag-aalis ng mga image token sa labas ng object bago ang transformer blocks. Tinutukoy ng mga mask ang mga posisyong pananatilihin, habang nananatiling nakakabit ang katumbas na orihinal na rotary positional embeddings (RoPE). Nagiging mas maikli ang sequence nang hindi nawawala ang spatial coordinates nito. Nakatitipid ito ng trabaho sa buong backbone, kabilang ang mga feed-forward layer. Sa inilabas na sampler, ang Euler update ay nagbabago lamang sa mga piling foreground position; hindi ginagalaw ang background noise hanggang sa paghahanda para sa decoding. Pagpili ng token; implementasyon ng sampling.
Block-Sparse Attention ang nagpapababa sa gastos ng mga interaction sa pagitan ng mga natitirang token. Ina-average ng implementasyon ang query at key feature sa loob ng mga block, tinatantiya ang relevance ng mga ito, at pinipili ang mga key block na may pinakamataas na score para sa bawat query block. Pagkatapos, ginagamit ng attention ang orihinal na token feature sa loob ng mga napiling block. Pinananatili ng FLUX.1 configuration ang 20% ng mga key block: iniiwasan nito ang maraming interaction nang hindi binabawasan ang image resolution. Pagpili ng block; configuration ng attention.
VAE na May Kamalayan sa Foreground Pagde-decode tinutugunan ang resulta ng paglaktaw sa background denoising. Maaaring masira ang reconstruction kapag pinagsama ang malinis na foreground at maingay na background. Pinapalitan ng UltraTex ang background ng latent na in-encode mula sa isang solid black image, pagkatapos ay gumagamit ng decoder na inangkop sa composite na ito. Nanatiling frozen ang encoder; miniminimize ng decoder training ang reconstruction error sa mga foreground pixel lamang. Pagkatapos ng decoding, sine-save ng mga inilabas na inference script ang mga multi-view image. Kailangan pa rin ng reprojection o baking step para maisama ang mga output na ito sa isang mesh asset. Decoder training; mga inference output.
Ang pundasyon ng data ay G-buffer TexVerse. Saklaw ng pampublikong release nito ang 351,847 BSDF asset, habang gumagamit ang UltraTex ng na-filter na training subset na may 268,365 asset. Nagbibigay ang mga rendering ng normals, coordinates, albedo, at mga available na material channel na hanggang 4096 × 4096. Dapat ihiwalay ang resolution ng data na ito sa ipinakitang 2K generation ng UltraTex. Paglalarawan ng dataset.
Mga Application, Availability, at Mga Direksyong Hinaharap
Tinututukan ng UltraTex ang appearance stage ng paggawa ng asset: pagbibigay ng detalyadong surface texture para sa umiiral na character, prop, at object geometry. Ang default na output ay albedo, na kumakatawan sa kulay ng surface nang walang baked-in lighting. Nagbibigay rin ang kasalukuyang repository ng FLUX.2 metallic–roughness branch na may magkahiwalay na LoRA weight. Dapat ihiwalay ang available na extension na ito sa albedo benchmark ng pangunahing papel, kung saan nire-render ang UltraTex gamit ang mga nakapirming roughness at metallic value. Mga available na material output; mga setting ng evaluation.
Batay sa pagsusuri noong Nobyembre 6, 2026, pampubliko ang training at inference code at mga tagubilin sa pag-download ng weight. Sinusuportahan ng repository ang mga variant na FLUX.1-dev at FLUX.2-Klein, na bawat isa ay nangangailangan ng katugmang backbone, LoRA, at decoder file. Gumagamit ang nasubukang environment nito ng Python 3.12, CUDA 12.4, at PyTorch 2.5.1. Sinusuri ng artikulong ito ang papel at implementasyon; hindi nito inaangkin ang isang independiyenteng reproduction ng kalidad o bilis. Opisyal na repository.
Tinutukoy ng mga may-akda ang kahirapan sa mga texture na lubhang paulit-ulit at pagkawala ng detalye dahil sa compressed representation ng pretrained VAE. Ang kanilang binanggit na direksyon para sa pag-scale sa 4K o 8K ay ang muling pagdisenyo ng mga DiT–VAE foundation model na likas na sumusuporta sa mga resolution na iyon, dahil mas angkop ang umiiral na FLUX backbone sa mga input na humigit-kumulang 1K–2K. Mga limitasyon at direksyong pananaliksik pa lamang ang mga ito, hindi mga inilabas na high-resolution capability. Papel, mga limitasyon.
Mga Madalas Itanong
Kailangan ko ba ng 3D mesh bago gamitin ang UltraTex?
Oo. Tine-texture ng UltraTex ang umiiral na geometry gamit ang isang reference image at mga normal view na hinango mula sa mesh. Umaangkop ito sa yugto ng appearance pagkatapos ng pagmomodelo o pagbuo ng geometry; hindi nito nire-reconstruct ang isang kumpletong mesh mula lamang sa reference image. [Source](https://arxiv.org/html/2609.23169v1#S3).
Direkta bang naghahatid ang inference ng isang kumpletong PBR asset?
Ang mga inilabas na script ay nagsa-save ng mga multi-view na larawan, na kailangan pa ring i-reproject o i-bake sa mesh. Ang albedo ang default na output; gumagamit ang FLUX.2 metallic–roughness extension ng magkakahiwalay na weights. Hindi dapat ipagkamali ang extension na iyon sa pangunahing pagsusuri ng albedo ng paper. [Source](https://github.com/yiboz2001/UltraTex#inference).
Makikinabang ba ang bawat asset sa iniulat na pagbilis?
Hindi. Ang iniulat na pagpapabilis ay sinukat sa isang H200 laban sa isang dense baseline sa ilalim ng tinukoy na foreground occupancy at mga setting ng attention-retention. Nakaaapekto sa natitipid ang object coverage, hardware at configuration; hindi ginagarantiyahan ng mga bilang ang katumbas na speedup para sa iyong kumpletong asset pipeline. [Source](https://arxiv.org/html/2609.23169v1#S4).


