SeMo3D: Pinag-iisa ang Paglikha, Pag-edit, at Pagkumpleto ng 3D sa Pamamagitan ng Selective Modeling
Ipinapakilala ng SeMo3D ang isang pinag-isang paraan para sa pagbuo ng 3D, lokal na pag-edit, at pagkumpleto gamit ang piling pagmomodelo.

Mga Pangunahing Tampok at Resulta: Baguhin ang Mahalaga
Orihinal na papel: SeMo3D: Pinag-iisa ang 3D Generation, Editing, at Completion sa Pamamagitan ng Selective Modeling
Ang SeMo3D, na ipinakilala ng mga mananaliksik sa Nanjing University, ay pinagsasama ang 3D generation, local editing, at completion sa iisang framework. Para sa mga team na nagsasaliksik sa paglikha ng AI asset, ang pangunahing pangako nito ay continuity: lumikha ng isang object, baguhin ang napiling rehiyon, o buuin muli ang nawawalang bahagi habang pinananatili ang umiiral na konteksto. Ang pangalan ay nangangahulugang Selective Modeling, isang estratehiyang ginagawa ang rehiyong isi-synthesize bilang karaniwang interface ng mga gawaing ito. Opisyal na repository.
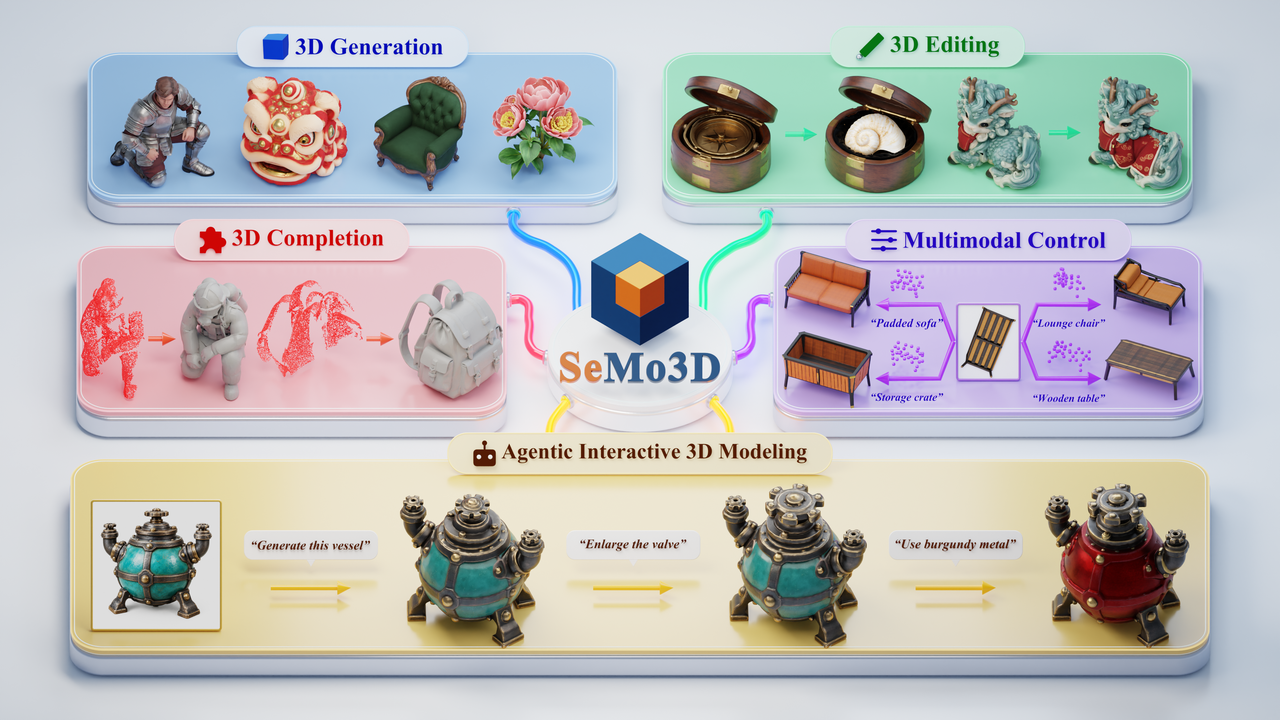
Sa Toys4K, iniulat ng mga may-akda ang geometric Chamfer Distance na 0.0118 kumpara sa 0.0330 ng TRELLIS.2 (mas mababa ang mas mainam). Ang preservation sa editing ay umabot sa 37.39 dB PSNR kumpara sa 31.55 dB ng VoxHammer. Ang F-score sa completion ay umabot sa 0.541 kumpara sa 0.412 ng HY3D-Omni gamit ang karagdagang point guidance. Nagkakaiba ang mga sinusuportahang input sa bawat method, at nagmumula sa ground truth ang mga point hint; hindi inihihiwalay ng mga paghahambing na ito ang mga pakinabang ng arkitektura. Papel, Mga Talahanayan 1–3.
Paano Ito Gumagana: Pumili, I-synthesize, Panatilihin
Hinahati ng pangunahing abstraction ang isang asset sa napiling rehiyon na S at pinanatiling konteksto na C. Pinipili ng generation ang lahat; pinipili ng editing ang target; pinipili ng completion ang nawawala. Para sa isang silya, maaaring gamitin ng parehong interface ang paglikha ng buong silya, pagpapalit ng sandalan nito, o muling pagbuo ng nawawalang paa. Mga halimbawang paggamit lamang ito ng depinisyon ng gawain. Natututo ang modelo ng isang pinagsasaluhang problema sa regional synthesis sa halip na mangailangan ng hiwalay na recipe ng training para sa bawat gawain. Pangkalahatang-ideya ng repository.
Pino-fine-tune ng SeMo3D ang tatlong flow model ng TRELLIS.2 sa Trellis-500K at muling ginagamit ang SC-VAE nito. Hinuhulaan ng sparse structure ang occupancy sa isang 16³ latent grid; gumagana ang shape at texture sa mga occupied position sa isang 32³ grid, na lumilikha ng geometry at mga PBR material. Inililipat ang mask sa pagitan ng mga stage. Kaya, kahit pinag-iisa ang mga gawain, gumagamit pa rin ito ng tatlong model na partikular sa stage. Papel, mga detalye ng method at training.
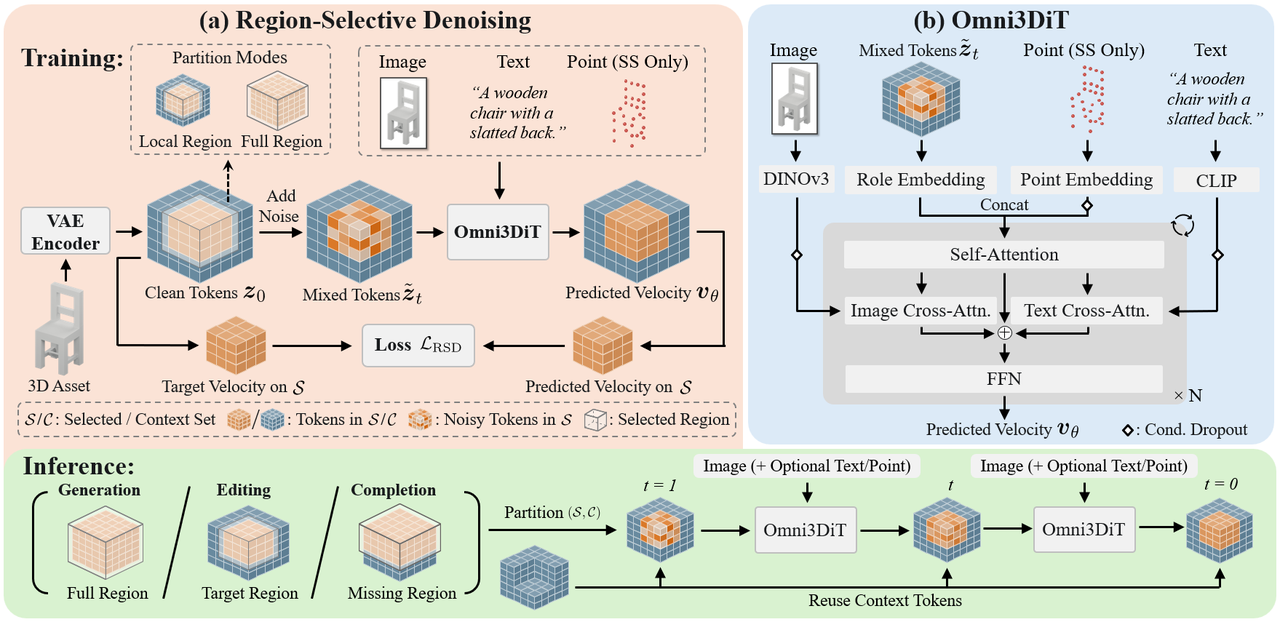
Lumilikha ang region-selective denoising ng mga halimbawa ng training mula sa karaniwang mga asset. Tumatanggap ng noise ang isang random na rehiyon habang nananatiling malinis ang paligid nito; mga prediction lamang sa rehiyong iyon ang nakaaambag sa loss. Sumasaklaw ang training mula sa mga lokal na box hanggang sa kumpletong asset, kaya hindi kailangan ang magkapares na dataset ng before-and-after editing o completion. Sa inference, nagsisimula sa noise ang mga napiling token at umuunlad sa ilalim ng guidance, habang muling ginagamit ang mga token ng orihinal na konteksto sa bawat step. Kaya maaaring sumangguni ang modelo sa buong object nang hindi ito muling sini-synthesize nang buo. Opisyal na paliwanag sa method.
Ginagawang mauunawaan ng Omni3DiT ang mixed input na ito. Tinutukoy ng role embedding ang mga napili at kontekstong token. Nag-iinject ang magkaparis na cross-attention branch ng mga feature ng DINOv3 image at mga feature ng CLIP text; pumapasok ang mga point token sa self-attention sa sparse-structure stage. Ginagabayan ng mga image ang appearance, nagdaragdag ang text ng semantic intent, at nililimitahan ng mga point ang spatial layout. Binabago ng condition dropout ang available na guidance habang nagta-training, na hinihikayat ang modelo na gamitin ang magkakomplementaryong signal. Opisyal na diagram ng arkitektura.
Nananatiling mandatory ang isang image. Gumagamit ang generation ng 12 Euler step bawat stage; gumagamit ang editing/completion ng 50 para sa structure at 12 para sa shape at texture. Nalalapat ang mahigpit na preservation sa latent token, hindi kinakailangan sa bawat decoded vertex. Papel at appendix ng inference.
Mga Application at Mga Susunod na Hakbang
Ang praktikal na oportunidad ay iterative na paggawa: pagsubok ng mga variant ng prop, pagkukumpuni ng mga hindi kumpletong reference, at pagpipino ng mga asset sa pamamagitan ng magkakasunod na instruction. Ipinakikita rin ng opisyal na proyekto ang mga agent workflow na naghahanda ng mga reference image, tumutukoy sa mga rehiyon para sa editing, at tumatawag sa SeMo3D. Nagmumungkahi ito ng kapaki-pakinabang na paghahati ng gawain: isinasalin ng isang agent ang intensyon sa isang modeling request, habang hinahawakan ng 3D model ang regional synthesis. Mga interactive na demonstration ng proyekto.
Nananatiling limitado ang kahandaan nito. Sa pagsusuri noong Nobyembre 6, 2026, ang opisyal na repository ay naglalaman ng dokumentasyon at mga demonstration asset; hindi pa inilalabas ang mga weight at ang code para sa training, inference, at evaluation. Hindi itinatakda ng lisensyang MIT nito ang mga tuntunin sa paglilisensya para sa mga weight sa hinaharap. Sinusuri ng artikulong ito ang papel at available na repository, nang hindi inaangkin ang isang independiyenteng reproduction. Checklist ng release.
Tinutukoy ng mga may-akda ang dalawang direksiyon ng pananaliksik. Maaaring mas mahusay na makuha ng mga 3D representation na mas mataas ang fidelity ang mga manipis na structure gaya ng dahon ng palma, na nahihirapang resolbahin ng kasalukuyang structured latent. Maaaring mapahusay ng mas malalakas na vision-language encoder ang pag-unawa sa mga kumplikadong compositional prompt; ipinakikita ng papel na nagiging orange texture ang mga orange fruit sa halip na magkakahiwalay na object. Mga Limitasyon at Gawain sa Hinaharap. Ang natitirang release milestone ng proyekto ay mga model weight sa Hugging Face at kumpletong inference, training, at evaluation code. Opisyal na TODO list.
Mga Madalas Itanong
Maaari bang bumuo o mag-edit ang SeMo3D ng asset mula sa teksto lamang?
Hindi. Kinakailangan ng papel ang paggabay sa larawan; opsyonal na karagdagang kondisyon lamang ang teksto at kakaunting punto. Nangangailangan din ang pag-edit ng napiling rehiyon at konteksto ng pinagmulan. Kasama sa mga demonstrasyon ng ahenteng gumagamit ng natural na wika ang paghahanda ng larawan sa halip na alisin ang kinakailangan sa larawan. [Pinagmulan](https://arxiv.org/html/2611.02568v1#S3.SS2).
Maaari ko bang palitan ang sandalan ng upuan nang hindi pinapalitan ang iba pang bahagi?
Ipinapakita nito ang nilalayong daloy ng lokal na pag-edit: piliin ang rehiyon ng sandalan, magbigay ng gabay, at buuin ang mga token nito habang muling ginagamit ang mga token ng konteksto. Nalalapat ang eksaktong pagpapanatili sa mga latent na token; hindi ito dapat ituring na garantiya na mananatiling eksaktong magkapareho ang bawat nadecod na vertex. [Pinagmulan](https://arxiv.org/html/2611.02568v1#S3.SS3).
Maaari ko na bang i-deploy ang SeMo3D nang lokal?
Batay sa pagsusuri noong Nobyembre 6, 2026, nananatiling hindi pa namamarkahang mga milestone ng release ang mga weight ng modelo at kumpletong code para sa inference, training at pagsusuri. Sinusuportahan ng pampublikong paper at mga demonstration ang teknikal na pagsusuri, ngunit hindi pa ibinibigay ng repository ang kumpletong stack para sa lokal na deployment. [Pinagmulan](https://github.com/XiaokunSun/SeMo3D#-todo).




