Frontier3DBench: Pag-benchmark sa mga Coding Agent para sa 3D na Paglikha sa Iba't ibang Bagay, Eksena & Bukas na Mundo
Sinusuri ng Frontier3DBench ang kakayahan ng mga coding agent na lumikha ng nae-edit at naipapatupad na mga 3D proyekto sa mga object, scene, at interactive na open world.
Orihinal na papel: Frontier3DBench: Benchmarking sa mga Coding Agent para sa 3D Creation sa iba’t ibang Object, Scene, at Interactive Open World (Nobyembre 6, 2026; v1).
Mga Pangunahing Punto at Resulta
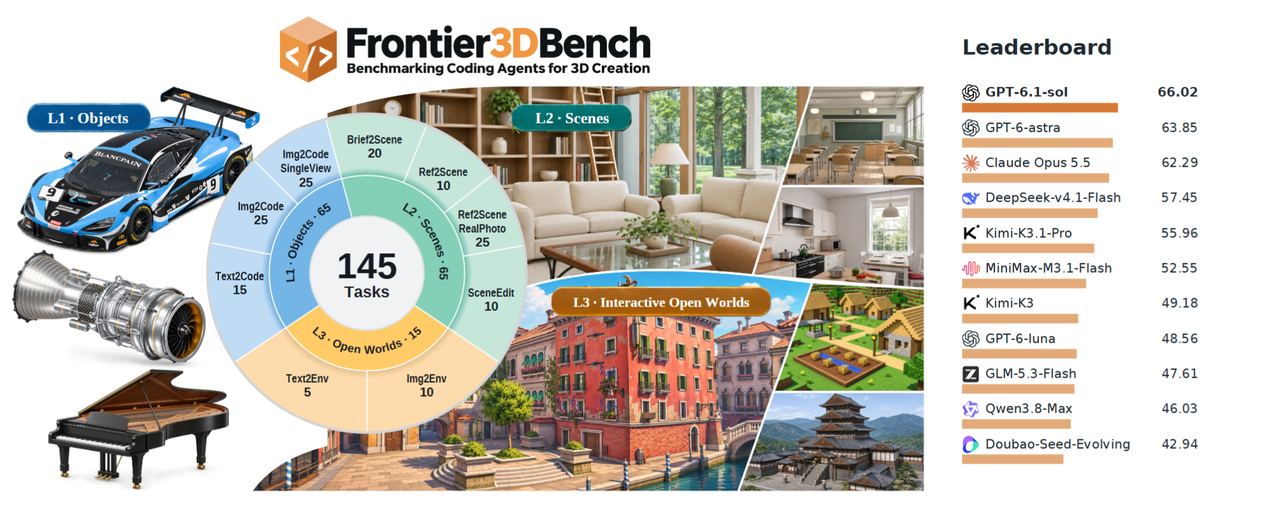
Sinusuri ng Frontier3DBench kung makagagawa ang mga coding agent ng nae-edit at naipapatupad na mga 3D project sa mga object, scene, at interactive world. Para sa mga team na pumipili ng AI authoring workflow, ang ambag nito ay isang karaniwang evaluation framework: 145 task sa siyam na pamilya, kabilang ang 65 Blender object task, 65 Blender scene task, at 15 Unreal Engine world task. Kabilang sa mga input ang mga instruction, reference image, litrato, at mga kasalukuyang scene.
Sinusuri ng mga may-akda ang 11 configuration ng model–harness. Nangunguna sa kabuuan ang GPT-6.1-sol gamit ang Codex sa 66.02/100; nangunguna naman sa interactive world ang GPT-6-astra gamit ang Codex sa 61.28. Mas mahina ang performance ng bawat configuration sa reference reconstruction kaysa sa text-driven object at scene generation. Sa 165 world submission, ang mga local mechanism ay may average na 83.08, ang clearance ng moving part ay 20.82, at ang stateful workflow ay 30.26. Component score ang mga ito, hindi porsyento ng mga world na matagumpay na nakumpleto.
Nagbibigay ang human study ng limitadong calibration: niraranggo ng walong rater ang apat na candidate sa bawat isa sa 45 reference-conditioned object/scene item. Nakamit ng automatic score ang mean Kendall tau-b na 0.727 at 79.2% na pagkakasundo sa nanalo, ngunit 44.7% lamang na pagkakasundo sa kumpletong ranking. Hindi nito nabe-validate ang bawat task family o world behavior. Tingnan ang mga eksperimento.
Paano Gumagana ang Evaluation
Tumatanggap ang agent ng task contract: kinakailangang geometry at appearance, mga reference image kung naaangkop, at mga paunang asset para sa pag-edit. Dagdag na tinutukoy ng world task ang mga entity, panimulang state, pinapahintulutang operation, at prerequisite. Nagsusulat at nagpapatupad ang agent ng construction code, pagkatapos ay nagsusumite ng native Blender o Unreal project kasama ang mga kinakailangang export. Nanatili sa labas ng workspace nito ang mga evaluation file.
Sa inilabas na orchestrator, maaaring mag-trigger ng repair ang mga public execution check, ngunit mga error, hindi private score, ang natatanggap ng agent. Naka-freeze at naka-hash ang tinanggap na source bago ang evaluation. Muling pinapatakbo ng magkakahiwalay na evaluator ang program, sinusuri ang native geometry, nagre-render ng mga view, at hinuhusgahan ang pagtupad sa task. Ginagamit ng papel ang Blender 5.2.1 at Unreal Engine 5.8.3; pinapayagan ng L1/L2 generation ang hanggang anim na attempt sa loob ng 32 oras. Mga ceiling ito sa budget, hindi mga nasukat na completion time.
Nagbabago ang scoring depende sa task. Pinagsasama ng reference reconstruction ang 50% image similarity, 20% projected object localization, 20% visual judgment, at 10% detail. Sinusukat ng image similarity ang structure, edge, kulay, at tono; itinatapat ng localization ang mga object box at pinaparusahan ang nawawala o sobrang instance. Hinuhusgahan ng GPT-6-astra sa medium effort ang mga fixed visual criterion nang nakatago ang identity ng generator. Gumagamit ang detail check ng coverage na pinarami ng isa bawas deviation, pagkatapos ay kinukuha ang pinakamahinang kinakailangang execution/export variant. Sinusuri ng karaniwang L1 task ang apat na execution sa native at GLB form; gumagamit ang L2 ng apat na native variant.
Hiwalay na sinusukat ng scene editing ang hinihiling na modification at ang pagpapanatili ng mga protektadong paligid. Binubuo muli ng world evaluation ang isinumiteng project gamit ang independent observer at sinusuri ang nakikitang epekto ng action, mga intersection ng moving part, aktuwal na paggalaw ng character, at persistent state. Ipinagbabawal ng continuous workflow ang teleportation at reset. Kaya hindi maaaring ipalit ang pagbukas ng pinto nang mag-isa sa pagkumpleto ng route na nangangailangan ng pagpunta rito, pag-unlock dito, at pagdaan dito.
Tinitimbang ng world score ang visual quality, task fidelity, layout, at interaction sa 60/20/5/15. Tinitimbang naman ng final benchmark total ang L1/L2/L3 sa 30/30/40. Tinutukoy ng scoring contract ang pagkakaiba ng kumpirmadong defect ng candidate at nawawalang technical evidence: hindi dapat awtomatikong maging zero ang isang API o measurement failure.
Mga Gamit at Bukás na Hamon
Sinusuportahan ng benchmark ang pagpili ng mga coding-agent workflow at pagtukoy kung ang mga failure ay may kaugnayan sa appearance, geometry, editing, o behavior. Kasama sa open repository nito ang mga task input, generation/evaluation code, at scoring contract; gumagamit ang benchmark software ng Apache-2.0, habang pinapanatili ng mga task asset ang sarili nilang lisensya. Nangangailangan ng hiwalay na setup ang Blender, Unreal Engine, at access sa model.
Tinutukoy ng papel ang dalawang pangunahing bukás na hamon: pagtutugma sa itinakdang geometry at layout, at pagko-coordinate ng mga moving part, action, at persistent state. Mga direksiyon ito ng pananaliksik ng mga may-akda, hindi mga inanunsiyang feature ng produkto. Inilalarawan ng mga paghahambing ang kumpletong model–harness setup, at nananatili ang mga limitasyon ng calibration sa visual judging; wala rin ang mga photographic task ng unibersal na native 3D ground truth. Binasa ng review na ito ang papel at implementation ngunit hindi muling pinatakbo ang benchmark.
Mga Madalas Itanong
Ang Frontier3DBench ba mismo ay isang modelo para sa pagbuo ng 3D?
Hindi. Nagbibigay ito ng mga gawain at evaluator para sa mga coding agent na bumubuo ng mga proyekto sa Blender at Unreal. Hindi ito nagpapakilala ng sinanay na mesh generator o bagong 3D latent representation.
Bakit hindi sapat ang mga screenshot para sa pagsusumite?
Hinihingi ng kontrata ang mga nae-edit na native artifact at naipapatupad na gawi. Sinusuri ng mga evaluator ang geometry, muling nire-render ang mga naka-save na eksena, at sinusubukan ang mga interaksyon, kaya hindi sapat ang hitsura lamang upang mapatunayan ang kawastuhan.
Natutukoy ba ng pinakamataas na kabuuang iskor ang pinakamahusay na ahente para sa bawat trabaho?
Hindi. Nagkakaiba ang mga nangunguna ayon sa pamilya ng gawain, at kasama sa puntos ang harness at configuration ng pangangatwiran. Ihambing ang nauugnay na profile ng gawain bago pumili ng workflow.




