UltraTex: ปลดปล่อยพลังของ 2K Multi-View Diffusion สำหรับการสร้างพื้นผิว 3D
UltraTex เป็นโครงการ SIGGRAPH Asia 2026 ที่ใช้ประโยชน์จากโมเดล diffusion แบบหลายมุมมองเพื่อสร้างเท็กซ์เจอร์ความละเอียดสูง (2K) สำหรับเมช 3D จากภาพอ้างอิง เพื่อแก้ไขข้อจำกัดของความละเอียดที่ต่ำกว่า เช่น 512 หรือ 768

ไฮไลต์และผลลัพธ์: รายละเอียดมากขึ้น คอมพิวต์สูญเปล่าน้อยลง
บทความต้นฉบับ: UltraTex: Unleashing 2K Multi-View Diffusion for 3D Texturing
UltraTex สร้างพื้นผิวที่มีรายละเอียดสำหรับเมช 3D ที่มีอยู่โดยใช้ภาพอ้างอิง โปรเจกต์นี้นำเสนอในงาน SIGGRAPH Asia 2026 และมุ่งแก้ปัญหาคอขวดที่พบได้ทั่วไป: การสร้างพื้นผิวหลายมุมมองที่ความละเอียด 512 หรือ 768 สูญเสียลวดลายละเอียดและรายละเอียดพื้นผิว UltraTex เพิ่มมุมมองที่สร้างขึ้นเป็น 2048 × 2048 โดยมุ่งการคำนวณไปยังส่วนหน้าเบื้องหน้าของวัตถุ ผลงานสำคัญคือการทำให้ diffusion หลายมุมมองความละเอียดสูงใช้งานได้จริงผ่านการปรับเปลี่ยนกระบวนการประมวลผลโทเค็น, attention และการถอดรหัสอย่างประสานกัน โปรเจกต์อย่างเป็นทางการ.
จากวัตถุ TexVerse ที่กันไว้ทดสอบ 100 รายการ UltraTex รายงานค่า unshaded LPIPS เท่ากับ 0.082 เทียบกับ 0.138 ของ LumiTex โดยค่าที่ต่ำกว่าหมายถึงความสอดคล้องเชิงการรับรู้ที่ใกล้เคียงกว่า เมื่อใช้ H200 เพียงเครื่องเดียว ผู้เขียนรายงานว่าได้ ความเร็วในการฝึกเพิ่มขึ้น 20.6–91.1 เท่า และความเร็วในการอนุมานเพิ่มขึ้น 22.3–74.6 เท่า เมื่อเทียบกับ baseline แบบหนาแน่น สำหรับการครอบคลุมส่วนหน้าเบื้องหน้า 10–30% และการคงบล็อก attention ไว้ 20% ผลลัพธ์เหล่านี้ขึ้นอยู่กับการกำหนดค่า ไม่ใช่ค่าการเร่งความเร็วคงที่สำหรับแอสเซ็ตทุกประเภทหรือเวิร์กโฟลว์การผลิตที่สมบูรณ์ บทความ, การทดลอง.
วิธีการทำงาน: จากภาพอ้างอิงสู่พื้นผิวที่มีเท็กซ์เจอร์
ไปป์ไลน์จะเรนเดอร์ normal map หกชุดจากเมชอินพุตก่อน ได้แก่ มุมมองด้านข้างสี่ชุด มุมมองด้านบนหนึ่งชุด และมุมมองด้านล่างหนึ่งชุด VAE จะเข้ารหัสคำแนะนำด้านเรขาคณิตและภาพอ้างอิงเป็น latent จากนั้น transformer สำหรับ diffusion ของ FLUX ที่ผ่านการฝึกไว้ล่วงหน้าจะสร้างมุมมองพื้นผิวที่สอดคล้องกันหกชุดผ่าน flow matching และไปป์ไลน์ฉบับเต็มของบทความจะนำมุมมองเหล่านั้นมา reproject ลงบนเมช ที่ระดับ 2K มุมมองเป้าหมายหกชุด มุมมองเรขาคณิตหกชุด และภาพอ้างอิงหนึ่งภาพ รวมกันเป็น โทเค็นภาพ 212,992 โทเค็น ซึ่งอธิบายได้ว่าทำไมการประมวลผลแบบหนาแน่นจึงมีค่าใช้จ่ายสูง ไปป์ไลน์; คำอธิบายต้นทุนโทเค็น.
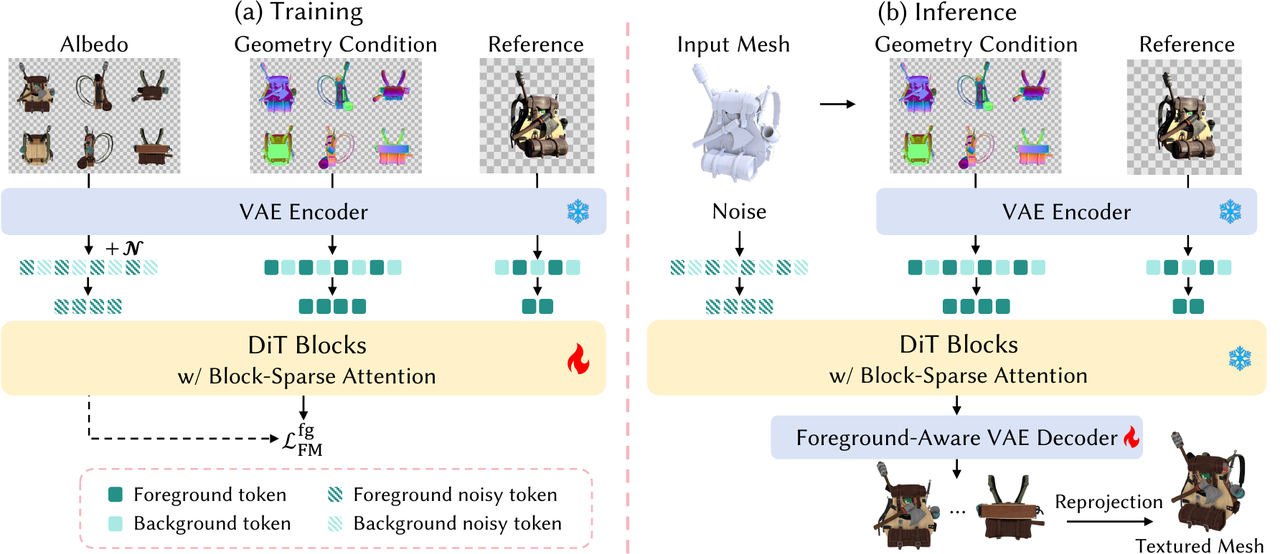
Background Token Dropping จะลบโทเค็นภาพที่อยู่นอกวัตถุก่อนเข้าสู่บล็อก transformer มาสก์จะระบุตำแหน่งที่คงไว้ ขณะที่ positional embedding แบบ rotary (RoPE) ดั้งเดิมที่สอดคล้องกันยังคงถูกแนบอยู่ ลำดับจึงสั้นลงโดยไม่สูญเสียพิกัดเชิงพื้นที่ วิธีนี้ช่วยลดงานตลอดทั้ง backbone รวมถึงเลเยอร์ feed-forward ใน sampler ที่เผยแพร่ การอัปเดตแบบ Euler จะปรับเฉพาะตำแหน่งส่วนหน้าเบื้องหน้าที่เลือกไว้ ส่วน noise พื้นหลังจะไม่ถูกแตะต้องจนกว่าจะเตรียมการถอดรหัส การเลือกโทเค็น; การใช้งาน sampling.
Block-Sparse Attention ลดต้นทุนของปฏิสัมพันธ์ระหว่างโทเค็นที่เหลือ การใช้งานจะหาค่าเฉลี่ยฟีเจอร์ query และ key ภายในแต่ละบล็อก ประเมินความเกี่ยวข้อง แล้วเลือกบล็อก key ที่มีคะแนนสูงสุดสำหรับแต่ละบล็อก query จากนั้น attention จะใช้ฟีเจอร์โทเค็นดั้งเดิมภายในบล็อกที่เลือก การกำหนดค่า FLUX.1 จะคงบล็อก key ไว้ 20% ซึ่งหลีกเลี่ยงปฏิสัมพันธ์จำนวนมากโดยไม่ลดความละเอียดของภาพ การเลือกบล็อก; การกำหนดค่า attention.
Foreground-Aware VAE Decoding จัดการกับผลที่ตามมาจากการข้ามการลด noise ของพื้นหลัง การรวมส่วนหน้าเบื้องหน้าที่สะอาดเข้ากับพื้นหลังที่มี noise อาจทำให้การสร้างกลับคืนเสียหาย UltraTex แทนที่พื้นหลังด้วย latent ที่เข้ารหัสจากภาพสีดำทึบ จากนั้นใช้ decoder ที่ปรับให้เหมาะกับข้อมูลผสมนี้ encoder ยังคงถูกตรึงไว้ ส่วนการฝึก decoder จะลดข้อผิดพลาดในการสร้างกลับคืนเฉพาะบนพิกเซลส่วนหน้าเบื้องหน้า หลังการถอดรหัส สคริปต์อนุมานที่เผยแพร่จะบันทึกภาพหลายมุมมอง การนำเอาต์พุตเหล่านั้นไปผนวกรวมกับแอสเซ็ตเมชยังคงต้องใช้ขั้นตอน reproject หรือ baking การฝึก decoder; เอาต์พุตการอนุมาน.
รากฐานข้อมูลคือ G-buffer TexVerse รีลีสสาธารณะครอบคลุมแอสเซ็ต BSDF จำนวน 351,847 รายการ ขณะที่ UltraTex ใช้ชุดย่อยสำหรับฝึกที่ผ่านการกรองจำนวน 268,365 แอสเซ็ต การเรนเดอร์มี normal, พิกัด, albedo และแชนเนลวัสดุที่มีอยู่ โดยมีความละเอียดสูงสุด 4096 × 4096 ควรแยกความแตกต่างระหว่างความละเอียดข้อมูลนี้กับการสร้าง 2K ที่ UltraTex สาธิต คำอธิบายชุดข้อมูล.
แอปพลิเคชัน ความพร้อมใช้งาน และทิศทางในอนาคต
UltraTex มุ่งเน้นขั้นตอนด้านรูปลักษณ์ของการสร้างแอสเซ็ต: การจัดเตรียมพื้นผิวที่มีรายละเอียดสำหรับเรขาคณิตของตัวละคร พร็อพ และวัตถุที่มีอยู่ เอาต์พุตเริ่มต้นคือ albedo ซึ่งแสดงสีพื้นผิวโดยไม่มีแสงที่อบไว้ในพื้นผิว รีโพซิทอรีปัจจุบันยังมีสาขา metallic–roughness ของ FLUX.2 พร้อมน้ำหนัก LoRA แยกต่างหาก ควรแยกส่วนขยายที่มีอยู่นี้ออกจาก benchmark albedo หลักของบทความ ซึ่งเรนเดอร์ UltraTex ด้วยค่า roughness และ metallic ที่กำหนดตายตัว เอาต์พุตวัสดุที่มีให้ใช้งาน; การตั้งค่าการประเมิน.
ณ วันที่ตรวจสอบคือ 6 พฤศจิกายน 2026 โค้ดการฝึกและการอนุมาน รวมถึงคำแนะนำในการดาวน์โหลดน้ำหนัก เปิดเผยต่อสาธารณะแล้ว รีโพซิทอรีรองรับรุ่น FLUX.1-dev และ FLUX.2-Klein โดยแต่ละรุ่นต้องใช้ไฟล์ backbone, LoRA และ decoder ที่ตรงกัน สภาพแวดล้อมที่ทดสอบใช้ Python 3.12, CUDA 12.4 และ PyTorch 2.5.1 บทความนี้ทบทวนบทความวิจัยและการใช้งาน ไม่ได้อ้างว่าเป็นการทำซ้ำคุณภาพหรือความเร็วโดยอิสระ รีโพซิทอรีอย่างเป็นทางการ.
ผู้เขียนระบุถึงความยากลำบากกับพื้นผิวที่ซ้ำกันมาก และการสูญเสียรายละเอียดจากการแทนค่าแบบบีบอัดของ VAE ที่ผ่านการฝึกไว้ล่วงหน้า ทิศทางที่ระบุไว้สำหรับการขยายไปยัง 4K หรือ 8K คือการออกแบบโมเดล foundation ของ DiT–VAE ใหม่ที่รองรับความละเอียดเหล่านั้นโดยกำเนิด เนื่องจาก backbone ของ FLUX ที่มีอยู่เหมาะกับอินพุตราว 1K–2K มากกว่า สิ่งเหล่านี้ยังคงเป็นข้อจำกัดและทิศทางการวิจัย ไม่ใช่ความสามารถความละเอียดสูงที่เผยแพร่แล้ว บทความ, ข้อจำกัด.
คำถามที่พบบ่อย
ฉันจำเป็นต้องมีเมช 3D ก่อนใช้ UltraTex หรือไม่
ใช่ UltraTex สร้างเท็กซ์เจอร์ให้กับเรขาคณิตที่มีอยู่โดยใช้ภาพอ้างอิงและมุมมองนอร์มัลที่ได้จากเมช โดยเหมาะกับขั้นตอนการสร้างรูปลักษณ์หลังการทำโมเดลหรือการสร้างเรขาคณิต และไม่ได้สร้างเมชที่สมบูรณ์ขึ้นใหม่จากภาพอ้างอิงเพียงอย่างเดียว [แหล่งที่มา](https://arxiv.org/html/2609.23169v1#S3).
การอนุมานให้แอสเซ็ต PBR ที่เสร็จสมบูรณ์โดยตรงหรือไม่?
สคริปต์ที่เผยแพร่จะบันทึกภาพหลายมุมมอง ซึ่งยังต้องทำรีโปรเจกชันหรือเบกลงบนเมช Albedo คือเอาต์พุตเริ่มต้น ส่วนส่วนขยาย metallic–roughness ของ FLUX.2 จะใช้น้ำหนักแยกกัน ไม่ควรสับสนส่วนขยายนี้กับการประเมิน albedo หลักของบทความ [Source](https://github.com/yiboz2001/UltraTex#inference)
สินทรัพย์ทุกชิ้นจะได้รับการเพิ่มความเร็วตามที่รายงานไว้หรือไม่
ไม่ อัตราเร่งที่รายงานวัดบน H200 เทียบกับ baseline แบบ dense ภายใต้การตั้งค่าการครอบครองพื้นที่เบื้องหน้าและการคงความสนใจตามที่ระบุ การครอบคลุมของวัตถุ ฮาร์ดแวร์ และการกำหนดค่าล้วนส่งผลต่อการประหยัด ตัวเลขเหล่านี้ไม่รับประกันว่าจะได้อัตราเร่งที่เทียบเท่ากันสำหรับไปป์ไลน์สินทรัพย์ทั้งหมดของคุณ [แหล่งที่มา](https://arxiv.org/html/2609.23169v1#S4).


