SeMo3D: การรวมการสร้าง การแก้ไข และการเติมเต็ม 3D ให้เป็นหนึ่งเดียวผ่านการสร้างแบบจำลองแบบเลือกสรร
SeMo3D นำเสนอแนวทางแบบเป็นหนึ่งเดียวสำหรับการสร้าง 3D การแก้ไขเฉพาะจุด และการเติมเต็มโดยใช้การสร้างแบบจำลองแบบเลือกเฉพาะส่วน

ประเด็นสำคัญและผลลัพธ์: เปลี่ยนแปลงสิ่งที่สำคัญ
บทความต้นฉบับ: SeMo3D: รวมการสร้าง 3D การแก้ไข และการเติมส่วนที่ขาดให้เป็นหนึ่งเดียวผ่านการสร้างแบบเลือกเฉพาะ
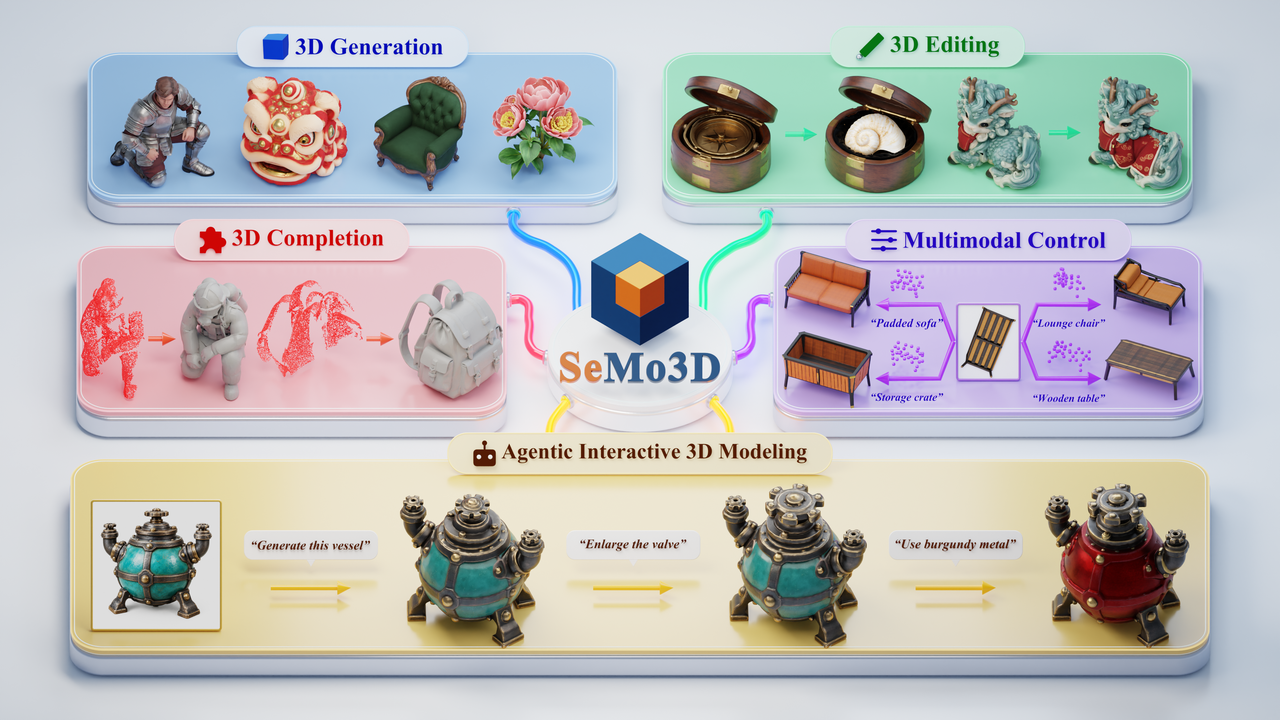
SeMo3D ซึ่งเปิดตัวโดยนักวิจัยจากมหาวิทยาลัยหนานจิง นำ การสร้าง 3D การแก้ไขเฉพาะส่วน และการเติมส่วนที่ขาดให้เป็นกรอบการทำงานเดียวกัน สำหรับทีมที่กำลังสำรวจการสร้างแอสเซ็ตด้วย AI จุดเด่นสำคัญคือความต่อเนื่อง: สร้างวัตถุ แก้ไขบริเวณที่เลือก หรือสร้างส่วนที่หายไปขึ้นใหม่โดยยังคงบริบทเดิมไว้ ชื่อนี้มาจาก Selective Modeling ซึ่งเป็นกลยุทธ์ที่ทำให้บริเวณที่จะสังเคราะห์เป็นอินเทอร์เฟซร่วมระหว่างงานเหล่านี้ คลังโค้ดอย่างเป็นทางการ
บน Toys4K ผู้เขียนรายงานค่า Chamfer Distance ด้านเรขาคณิตที่ 0.0118 เทียบกับ 0.0330 ของ TRELLIS.2 (ค่ายิ่งต่ำยิ่งดี) การคงสภาพหลังการแก้ไขทำได้ถึง 37.39 dB PSNR เทียบกับ 31.55 dB ของ VoxHammer ส่วนค่า F-score ของการเติมส่วนที่ขาดอยู่ที่ 0.541 เทียบกับ 0.412 ของ HY3D-Omni เมื่อมีคำแนะนำจากจุดเพิ่มเติม อินพุตที่รองรับแตกต่างกันในแต่ละวิธี และคำใบ้จากจุดมาจาก ground truth ดังนั้นการเปรียบเทียบเหล่านี้จึงไม่ได้แยกผลได้เฉพาะจากสถาปัตยกรรม บทความ ตารางที่ 1–3
วิธีการทำงาน: เลือก สังเคราะห์ คงสภาพ
แนวคิดหลักแบ่งแอสเซ็ตออกเป็นบริเวณที่เลือก S และบริบทที่คงไว้ C การสร้างจะเลือกทุกส่วน การแก้ไขจะเลือกเป้าหมาย และการเติมส่วนที่ขาดจะเลือกบริเวณที่หายไป สำหรับเก้าอี้ อินเทอร์เฟซเดียวกันนี้อาจใช้สร้างเก้าอี้ทั้งตัว เปลี่ยนพนักพิง หรือสร้างขาที่หายไปขึ้นใหม่ ตัวอย่างเหล่านี้เป็นการใช้งานเพื่ออธิบายคำนิยามของงาน โมเดลเรียนรู้ปัญหาการสังเคราะห์ระดับภูมิภาคร่วมกัน แทนที่จะต้องใช้สูตรการฝึกเฉพาะงานแยกกัน ภาพรวมคลังโค้ด
SeMo3D ปรับจูน โฟลว์โมเดลสามตัวของ TRELLIS.2 บน Trellis-500K และนำ SC-VAE ของโมเดลเดิมกลับมาใช้ โครงสร้างแบบเบาบางจะทำนายการมีอยู่ของวัตถุบน กริด latent ขนาด 16³ ส่วนรูปร่างและพื้นผิวทำงานที่ตำแหน่งซึ่งมีวัตถุอยู่ใน กริดขนาด 32³ เพื่อสร้างเรขาคณิตและวัสดุ PBR มาสก์จะถูกส่งต่อระหว่างแต่ละขั้น ดังนั้น แม้จะรวมงานต่าง ๆ ไว้เป็นหนึ่งเดียว แต่ก็ยังใช้โมเดลเฉพาะสามขั้น บทความ รายละเอียดวิธีการและการฝึก
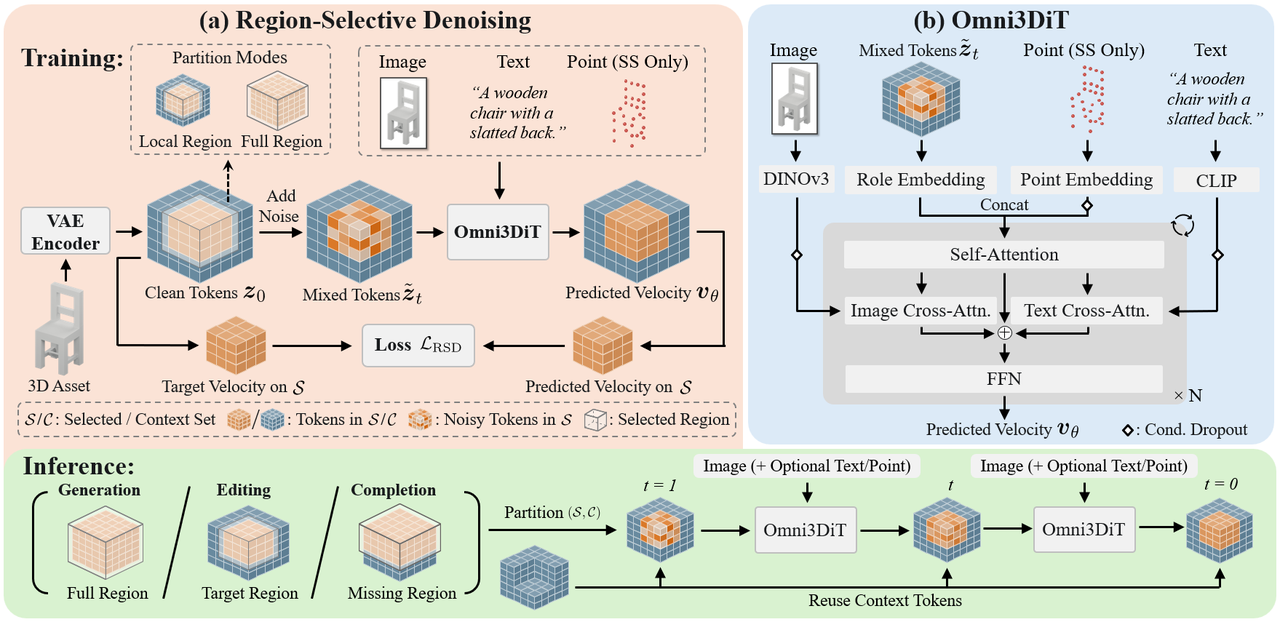
การลดสัญญาณรบกวนแบบเลือกเฉพาะภูมิภาค สร้างตัวอย่างฝึกจากแอสเซ็ตทั่วไป บริเวณแบบสุ่มจะได้รับสัญญาณรบกวน ขณะที่บริเวณโดยรอบยังคงสะอาด และมีเพียงการทำนายในบริเวณนั้นที่นำไปคำนวณ loss การฝึกครอบคลุมตั้งแต่กรอบเฉพาะส่วนไปจนถึงแอสเซ็ตทั้งชิ้น จึงไม่ต้องใช้ชุดข้อมูลการแก้ไขหรือการเติมส่วนที่ขาดแบบจับคู่ก่อนและหลัง ขณะอนุมาน โทเค็นที่เลือกจะเริ่มจากสัญญาณรบกวนและค่อย ๆ เปลี่ยนแปลงภายใต้ guidance ขณะที่โทเค็นบริบทเดิมถูกนำกลับมาใช้ในทุกขั้น โมเดลจึงสามารถอ้างอิงวัตถุทั้งชิ้นได้โดยไม่ต้องสังเคราะห์ทั้งหมดใหม่ คำอธิบายวิธีการอย่างเป็นทางการ
Omni3DiT ทำให้อินพุตแบบผสมนี้เข้าใจได้ การฝังบทบาทจะระบุโทเค็นที่เลือกและโทเค็นบริบท สาขา cross-attention แบบขนานจะใส่ฟีเจอร์ภาพจาก DINOv3 และฟีเจอร์ข้อความจาก CLIP ส่วนโทเค็นจุดจะเข้าสู่ self-attention ในขั้นโครงสร้างแบบเบาบาง ภาพจะช่วยกำกับลักษณะที่ปรากฏ ข้อความจะเพิ่มเจตนาเชิงความหมาย และจุดจะจำกัดโครงร่างเชิงพื้นที่ การดรอปเงื่อนไขจะเปลี่ยนแปลง guidance ที่มีอยู่ระหว่างการฝึก เพื่อส่งเสริมให้โมเดลใช้สัญญาณเสริมซึ่งกันและกัน แผนผังสถาปัตยกรรมอย่างเป็นทางการ
ยังคงจำเป็นต้องมีภาพ การสร้างใช้ 12 ขั้น Euler ต่อระยะ ส่วนการแก้ไข/การเติมส่วนที่ขาดใช้ 50 ขั้นสำหรับโครงสร้าง และ 12 ขั้นสำหรับรูปร่างและพื้นผิว การคงสภาพอย่างเข้มงวดมีผลกับโทเค็น latent ไม่จำเป็นต้องมีผลกับจุดยอดที่ถอดรหัสแล้วทุกจุด บทความและภาคผนวกการอนุมาน
การใช้งานและสิ่งที่จะเกิดขึ้นต่อไป
โอกาสเชิงปฏิบัติอยู่ที่การทำงานแบบวนซ้ำ: สำรวจรูปแบบต่าง ๆ ของพร็อพ ซ่อมแซมข้อมูลอ้างอิงที่ไม่สมบูรณ์ และปรับแต่งแอสเซ็ตผ่านคำสั่งต่อเนื่อง โครงการอย่างเป็นทางการยังสาธิตเวิร์กโฟลว์ของเอเจนต์ที่เตรียมภาพอ้างอิง ระบุบริเวณที่จะแก้ไข และเรียกใช้ SeMo3D ซึ่งชี้ให้เห็นการแบ่งงานที่เป็นประโยชน์: เอเจนต์แปลงเจตนาให้เป็นคำขอสร้างโมเดล ขณะที่โมเดล 3D จัดการการสังเคราะห์เฉพาะภูมิภาค การสาธิตโครงการแบบโต้ตอบ
ความพร้อมใช้งานยังมีข้อจำกัด ณ วันที่ตรวจสอบ 6 พฤศจิกายน 2026 คลังโค้ดอย่างเป็นทางการ มีเอกสารและแอสเซ็ตสาธิต ส่วน weights และโค้ดสำหรับการฝึก การอนุมาน และการประเมินผลยังไม่ได้เผยแพร่ ใบอนุญาต MIT ไม่ได้กำหนดเงื่อนไขการอนุญาตใช้สิทธิ์สำหรับ weights ที่จะเผยแพร่ในอนาคต บทความนี้ทบทวนบทความวิจัยและคลังโค้ดที่มีอยู่ โดยไม่ได้อ้างว่าเป็นการทำซ้ำผลการทดลองอย่างอิสระ รายการตรวจสอบการเผยแพร่
ผู้เขียนระบุทิศทางการวิจัยสองประการ การแทนค่า 3D ที่มีความเที่ยงตรงสูงขึ้น อาจช่วยจับโครงสร้างบาง เช่น ใบปาล์ม ได้ดีขึ้น ซึ่ง latent แบบมีโครงสร้างในปัจจุบันยังถอดรายละเอียดได้ยาก ตัวเข้ารหัสภาพและภาษาที่แข็งแกร่งขึ้น อาจช่วยให้เข้าใจพรอมป์ที่มีองค์ประกอบซับซ้อนได้ดีขึ้น โดยบทความแสดงให้เห็นว่าผลส้มกลายเป็นพื้นผิวสีส้มแทนที่จะเป็นวัตถุแยกกัน ข้อจำกัดและงานในอนาคต สิ่งที่โครงการยังต้องเผยแพร่คือ model weights บน Hugging Face และโค้ดที่สมบูรณ์สำหรับการอนุมาน การฝึก และการประเมินผล รายการ TODO อย่างเป็นทางการ
คำถามที่พบบ่อย
SeMo3D สามารถสร้างหรือแก้ไขแอสเซ็ตจากข้อความเพียงอย่างเดียวได้หรือไม่?
ไม่ใช่ เอกสารดังกล่าวกำหนดให้ต้องมีคำแนะนำด้วยภาพ ส่วนข้อความและจุดแบบกระจัดกระจายเป็นเงื่อนไขเพิ่มเติมที่ไม่บังคับ การแก้ไขยังต้องมีการเลือกบริเวณและบริบทของแหล่งข้อมูลด้วย การสาธิตการทำงานของเอเจนต์ด้วยภาษาธรรมชาติประกอบด้วยการเตรียมภาพ ไม่ใช่การยกเลิกข้อกำหนดด้านภาพ [Source](https://arxiv.org/html/2611.02568v1#S3.SS2).
สามารถเปลี่ยนพนักพิงเก้าอี้โดยคงส่วนอื่นๆ ไว้ได้หรือไม่
สิ่งนี้แสดงให้เห็นเวิร์กโฟลว์การแก้ไขเฉพาะที่ตามที่ตั้งใจไว้: เลือกบริเวณพนักพิง ให้คำแนะนำ และสังเคราะห์โทเค็นของบริเวณนั้นโดยนำโทเค็นบริบทกลับมาใช้ การคงเดิมอย่างแม่นยำใช้กับโทเค็นแฝง ไม่ควรตีความว่าเป็นการรับประกันว่าจุดยอดที่ถอดรหัสแล้วทุกจุดจะยังคงเหมือนเดิม [แหล่งที่มา](https://arxiv.org/html/2611.02568v1#S3.SS3)
ตอนนี้ฉันสามารถดีพลอย SeMo3D ในเครื่องได้หรือไม่
จากการตรวจสอบเมื่อวันที่ 6 พฤศจิกายน 2026 น้ำหนักโมเดลและโค้ดฉบับสมบูรณ์สำหรับการอนุมาน การฝึก และการประเมินผล ยังคงเป็นรายการที่ยังไม่เสร็จสิ้นสำหรับการเผยแพร่ เอกสารวิจัยสาธารณะและการสาธิตรองรับการประเมินทางเทคนิค แต่ repository ยังไม่มีชุดซอฟต์แวร์สำหรับการติดตั้งใช้งานภายในเครื่องอย่างครบถ้วน [Source](https://github.com/XiaokunSun/SeMo3D#-todo)




