Frontier3DBench: การประเมินเอเจนต์เขียนโค้ดสำหรับการสร้าง 3D ครอบคลุมวัตถุ ฉาก และโลกเปิด
Frontier3DBench ประเมินความสามารถของเอเจนต์ด้านการเขียนโค้ดในการสร้างโปรเจ็กต์ 3D ที่แก้ไขและเรียกใช้งานได้ ครอบคลุมวัตถุ ฉาก และโลกเปิดแบบโต้ตอบ
เอกสารต้นฉบับ: Frontier3DBench: การเปรียบเทียบประสิทธิภาพเอเจนต์เขียนโค้ดสำหรับการสร้าง 3D ครอบคลุมวัตถุ ฉาก และโลกเปิดแบบอินเทอร์แอกทีฟ (6 พฤศจิกายน 2026; v1).
ไฮไลต์และผลลัพธ์
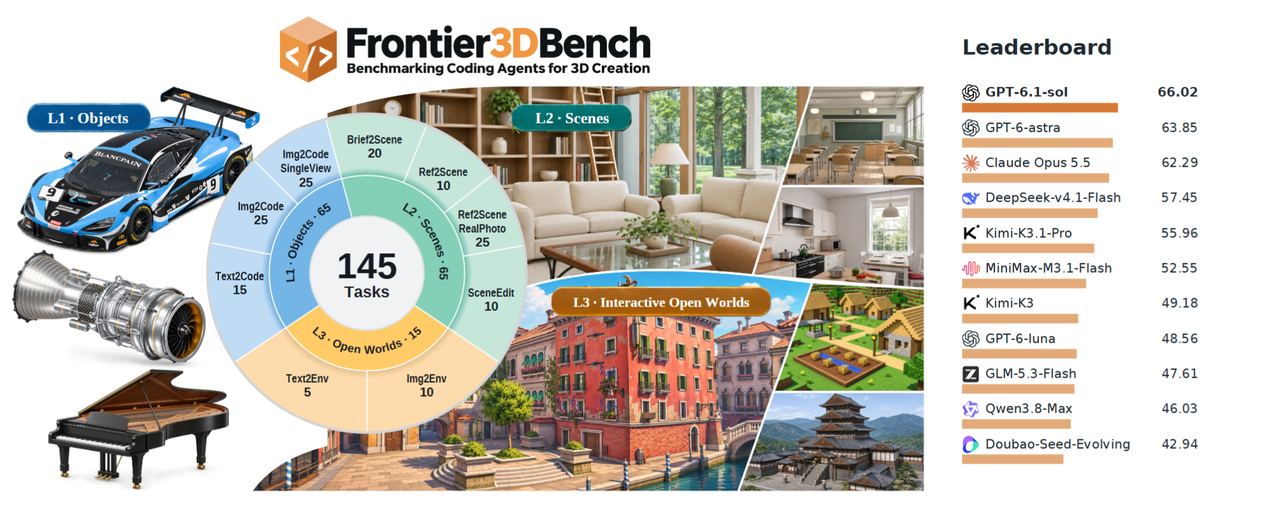
Frontier3DBench ตั้งคำถามว่าเอเจนต์เขียนโค้ดสามารถสร้างโปรเจกต์ 3D ที่แก้ไขและสั่งทำงานได้ ครอบคลุมวัตถุ ฉาก และโลกอินเทอร์แอกทีฟหรือไม่ สำหรับทีมที่กำลังเลือกเวิร์กโฟลว์การสร้างด้วย AI ผลงานนี้มีส่วนช่วยด้วยกรอบการประเมินร่วมกัน: งาน 145 งานจาก 9 กลุ่ม ซึ่งรวมถึงงานวัตถุใน Blender 65 งาน งานฉากใน Blender 65 งาน และงานโลกใน Unreal Engine 15 งาน อินพุตประกอบด้วยคำสั่ง ภาพอ้างอิง ภาพถ่าย และฉากที่มีอยู่แล้ว
ผู้เขียนประเมินการกำหนดค่าระหว่างโมเดลกับฮาร์เนส 11 แบบ GPT-6.1-sol ที่ใช้ Codex เป็นผู้นำโดยรวมที่ 66.02/100 ส่วน GPT-6-astra ที่ใช้ Codex เป็นผู้นำในด้านโลกอินเทอร์แอกทีฟที่ 61.28 ทุกการกำหนดค่าทำผลงานด้านการสร้างใหม่จากภาพอ้างอิงได้แย่กว่าการสร้างวัตถุและฉากจากข้อความ ในการส่งผลงานโลก 165 รายการ กลไกเฉพาะที่ average 83.08 การเว้นระยะของชิ้นส่วนที่เคลื่อนที่ 20.82 และเวิร์กโฟลว์แบบรักษาสถานะ 30.26 คะแนนเหล่านี้เป็นคะแนนองค์ประกอบ ไม่ใช่เปอร์เซ็นต์ของโลกที่ทำเสร็จได้สำเร็จ
การศึกษากับมนุษย์ให้การปรับเทียบในขอบเขตจำกัด: ผู้ประเมิน 8 คนจัดอันดับผู้สมัคร 4 รายการในแต่ละรายการวัตถุ/ฉากที่มีเงื่อนไขจากภาพอ้างอิง 45 รายการ คะแนนอัตโนมัติทำได้ค่า Kendall tau-b เฉลี่ย 0.727 และมีความสอดคล้องกับผู้ชนะ 79.2% แต่มีความสอดคล้องกับการจัดอันดับทั้งหมดเพียง 44.7% สิ่งนี้ไม่ได้ยืนยันความถูกต้องของทุกกลุ่มงานหรือพฤติกรรมของโลก ดูได้ที่ การทดลอง
วิธีการประเมิน
เอเจนต์ได้รับสัญญางาน: รูปทรงเรขาคณิตและรูปลักษณ์ที่จำเป็น ภาพอ้างอิงเมื่อเกี่ยวข้อง และแอสเซ็ตเริ่มต้นสำหรับการแก้ไข งานโลกยังระบุเอนทิตี สถานะเริ่มต้น การดำเนินการที่อนุญาต และข้อกำหนดเบื้องต้นเพิ่มเติม เอเจนต์เขียนและสั่งทำงานโค้ดสำหรับการสร้าง จากนั้นส่งโปรเจกต์ Blender หรือ Unreal แบบเนทีฟพร้อมไฟล์ส่งออกที่จำเป็น ไฟล์ประเมินยังคงอยู่นอกเวิร์กสเปซของเอเจนต์
ใน orchestrator ที่เผยแพร่ การตรวจสอบการทำงานแบบสาธารณะสามารถเรียกใช้การซ่อมแซมได้ แต่เอเจนต์จะได้รับข้อผิดพลาดแทนคะแนนส่วนตัว ซอร์สที่ยอมรับจะถูกตรึงและแฮชก่อนการประเมิน ผู้ประเมินแยกกันจะสั่งทำงานโปรแกรมอีกครั้ง ตรวจสอบเรขาคณิตแบบเนทีฟ เรนเดอร์มุมมอง และตัดสินการบรรลุงาน บทความใช้ Blender 5.2.1 และ Unreal Engine 5.8.3 โดยการสร้าง L1/L2 อนุญาตให้พยายามได้สูงสุด 6 ครั้งภายใน 32 ชั่วโมง สิ่งเหล่านี้เป็นเพดานงบประมาณ ไม่ใช่เวลาที่วัดได้ในการทำงานให้เสร็จ
การให้คะแนนเปลี่ยนไปตามงาน การสร้างใหม่จากภาพอ้างอิงประกอบด้วยความคล้ายคลึงของภาพ 50% การระบุตำแหน่งวัตถุที่ฉาย 20% การตัดสินด้วยสายตา 20% และรายละเอียด 10% ความคล้ายคลึงของภาพวัดโครงสร้าง ขอบ สี และโทน การระบุตำแหน่งจะจับคู่กรอบวัตถุและลงโทษอินสแตนซ์ที่ขาดหายหรือเกินมา GPT-6-astra ที่ระดับความพยายามปานกลางจะตัดสินเกณฑ์ภาพที่กำหนดไว้โดยซ่อนข้อมูลระบุตัวตนของตัวสร้าง การตรวจสอบรายละเอียดใช้ coverage คูณด้วยหนึ่งลบ deviation จากนั้นเลือกตัวแปรการทำงาน/ส่งออกที่จำเป็นซึ่งมีจุดอ่อนที่สุด งาน L1 ทั่วไปตรวจสอบการทำงาน 4 ครั้งในรูปแบบเนทีฟและ GLB ส่วน L2 ใช้ตัวแปรเนทีฟ 4 แบบ
การแก้ไขฉากวัดแยกกันทั้งการแก้ไขที่ร้องขอและการรักษาสภาพแวดล้อมที่ได้รับการปกป้อง การประเมินโลกจะสร้างโปรเจกต์ที่ส่งขึ้นใหม่ด้วยผู้สังเกตการณ์อิสระ และทดสอบผลของการกระทำที่มองเห็นได้ การตัดกันของชิ้นส่วนที่เคลื่อนที่ การเคลื่อนที่จริงของตัวละคร และสถานะที่คงอยู่ เวิร์กโฟลว์ต่อเนื่องห้ามการเทเลพอร์ตและการรีเซ็ต ดังนั้นการเปิดประตูเพียงลำพังจึงไม่สามารถทดแทนการทำเส้นทางให้เสร็จ ซึ่งต้องเอื้อมถึง ปลดล็อก และเดินผ่านประตูนั้น
คะแนนโลกให้น้ำหนักคุณภาพภาพ ความเที่ยงตรงต่องาน เลย์เอาต์ และการโต้ตอบที่ 60/20/5/15 คะแนนรวมสุดท้ายของเบนช์มาร์กให้น้ำหนัก L1/L2/L3 ที่ 30/30/40 สัญญาการให้คะแนน แยกข้อบกพร่องของผู้สมัครที่ยืนยันแล้วออกจากหลักฐานทางเทคนิคที่ขาดหาย: ความล้มเหลวของ API หรือการวัดต้องไม่ถูกเปลี่ยนเป็นศูนย์โดยไม่แจ้ง
การประยุกต์ใช้และความท้าทายที่ยังเปิดอยู่
เบนช์มาร์กนี้ช่วยสนับสนุนการเลือกเวิร์กโฟลว์ของเอเจนต์เขียนโค้ด และวินิจฉัยว่าความล้มเหลวเกี่ยวข้องกับรูปลักษณ์ เรขาคณิต การแก้ไข หรือพฤติกรรม รีโพซิทอรีแบบเปิดมีอินพุตของงาน โค้ดสำหรับการสร้าง/การประเมิน และสัญญาการให้คะแนน ซอฟต์แวร์เบนช์มาร์กใช้ Apache-2.0 ขณะที่แอสเซ็ตของงานยังคงใช้สัญญาอนุญาตของตนเอง การตั้งค่า Blender, Unreal Engine และการเข้าถึงโมเดลต้องดำเนินการแยกต่างหาก
บทความระบุความท้าทายหลักที่ยังเปิดอยู่ 2 ประการ: การทำให้เรขาคณิตและเลย์เอาต์ตรงตามที่ระบุ และการประสานชิ้นส่วนที่เคลื่อนที่ การกระทำ และสถานะที่คงอยู่ สิ่งเหล่านี้เป็นทิศทางการวิจัยของผู้เขียน ไม่ใช่ฟีเจอร์ผลิตภัณฑ์ที่ประกาศไว้ การเปรียบเทียบอธิบายการตั้งค่าโมเดลกับฮาร์เนสแบบครบชุด และการตัดสินด้วยสายตายังคงมีข้อจำกัดด้านการปรับเทียบ งานที่ใช้ภาพถ่ายยังขาด ground truth 3D แบบเนทีฟที่เป็นสากล รีวิวนี้อ่านบทความและการใช้งานจริง แต่ไม่ได้รันเบนช์มาร์กซ้ำ
คำถามที่พบบ่อย
Frontier3DBench เองเป็นโมเดลสร้าง 3D หรือไม่
ไม่ใช่ มันจัดเตรียมงานและตัวประเมินสำหรับเอเจนต์เขียนโค้ดที่สร้างโปรเจ็กต์ Blender และ Unreal โดยไม่ได้แนะนำตัวสร้างเมชที่ผ่านการฝึกสอนหรือการแทนค่าแฝง 3 มิติรูปแบบใหม่
เหตุใดภาพหน้าจอจึงไม่เพียงพอสำหรับการส่งผลงาน?
สัญญากำหนดให้ต้องมีอาร์ติแฟกต์ต้นฉบับที่แก้ไขได้และพฤติกรรมที่ทำงานได้ ผู้ประเมินจะตรวจสอบเรขาคณิต เรนเดอร์ฉากที่บันทึกไว้อีกครั้ง และทดสอบการโต้ตอบ ดังนั้นรูปลักษณ์เพียงอย่างเดียวจึงไม่อาจยืนยันความถูกต้องได้
คะแนนรวมสูงสุดระบุเอเจนต์ที่ดีที่สุดสำหรับทุกงานหรือไม่?
ไม่ใช่ ผู้นำแตกต่างกันไปตามกลุ่มงาน และคะแนนรวมการกำหนดค่า harness และการใช้เหตุผลไว้ด้วย โปรดเปรียบเทียบโปรไฟล์งานที่เกี่ยวข้องก่อนเลือกเวิร์กโฟลว์




