SeMo3D: Förenad 3D-generering, redigering och komplettering genom selektiv modellering
SeMo3D introducerar ett enhetligt tillvägagångssätt för 3D-generering, lokal redigering och komplettering med hjälp av selektiv modellering.

Höjdpunkter och resultat: förändra det som spelar roll
Originalartikel: SeMo3D: Unifying 3D Generation, Editing, and Completion via Selective Modeling
SeMo3D, som introducerats av forskare vid Nanjing University, samlar 3D-generering, lokal redigering och komplettering i ett och samma ramverk. För team som utforskar AI-baserad skapande av 3D-tillgångar är den centrala fördelen kontinuitet: skapa ett objekt, ändra ett valt område eller rekonstruera en saknad del samtidigt som den befintliga kontexten bevaras. Namnet står för Selective Modeling, en strategi där området som ska syntetiseras utgör det gemensamma gränssnittet mellan dessa uppgifter. Officiellt arkiv.
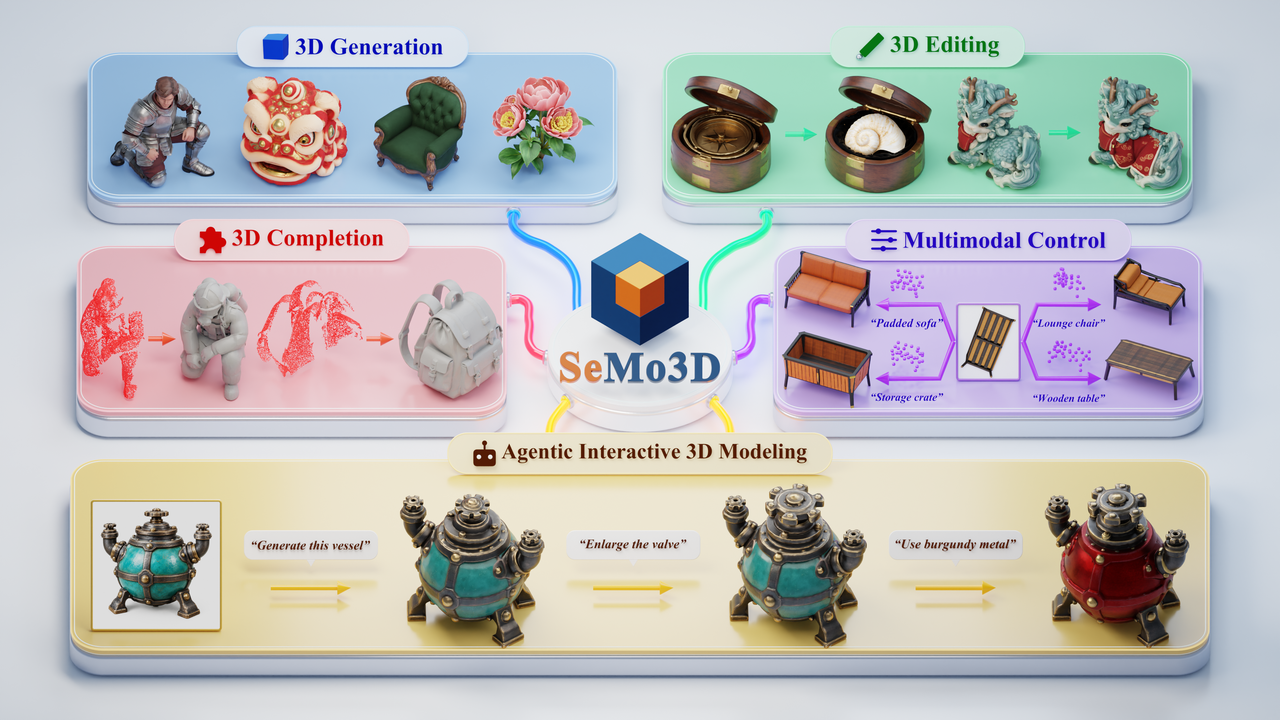
På Toys4K rapporterar författarna ett geometriskt Chamfer-avstånd på 0.0118 jämfört med TRELLIS.2:s 0.0330 (lägre är bättre). Bevarandet vid redigering når 37.39 dB PSNR jämfört med VoxHammers 31.55 dB. F-score för komplettering når 0.541 jämfört med HY3D-Omnis 0.412 med ytterligare punktvägledning. Vilka indata som stöds skiljer sig mellan metoderna, och punkthänvisningarna kommer från ground truth; dessa jämförelser isolerar inte arkitekturens bidrag. Artikel, tabell 1–3.
Så fungerar det: välj, syntetisera, bevara
Den centrala abstraktionen delar upp en tillgång i ett valt område S och bevarad kontext C. Vid generering väljs allt; vid redigering väljs målområdet; vid komplettering väljs det som saknas. För en stol kan samma gränssnitt skapa hela stolen, byta ut ryggstödet eller rekonstruera ett saknat ben. Detta är illustrativa användningar av uppgiftsdefinitionen. Modellen lär sig ett gemensamt problem för regional syntes i stället för att kräva en separat uppgiftsspecifik träningsprocedur. Översikt över arkivet.
SeMo3D finjusterar TRELLIS.2:s tre flödesmodeller på Trellis-500K och återanvänder dess SC-VAE. Gles struktur förutsäger beläggning på ett 16³ latent rutnät; form och textur verkar på upptagna positioner i ett 32³-rutnät och producerar geometri och PBR-material. Masken överförs mellan stegen. En förening av uppgifterna använder alltså fortfarande tre stegsspecifika modeller. Artikel, metod och träningsdetaljer.
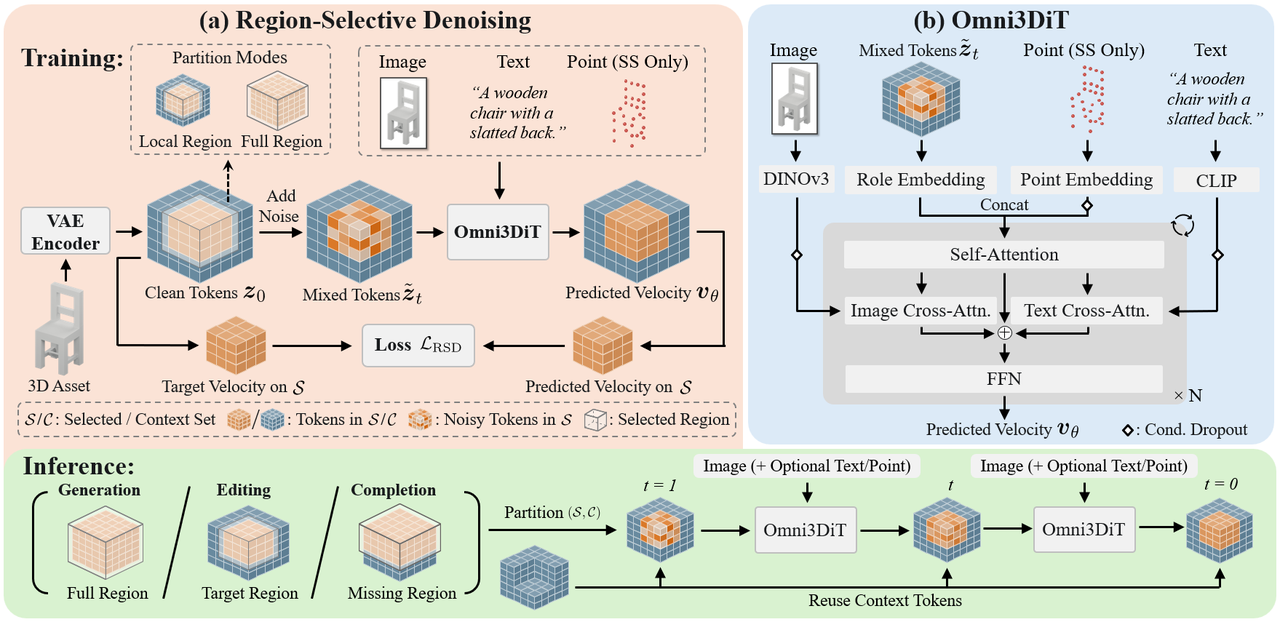
Regionselektiv brusreducering skapar träningsexempel från vanliga tillgångar. Ett slumpmässigt område tillförs brus medan omgivningen förblir ren; endast förutsägelser i det området bidrar till förlusten. Träningen omfattar allt från lokala rutor till kompletta tillgångar, utan behov av parade före- och efterbilder för redigering eller kompletteringsdataset. Vid inferens startar valda token från brus och utvecklas under vägledning, medan ursprungliga kontexttoken återanvänds vid varje steg. Modellen kan därför ta hänsyn till hela objektet utan att syntetisera om allt. Officiell metodförklaring.
Omni3DiT gör denna blandade indata begriplig. Rollinbäddningar identifierar valda token och kontexttoken. Parallella korsuppmärksamhetsgrenar tillför DINOv3-bildfunktioner och CLIP-textfunktioner; punkttoken går in i självuppmärksamheten i steget för gles struktur. Bilder vägleder utseendet, text tillför semantisk avsikt och punkter begränsar den rumsliga layouten. Villkorsbortfall varierar den tillgängliga vägledningen under träningen, vilket uppmuntrar modellen att använda de kompletterande signalerna. Officiellt arkitekturdiagram.
En bild är fortfarande obligatorisk. Generering använder 12 Euler-steg per steg; redigering/komplettering använder 50 för struktur och 12 för form och textur. Strikt bevarande gäller latenta token, inte nödvändigtvis varje avkodad vertex. Artikel och bilaga om inferens.
Tillämpningar och vad som kommer härnäst
Den praktiska möjligheten ligger i iterativt arbete: utforska varianter av rekvisita, reparera ofullständiga referenser och förfina tillgångar genom upprepade instruktioner. Det officiella projektet visar också agentarbetsflöden som förbereder referensbilder, identifierar redigeringsområden och anropar SeMo3D. Detta antyder en användbar arbetsfördelning: en agent översätter avsikten till en modelleringsförfrågan, medan 3D-modellen hanterar regional syntes. Interaktiva projektdemonstrationer.
Beredskapen är fortfarande begränsad. Kontrollerat den 6 november 2026 innehåller det officiella arkivet dokumentation och demonstrationsmaterial; vikter samt tränings-, inferens- och utvärderingskod är fortfarande inte släppta. MIT-licensen fastställer inte licensvillkoren för framtida vikter. Den här artikeln granskar artikeln och det tillgängliga arkivet utan att göra anspråk på en oberoende reproduktion. Checklista för lansering.
Författarna identifierar två forskningsinriktningar. 3D-representationer med högre detaljåtergivning skulle kunna fånga tunna strukturer, som palmblad, bättre; de nuvarande strukturerade latenta representationerna har svårt att lösa dem. Starkare syn- och språkbaserade kodare skulle kunna förbättra förståelsen av komplexa sammansatta uppmaningar; artikeln visar att orange frukter blir orange textur i stället för separata objekt. Begränsningar och framtida arbete. Projektets återstående lanseringsmål är modellvikter på Hugging Face samt komplett inferens-, tränings- och utvärderingskod. Officiell TODO-lista.
Vanliga frågor
Kan SeMo3D generera eller redigera en resurs enbart från text?
Nej. Artikeln kräver bildvägledning; text och glesa punkter är valfria ytterligare villkor. Redigering kräver också en vald region och källkontext. Demonstrationer av agenter på naturligt språk inkluderar bildförberedelse snarare än att ta bort bildkravet. [Källa](https://arxiv.org/html/2611.02568v1#S3.SS2).
Kan jag byta ut ryggstödet på en stol och behålla resten?
Det illustrerar det avsedda arbetsflödet för lokal redigering: välj ryggstödsområdet, ge vägledning och syntetisera dess tokens samtidigt som kontexttokens återanvänds. Exakt bevarande gäller latenta tokens; det ska inte tolkas som en garanti för att varje avkodad vertex förblir identisk. [Källa](https://arxiv.org/html/2611.02568v1#S3.SS3).
Kan jag distribuera SeMo3D lokalt nu?
Kontrollerat den 6 november 2026 är modellvikter samt komplett kod för inferens, träning och utvärdering fortfarande ej avklarade lanseringsmilstolpar. Den offentliga artikeln och demonstrationerna möjliggör teknisk utvärdering, men kodarkivet tillhandahåller ännu inte hela stacken för lokal distribution. [Källa](https://github.com/XiaokunSun/SeMo3D#-todo).




