SeMo3D: объединение генерации, редактирования и дополнения 3D с помощью выборочного моделирования
SeMo3D представляет унифицированный подход к генерации 3D-моделей, локальному редактированию и дополнению с использованием селективного моделирования.

Основные моменты и результаты: меняем то, что важно
Исходная статья: SeMo3D: объединение генерации, редактирования и дополнения 3D-моделей с помощью селективного моделирования
SeMo3D, представленный исследователями Нанкинского университета, объединяет генерацию 3D-моделей, локальное редактирование и дополнение в единую структуру. Для команд, занимающихся созданием AI-ассетов, его главное преимущество — непрерывность: можно создать объект, изменить выбранную область или восстановить отсутствующий фрагмент, сохранив существующий контекст. Название расшифровывается как Selective Modeling, то есть селективное моделирование — стратегия, в которой область для синтеза служит общим интерфейсом между этими задачами. Официальный репозиторий.
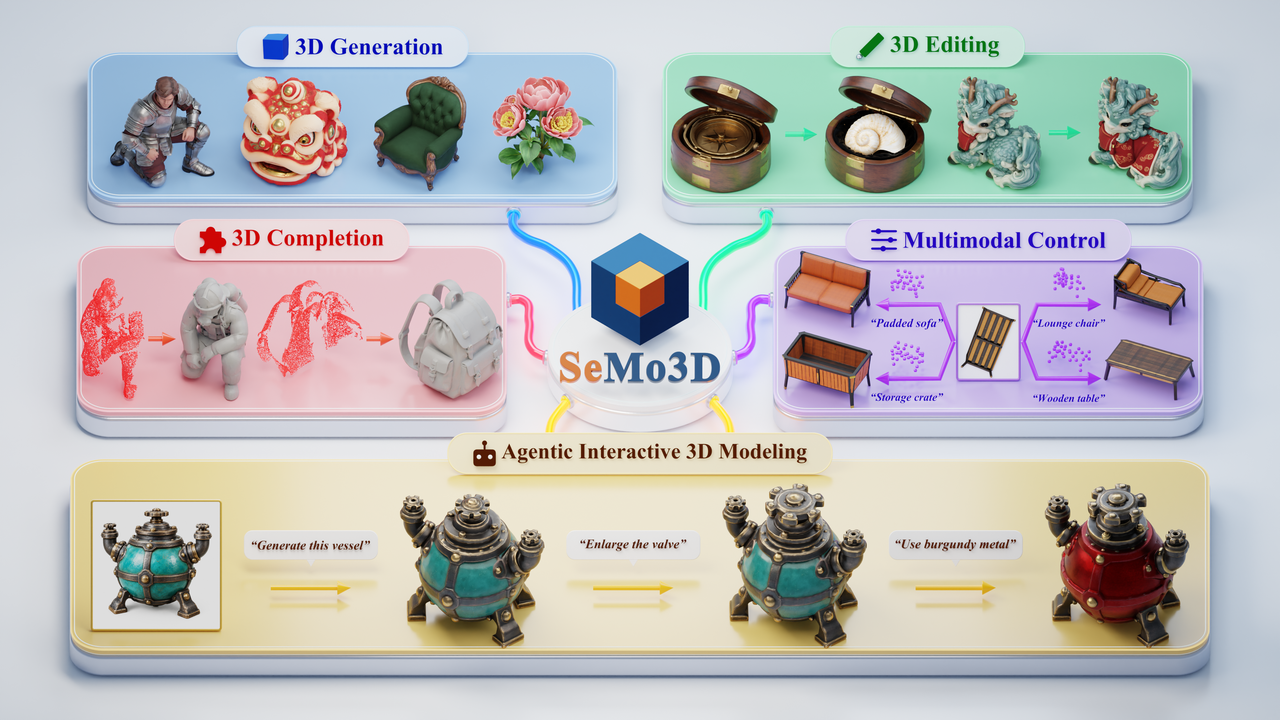
На Toys4K авторы сообщают о геометрическом расстоянии Чамфера 0.0118 против 0.0330 у TRELLIS.2 (меньше — лучше). Сохранение при редактировании достигает 37.39 дБ PSNR против 31.55 дБ у VoxHammer. F-score при дополнении достигает 0.541 против 0.412 у HY3D-Omni при использовании дополнительных точечных указаний. Поддерживаемые входные данные различаются у разных методов, а точечные подсказки получают из ground truth; эти сравнения не изолируют преимущества архитектуры. Статья, таблицы 1–3.
Как это работает: выбор, синтез, сохранение
Ключевая абстракция разделяет ассет на выбранную область S и сохраняемый контекст C. При генерации выбирается всё; при редактировании — целевая область; при дополнении — отсутствующая часть. Для стула один и тот же интерфейс может создать стул целиком, заменить его спинку или восстановить отсутствующую ножку. Это иллюстративные варианты применения определения задачи. Модель обучается общей задаче регионального синтеза, а не требует отдельного специализированного для каждой задачи процесса обучения. Обзор репозитория.
SeMo3D дообучает три flow-модели TRELLIS.2 на Trellis-500K и повторно использует его SC-VAE. Разреженная структура прогнозирует занятость в латентной сетке 16³; форма и текстура работают в занятых позициях сетки 32³, создавая геометрию и PBR-материалы. Маска передаётся между этапами. Таким образом, объединение задач по-прежнему использует три модели, специализированные для отдельных этапов. Статья, сведения о методе и обучении.
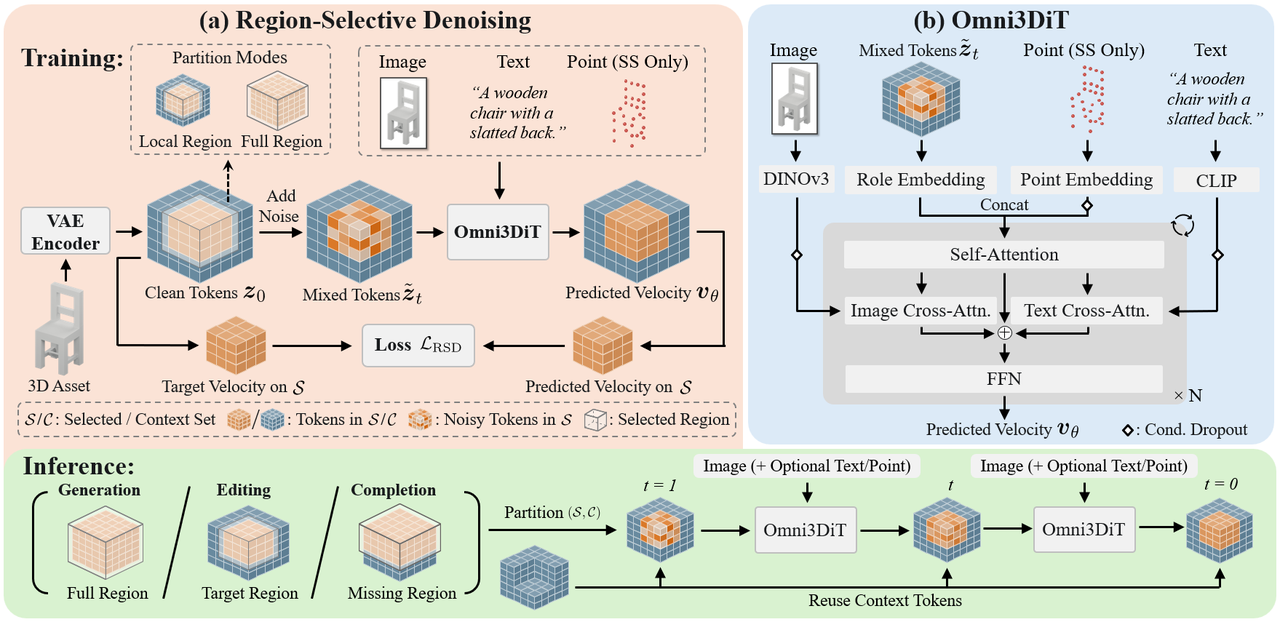
Регионально-селективное удаление шума создаёт обучающие примеры из обычных ассетов. Случайная область получает шум, а её окружение остаётся чистым; в функцию потерь вносят вклад только предсказания в этой области. Обучение охватывает диапазон от локальных областей до ассетов целиком, что позволяет обойтись без парных наборов данных до и после редактирования или дополнения. На этапе вывода выбранные токены начинают с шума и изменяются под руководством модели, а исходные контекстные токены используются повторно на каждом шаге. Поэтому модель может обращаться ко всему объекту, не пересинтезируя его целиком. Официальное объяснение метода.
Omni3DiT делает этот смешанный ввод понятным для модели. Вложения ролей идентифицируют выбранные и контекстные токены. Параллельные ветви перекрёстного внимания добавляют признаки изображений DINOv3 и текстовые признаки CLIP; точечные токены входят в self-attention на этапе разреженной структуры. Изображения задают внешний вид, текст добавляет семантическое намерение, а точки ограничивают пространственную компоновку. Отсев условий варьирует доступные указания во время обучения и побуждает модель использовать взаимодополняющие сигналы. Официальная схема архитектуры.
Изображение остаётся обязательным. При генерации используется 12 шагов Эйлера на каждом этапе; при редактировании и дополнении — 50 шагов для структуры и 12 для формы и текстуры. Строгое сохранение применяется к латентным токенам, но не обязательно к каждой декодированной вершине. Статья и приложение по выводу.
Применения и дальнейшие перспективы
Практическая возможность заключается в итеративной работе: исследовании вариантов пропов, исправлении неполных референсов и доработке ассетов с помощью последовательных инструкций. Официальный проект также демонстрирует агентные рабочие процессы, которые подготавливают референсные изображения, определяют области редактирования и вызывают SeMo3D. Это предполагает полезное разделение труда: агент переводит намерение в запрос на моделирование, а 3D-модель выполняет региональный синтез. Интерактивные демонстрации проекта.
Готовность к использованию остаётся ограниченной. По состоянию на 6 ноября 2026 года официальный репозиторий содержит документацию и демонстрационные ассеты; веса, а также код обучения, вывода и оценки ещё не опубликованы. Его лицензия MIT не определяет условия лицензирования будущих весов. В этой статье рассматриваются статья и доступный репозиторий; независимое воспроизведение результатов не заявляется. Список релизных задач.
Авторы выделяют два направления исследований. 3D-представления более высокой точности могли бы лучше захватывать тонкие структуры, такие как пальмовые листья, с которыми текущие структурированные латентные представления справляются с трудом. Более мощные зрительно-языковые энкодеры могли бы улучшить понимание сложных композиционных запросов; в статье показано, как оранжевые фрукты превращаются в оранжевую текстуру, а не в отдельные объекты. Ограничения и дальнейшая работа. Оставшиеся этапы релиза проекта — веса модели на Hugging Face и полный код вывода, обучения и оценки. Официальный список TODO.
Часто задаваемые вопросы
Может ли SeMo3D создавать или редактировать ресурс только по текстовому описанию?
Нет. В статье требуется визуальное сопровождение; текст и разреженные точки являются необязательными дополнительными условиями. Для редактирования также нужны выбранная область и контекст источника. Демонстрации агента на естественном языке включают подготовку изображения, а не отмену требования к изображению. [Источник](https://arxiv.org/html/2611.02568v1#S3.SS2).
Могу ли я заменить спинку стула, сохранив остальную часть?
Это иллюстрирует предполагаемый рабочий процесс локального редактирования: выберите область спинки, предоставьте указания и синтезируйте её токены, повторно используя контекстные токены. Точное сохранение относится к латентным токенам; это не следует воспринимать как гарантию того, что каждая декодированная вершина останется идентичной. [Источник](https://arxiv.org/html/2611.02568v1#S3.SS3).
Могу ли я теперь развернуть SeMo3D локально?
По состоянию на 6 ноября 2026 года веса модели, а также полный код инференса, обучения и оценки всё ещё числятся невыполненными пунктами релиза. Публичная статья и демонстрационные материалы позволяют провести техническую оценку, однако репозиторий пока не предоставляет полный стек для локального развёртывания. [Источник](https://github.com/XiaokunSun/SeMo3D#-todo).




