Frontier3DBench: Бенчмаркинг агентов для программирования в создании 3D-объектов, сцен & открытых миров
Frontier3DBench оценивает способность агентов, пишущих код, создавать редактируемые и исполняемые 3D-проекты, включающие объекты, сцены и интерактивные открытые миры.
Исходная статья: Frontier3DBench: Benchmarking Coding Agents for 3D Creation across Objects, Scenes, and Interactive Open Worlds (6 ноября 2026 г.; v1).
Основные моменты и результаты
Frontier3DBench исследует, могут ли агенты программирования создавать редактируемые и исполняемые 3D-проекты для объектов, сцен и интерактивных миров. Для команд, выбирающих рабочий процесс создания с использованием ИИ, его вклад заключается в общей структуре оценки: 145 задач в девяти категориях, включая 65 задач с объектами Blender, 65 задач со сценами Blender и 15 задач с мирами Unreal Engine. Входные данные включают инструкции, эталонные изображения, фотографии и существующие сцены.
Авторы оценивают 11 конфигураций «модель–обвязка». GPT-6.1-sol с Codex лидирует в общем зачёте с результатом 66,02/100; GPT-6-astra с Codex лидирует в интерактивных мирах с результатом 61,28. Все конфигурации хуже справляются с реконструкцией по эталону, чем с генерацией объектов и сцен по текстовому описанию. Среди 165 отправленных миров средние показатели локальных механизмов составляют 83,08, зазора для движущихся частей — 20,82, а рабочих процессов с сохранением состояния — 30,26. Это компонентные баллы, а не проценты успешно завершённых миров.
Исследование с участием людей даёт ограниченную калибровку: восемь оценщиков ранжируют по четыре кандидата для каждого из 45 объектов/сцен, заданных эталоном. Автоматические оценки достигают среднего Kendall tau-b 0,727 и совпадения по победителю в 79,2% случаев, но совпадают с полной последовательностью ранжирования лишь в 44,7% случаев. Это не подтверждает корректность каждой категории задач или поведения миров. См. эксперименты.
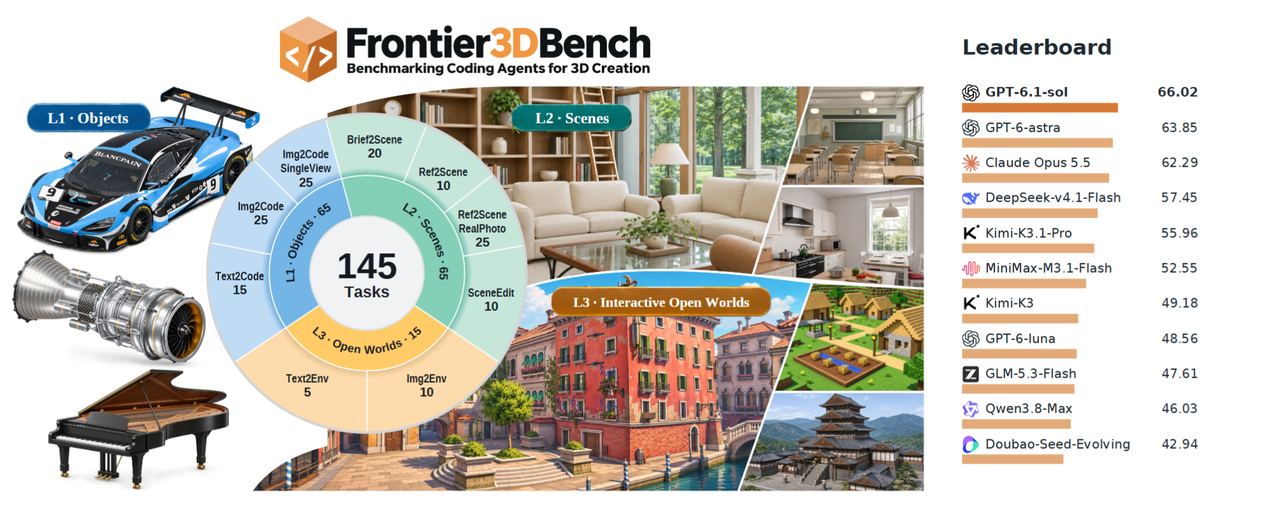
Как работает оценка
Агент получает контракт задачи: требуемые геометрию и внешний вид, эталонные изображения, если они применимы, и исходные ресурсы для редактирования. Задачи с мирами дополнительно определяют сущности, начальные состояния, разрешённые операции и предварительные условия. Агент пишет и выполняет код создания, затем отправляет нативный проект Blender или Unreal вместе с необходимыми экспортами. Файлы оценки остаются за пределами его рабочего пространства.
В опубликованном оркестраторе общедоступные проверки выполнения могут запускать исправления, но агент получает ошибки, а не закрытые оценки. Принятый исходный код фиксируется и хешируется до начала оценки. Отдельные оценщики повторно запускают программу, проверяют нативную геометрию, визуализируют виды и оценивают выполнение задачи. В статье используются Blender 5.2.1 и Unreal Engine 5.8.3; генерация L1/L2 допускает до шести попыток в течение 32 часов. Это верхние границы бюджета, а не измеренное время выполнения.
Методика подсчёта меняется в зависимости от задачи. Реконструкция по эталону объединяет сходство изображений (50%), локализацию объекта в проекции (20%), визуальную оценку (20%) и детализацию (10%). Сходство изображений измеряет структуру, границы, цвет и тон; локализация сопоставляет рамки объектов и штрафует за отсутствующие или лишние экземпляры. GPT-6-astra при среднем уровне усилий оценивает фиксированные визуальные критерии, не зная идентичности генератора. Для проверки детализации используется покрытие, умноженное на единицу минус отклонение, после чего берётся самый слабый из требуемых вариантов выполнения/экспорта. Обычные задачи L1 проверяют четыре выполнения в нативном формате и формате GLB; L2 использует четыре нативных варианта.
Редактирование сцен отдельно измеряет запрошенное изменение и сохранность защищённого окружения. При оценке мира отправленный проект перестраивается с независимым наблюдателем, после чего проверяются видимые эффекты действий, пересечения движущихся частей, фактическое перемещение персонажа и сохраняющееся состояние. Непрерывные рабочие процессы запрещают телепортацию и сбросы. Поэтому открытие двери само по себе не может заменить прохождение маршрута, требующего подойти к двери, разблокировать её и пройти через неё.
Весовые коэффициенты оценки мира составляют 60/20/5/15 для визуального качества, соответствия задаче, компоновки и взаимодействия. В итоговом общем балле бенчмарка веса L1/L2/L3 составляют 30/30/40. Контракт оценки различает подтверждённые дефекты кандидата и отсутствие технических свидетельств: сбой API или измерения не должен молча превращаться в нулевой балл.
Применения и нерешённые задачи
Бенчмарк помогает выбирать рабочие процессы с агентами программирования и диагностировать, связаны ли сбои с внешним видом, геометрией, редактированием или поведением. Его открытый репозиторий включает входные данные задач, код генерации и оценки, а также контракты оценки; программное обеспечение бенчмарка распространяется по лицензии Apache-2.0, тогда как ресурсы задач сохраняют собственные лицензии. Для Blender, Unreal Engine и доступа к моделям требуется отдельная настройка.
В статье выделены две центральные нерешённые задачи: соответствие заданным геометрии и компоновке, а также координация движущихся частей, действий и сохраняющегося состояния. Это исследовательские направления авторов, а не анонсированные функции продукта. Сравнения описывают полные конфигурации «модель–обвязка», а визуальная оценка сохраняет ограничения калибровки; для задач с фотографиями также отсутствует универсальная нативная эталонная 3D-модель. В этом обзоре изучаются статья и реализация, но бенчмарк не запускается повторно.
Часто задаваемые вопросы
Является ли сам Frontier3DBench моделью генерации 3D?
Нет. Он предоставляет задачи и средства оценки для кодинговых агентов, создающих проекты в Blender и Unreal. Он не представляет обученный генератор мешей или новое латентное представление 3D.
Почему скриншотов недостаточно для отправки?
Контракт требует редактируемых нативных артефактов и исполняемого поведения. Оценщики проверяют геометрию, повторно визуализируют сохранённые сцены и тестируют взаимодействия, поэтому одного внешнего вида недостаточно для подтверждения корректности.
Определяет ли самый высокий общий балл лучшего агента для каждой задачи?
Нет. Лидеры различаются в зависимости от семейства задач, а оценка включает конфигурацию тестового стенда и рассуждений. Сравните соответствующий профиль задачи, прежде чем выбирать рабочий процесс.
Связанные статьи

Генератор 3D-моделей на базе ИИ: изображение в 3D vs текст в 3D
 Tammy · 13 авг. 2026 г.

Сравнение платформ для создания 3D с помощью ИИ: V2Fun, Meshy и Tripo
 V2Fun Team · 2 сент. 2026 г.

Руководство по ИИ-инструменту для создания 3D-моделей: как превращать фотографии товаров в 3D-модели
Tammy · 17 июн. 2026 г.