SeMo3D: Unificação da Geração, Edição e Conclusão 3D através de Modelação Seletiva
A SeMo3D apresenta uma abordagem unificada à geração 3D, à edição local e à conclusão utilizando modelação seletiva.

Destaques e resultados: mudar o que importa
**Artigo original: **SeMo3D: Unifying 3D Generation, Editing, and Completion via Selective Modeling
O SeMo3D, apresentado por investigadores da Universidade de Nanjing, reúne a geração 3D, a edição local e a conclusão num único enquadramento. Para equipas que exploram a criação de recursos com IA, a sua principal promessa é a continuidade: criar um objeto, rever uma região escolhida ou reconstruir uma secção em falta, mantendo o contexto existente. O nome significa Selective Modeling, uma estratégia que transforma a região a sintetizar na interface comum entre estas tarefas. Repositório oficial.
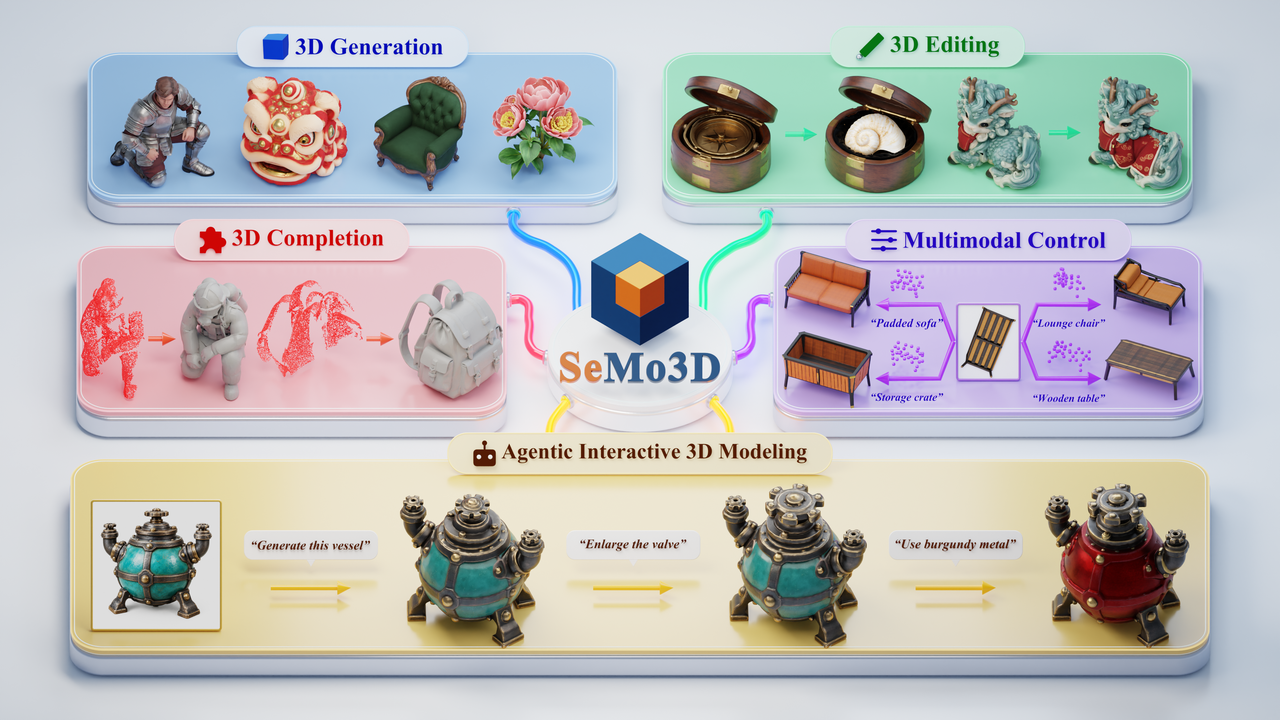
No Toys4K, os autores reportam uma Chamfer Distance geométrica de 0.0118 contra 0.0330 do TRELLIS.2 (quanto menor, melhor). A preservação na edição alcança 37.39 dB PSNR contra 31.55 dB do VoxHammer. O F-score de conclusão alcança 0.541 contra 0.412 do HY3D-Omni, com orientação adicional por pontos. As entradas suportadas diferem entre os métodos e as indicações de pontos provêm da verdade fundamental; estas comparações não isolam os ganhos da arquitetura. Artigo, Tabelas 1–3.
Como funciona: selecionar, sintetizar, preservar
A abstração fundamental divide um recurso numa região selecionada S e num contexto preservado C. A geração seleciona tudo; a edição seleciona o alvo; a conclusão seleciona o que falta. Para uma cadeira, a mesma interface poderia criar a cadeira inteira, substituir o seu encosto ou reconstruir uma perna ausente. Estes são exemplos ilustrativos da definição da tarefa. O modelo aprende um problema partilhado de síntese regional, em vez de exigir uma receita de treino específica para cada tarefa. Visão geral do repositório.
O SeMo3D ajusta os três modelos de fluxo do TRELLIS.2 com o Trellis-500K e reutiliza o seu SC-VAE. A estrutura esparsa prevê a ocupação numa grelha latente 16³; a forma e a textura operam nas posições ocupadas numa grelha 32³, produzindo geometria e materiais PBR. A máscara é transferida entre as fases. Assim, a unificação das tarefas continua a utilizar três modelos específicos de cada fase. Artigo, detalhes do método e do treino.
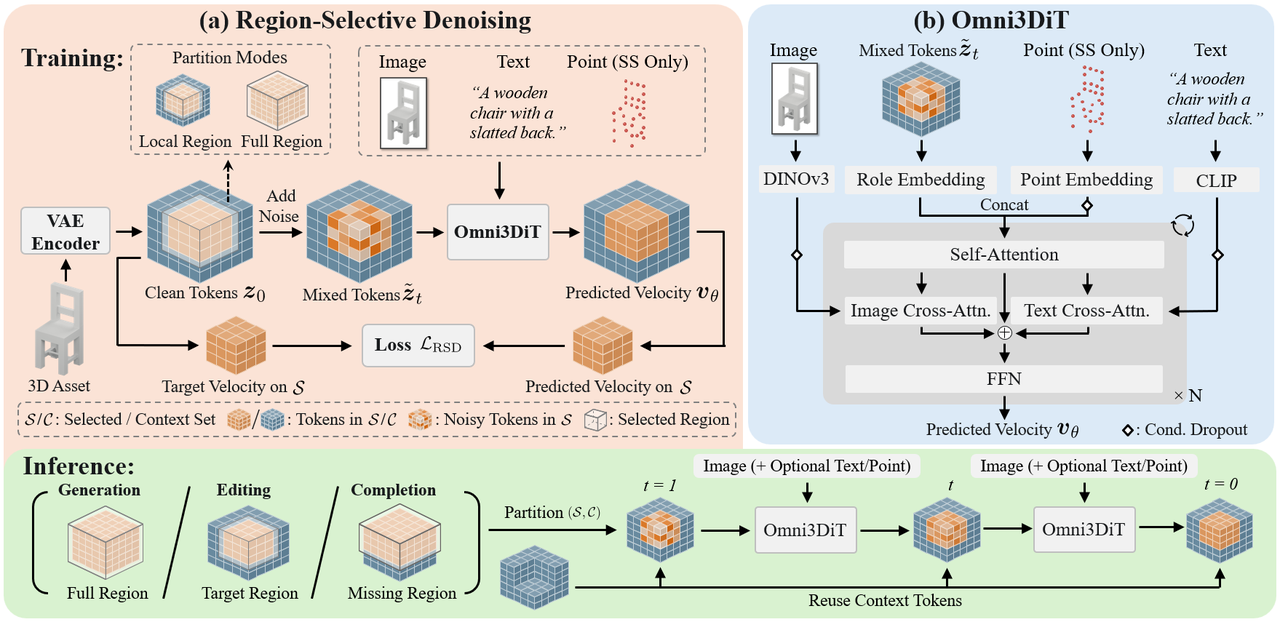
A remoção seletiva de ruído por região cria exemplos de treino a partir de recursos comuns. Uma região aleatória recebe ruído enquanto as áreas circundantes permanecem limpas; apenas as previsões nessa região contribuem para a perda. O treino abrange desde caixas locais até recursos completos, evitando conjuntos de dados emparelhados de edição ou conclusão antes e depois. Durante a inferência, os tokens selecionados começam com ruído e evoluem sob orientação, enquanto os tokens de contexto originais são reutilizados em cada passo. Assim, o modelo pode consultar o objeto inteiro sem o ressintetizar por completo. Explicação oficial do método.
O Omni3DiT torna compreensível essa entrada mista. As incorporações de função identificam os tokens selecionados e de contexto. Ramos paralelos de atenção cruzada injetam características de imagem DINOv3 e características de texto CLIP; os tokens de pontos entram na autoatenção na fase de estrutura esparsa. As imagens orientam a aparência, o texto acrescenta intenção semântica e os pontos restringem a disposição espacial. O abandono de condições varia a orientação disponível durante o treino, incentivando o modelo a utilizar os sinais complementares. Diagrama oficial da arquitetura.
Uma imagem continua a ser obrigatória. A geração utiliza 12 passos de Euler por fase; a edição/conclusão utiliza 50 para a estrutura e 12 para a forma e a textura. A preservação estrita aplica-se aos tokens latentes, não necessariamente a todos os vértices descodificados. Artigo e apêndice de inferência.
Aplicações e próximos passos
A oportunidade prática está no trabalho iterativo: explorar variantes de objetos, reparar referências incompletas e aperfeiçoar recursos através de instruções sucessivas. O projeto oficial também demonstra fluxos de trabalho com agentes que preparam imagens de referência, identificam regiões de edição e invocam o SeMo3D. Isto sugere uma divisão de trabalho útil: um agente traduz a intenção num pedido de modelação, enquanto o modelo 3D trata da síntese regional. Demonstrações interativas do projeto.
A prontidão continua limitada. Verificado em 6 de novembro de 2026, o repositório oficial contém documentação e recursos de demonstração; os pesos e o código de treino, inferência e avaliação continuam por lançar. A sua licença MIT não estabelece os termos de licenciamento para futuros pesos. Este artigo analisa o artigo científico e o repositório disponível, sem alegar uma reprodução independente. Lista de verificação do lançamento.
Os autores identificam duas direções de investigação. Representações 3D de maior fidelidade poderiam captar melhor estruturas finas, como folhas de palmeira, que os latentes estruturados atuais têm dificuldade em resolver. Codificadores de visão-linguagem mais robustos poderiam melhorar a compreensão de instruções composicionais complexas; o artigo mostra frutos cor de laranja a transformarem-se em textura laranja, em vez de objetos separados. Limitações e trabalho futuro. Os marcos de lançamento restantes do projeto são pesos do modelo no Hugging Face e código completo de inferência, treino e avaliação. Lista oficial de tarefas.
Perguntas frequentes
O SeMo3D pode gerar ou editar um recurso apenas a partir de texto?
Não. O artigo exige orientação por imagem; o texto e os pontos esparsos são condições adicionais opcionais. A edição também requer uma região selecionada e contexto de origem. As demonstrações de agentes de linguagem natural incluem a preparação da imagem, em vez de remover o requisito de imagem. [Fonte](https://arxiv.org/html/2611.02568v1#S3.SS2).
Posso substituir o encosto de uma cadeira mantendo o resto?
Isto ilustra o fluxo de trabalho pretendido de edição local: selecionar a região do encosto, fornecer orientações e sintetizar os seus tokens, reutilizando tokens de contexto. A preservação exata aplica-se aos tokens latentes; não deve ser interpretada como uma garantia de que todos os vértices descodificados permanecem idênticos. [Fonte](https://arxiv.org/html/2611.02568v1#S3.SS3).
Posso implementar o SeMo3D localmente agora?
À data de 6 de novembro de 2026, os pesos do modelo e o código completo de inferência, treino e avaliação continuam a ser marcos de lançamento por verificar. O artigo público e as demonstrações permitem uma avaliação técnica, mas o repositório ainda não fornece a stack completa de implementação local. [Source](https://github.com/XiaokunSun/SeMo3D#-todo).




