Frontier3DBench: Avaliação comparativa de agentes de programação para criação 3D em objetos, cenas & mundos abertos
O Frontier3DBench avalia a capacidade dos agentes de programação para criar projetos 3D editáveis e executáveis ao nível de objetos, cenas e mundos abertos interativos.
Artigo original: Frontier3DBench: Benchmarking Coding Agents for 3D Creation across Objects, Scenes, and Interactive Open Worlds (6 de novembro de 2026; v1).
Destaques e resultados
A Frontier3DBench questiona se os agentes de programação conseguem fornecer projetos 3D editáveis e executáveis abrangendo objetos, cenas e mundos interativos. Para as equipas que escolhem um fluxo de trabalho de autoria com IA, o seu contributo é um quadro de avaliação comum: 145 tarefas distribuídas por nove famílias, incluindo 65 tarefas de objetos no Blender, 65 tarefas de cenas no Blender e 15 tarefas de mundos no Unreal Engine. As entradas incluem instruções, imagens de referência, fotografias e cenas existentes.
Os autores avaliam 11 configurações de modelo–harness. O GPT-6.1-sol com Codex lidera no conjunto geral, com 66.02/100; o GPT-6-astra com Codex lidera nos mundos interativos, com 61.28. Todas as configurações têm um desempenho pior na reconstrução a partir de referências do que na geração de objetos e cenas orientada por texto. Entre 165 submissões de mundos, os mecanismos locais obtêm uma média de 83.08, a folga das peças móveis 20.82 e os fluxos de trabalho com estado 30.26. Estas são pontuações de componentes, não percentagens de mundos concluídos com êxito.
Um estudo com avaliadores humanos fornece uma calibração limitada: oito avaliadores classificam quatro candidatos em cada um de 45 itens de objetos/cenas condicionados por referências. As pontuações automáticas atingem um tau-b de Kendall médio de 0.727 e 79.2% de concordância quanto ao vencedor, mas apenas 44.7% de concordância quanto à classificação completa. Isto não valida todas as famílias de tarefas nem todos os comportamentos dos mundos. Consulte as experiências.
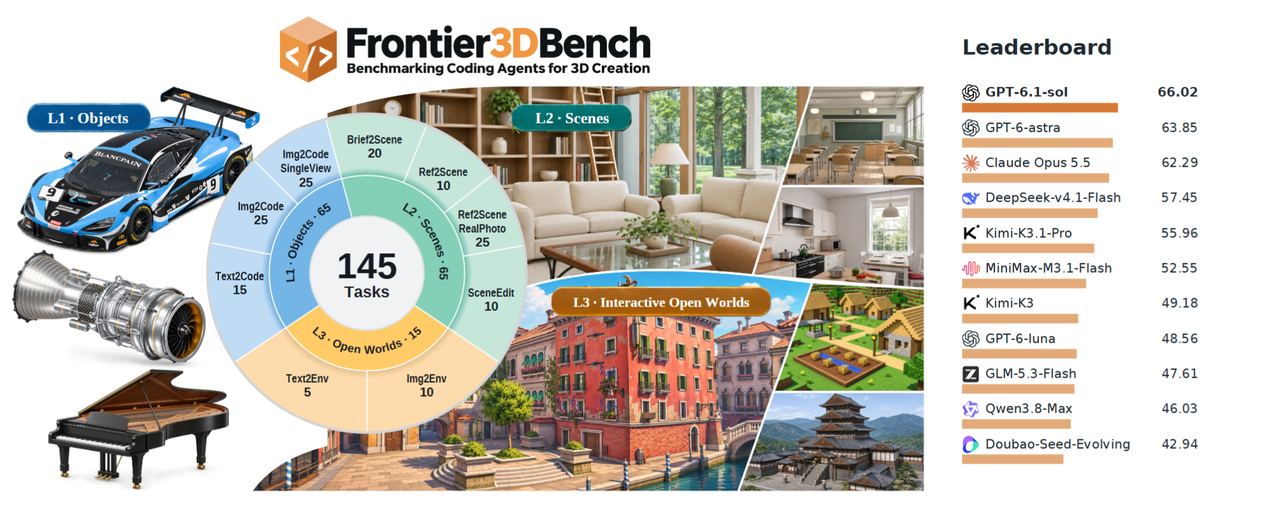
Como funciona a avaliação
O agente recebe um contrato de tarefa: a geometria e o aspeto exigidos, imagens de referência quando aplicável e recursos iniciais para edição. As tarefas de mundos definem ainda entidades, estados iniciais, operações permitidas e pré-requisitos. O agente escreve e executa código de construção e, em seguida, envia um projeto nativo do Blender ou do Unreal, juntamente com as exportações exigidas. Os ficheiros de avaliação permanecem fora do seu espaço de trabalho.
No orquestrador disponibilizado, as verificações públicas de execução podem desencadear reparações, mas o agente recebe erros, não pontuações privadas. O código-fonte aceite é congelado e submetido a hash antes da avaliação. Avaliadores separados voltam a executar o programa, inspecionam a geometria nativa, renderizam vistas e avaliam o cumprimento da tarefa. O artigo utiliza o Blender 5.2.1 e o Unreal Engine 5.8.3; a geração L1/L2 permite até seis tentativas no espaço de 32 horas. Estes são limites máximos de orçamento, não tempos de conclusão medidos.
A pontuação varia consoante a tarefa. A reconstrução a partir de referências combina 50% de similaridade de imagem, 20% de localização projetada do objeto, 20% de avaliação visual e 10% de detalhe. A similaridade de imagem mede a estrutura, os contornos, a cor e a tonalidade; a localização compara as caixas dos objetos e penaliza instâncias em falta ou adicionais. O GPT-6-astra, com esforço médio, avalia critérios visuais fixos com a identidade do gerador ocultada. As verificações de detalhe utilizam a cobertura multiplicada por um menos o desvio e, em seguida, selecionam a variante de execução/exportação exigida mais fraca. As tarefas L1 comuns inspecionam quatro execuções em formato nativo e GLB; o L2 utiliza quatro variantes nativas.
A edição de cenas mede separadamente a modificação solicitada e a preservação dos elementos envolventes protegidos. A avaliação de mundos reconstrói o projeto enviado com um observador independente e testa os efeitos visíveis das ações, as interseções entre peças móveis, o movimento efetivo das personagens e o estado persistente. Os fluxos de trabalho contínuos proíbem a teletransportação e as reposições. Por isso, abrir uma porta isoladamente não pode substituir a conclusão de um percurso que exija alcançá-la, destrancá-la e atravessá-la.
As pontuações dos mundos ponderam a qualidade visual, a fidelidade à tarefa, a disposição e a interação em 60/20/5/15. O total final do benchmark pondera L1/L2/L3 em 30/30/40. O contrato de pontuação distingue defeitos confirmados dos candidatos de evidências técnicas em falta: uma falha de API ou de medição não deve transformar-se silenciosamente num zero.
Aplicações e desafios em aberto
O benchmark apoia a seleção de fluxos de trabalho com agentes de programação e o diagnóstico de saber se as falhas dizem respeito ao aspeto, à geometria, à edição ou ao comportamento. O seu repositório público inclui entradas de tarefas, código de geração/avaliação e contratos de pontuação; o software do benchmark utiliza Apache-2.0, enquanto os recursos das tarefas mantêm as suas próprias licenças. O Blender, o Unreal Engine e o acesso aos modelos requerem configurações separadas.
O artigo identifica dois desafios centrais em aberto: corresponder à geometria e às disposições especificadas e coordenar peças móveis, ações e estados persistentes. Essas são direções de investigação dos autores, não funcionalidades de produto anunciadas. As comparações descrevem configurações completas de modelo–harness e a avaliação visual mantém limitações de calibração; as tarefas fotográficas também não dispõem de uma verdade fundamental 3D nativa universal. Esta análise lê o artigo e a implementação, mas não volta a executar o benchmark.
Perguntas frequentes
O próprio Frontier3DBench é um modelo de geração 3D?
Não. Fornece tarefas e avaliadores para agentes de programação que constroem projetos no Blender e no Unreal. Não introduz um gerador de malhas treinado nem uma nova representação latente 3D.
Porque é que as capturas de ecrã não são suficientes para uma submissão?
O contrato exige artefactos nativos editáveis e comportamento executável. Os avaliadores inspecionam a geometria, renderizam novamente as cenas guardadas e testam as interações, pelo que a aparência, por si só, não pode comprovar a correção.
A pontuação geral mais elevada identifica o melhor agente para todas as tarefas?
Não. Os líderes diferem consoante a família de tarefas, e a pontuação inclui o harness e a configuração de raciocínio. Compare o perfil de tarefa relevante antes de escolher um fluxo de trabalho.




