EasyMocap: Transformando vídeo em movimento humano 3D
EasyMocap é uma caixa de ferramentas desenvolvida pela ZJU3DV para recuperar movimentos humanos em 3D a partir de vídeos RGB usando técnicas sem marcadores. Ele oferece suporte a várias configurações de captura, incluindo configurações com várias câmeras e vídeos monoculares da internet.
Destaques e resultados
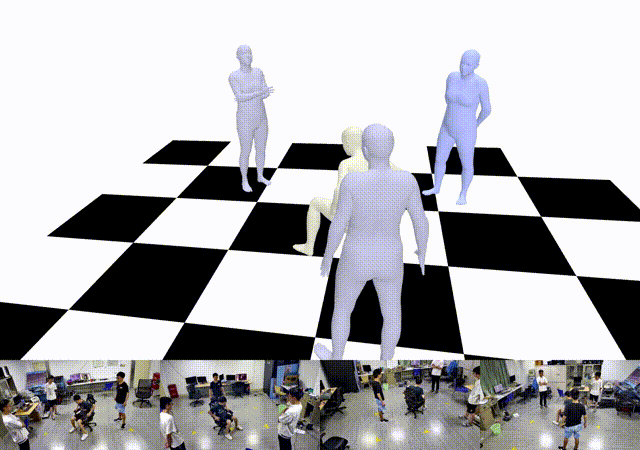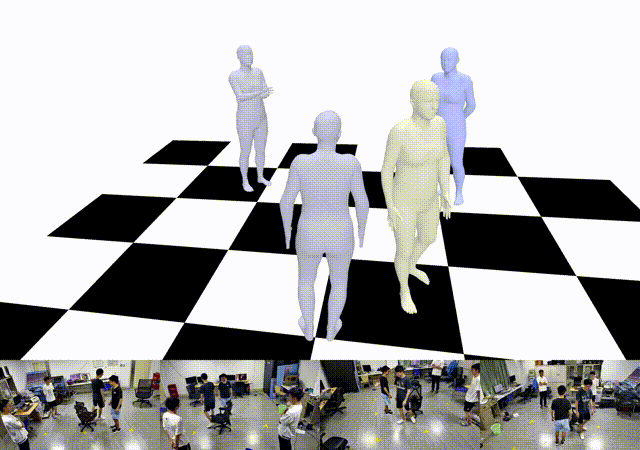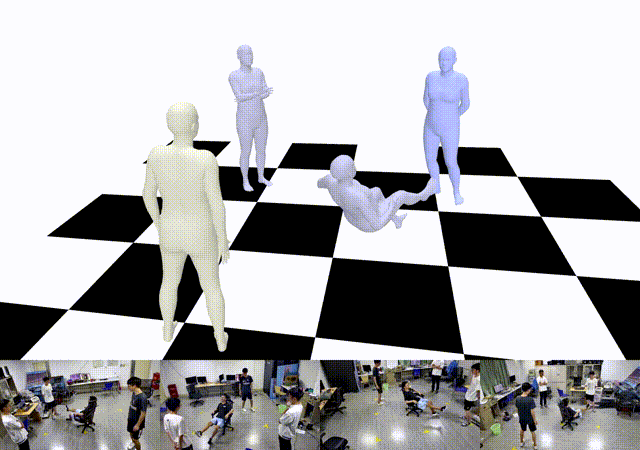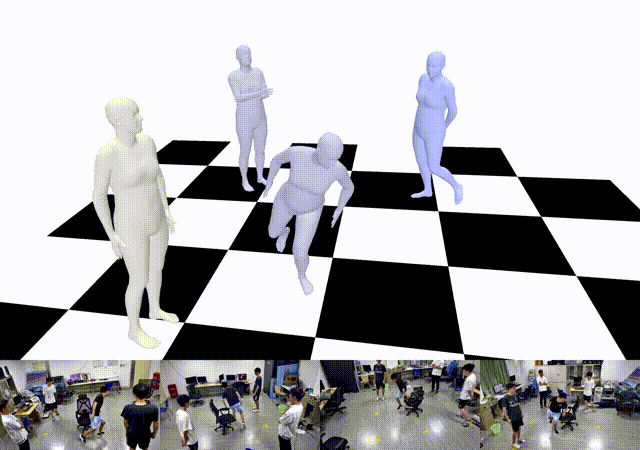
O EasyMocap é a caixa de ferramentas da ZJU3DV para captura de movimento humano sem marcadores a partir de vídeos RGB. Ele combina detectores de pose, geometria de câmera, rastreamento e modelos humanos paramétricos para recuperar esqueletos 3D e movimento corporal. Ele oferece suporte a várias configurações de captura, incluindo gravações multicâmera calibradas, vídeos monoculares da Internet e captura assistida por espelho. Para pesquisadores de animação e visão computacional, seu valor está em um pipeline inspecionável, cujas detecções intermediárias, reconstrução e resultados de ajuste podem ser verificados separadamente. Repositório oficial.
O repositório demonstra o ajuste de corpo, mãos e rosto com SMPL, SMPL+H, SMPL-X e MANO, além de reconstrução de várias pessoas e projetos relacionados de síntese de novas vistas. O conjunto de dados de início rápido contém 800 quadros de 23 câmeras sincronizadas e calibradas. Essas são demonstrações concretas, não uma garantia única de precisão para todos os modos compatíveis. Início rápido.
Uma base de pesquisa, Fast and Robust Multi-Person 3D Pose Estimation from Multiple Views, relata 96,3% de PCP no Campus e 96,9% no Shelf. O PCP mede as partes do corpo estimadas corretamente sob esses protocolos de benchmark. Esses são resultados do método específico daquele artigo, não medições desta versão do EasyMocap nem de seu caminho monocular.
Como funciona
O fluxo multicâmera padrão parte de imagens sincronizadas e da calibração das câmeras, passa por pontos-chave 2D, associação entre vistas quando há várias pessoas, esqueletos 3D triangulados, rastreamento temporal e ajuste em etapas do modelo corporal. A entrada principal de orquestração seleciona arquivos de configuração para reconstrução e ajuste; este é um sistema de estimação modular, com diferentes fluxos para diferentes condições de captura. Ponto de entrada.
Para uma única pessoa, as articulações detectadas recebem pontuações de confiança. As matrizes de projeção das câmeras transformam observações 2D correspondentes em estimativas de articulações 3D. A demonstração multicâmera reprojeta essas estimativas nas câmeras, rejeita observações que excedem seu limite de erro de reprojeção e realiza a triangulação novamente. Esse retorno torna os erros de detecção visíveis antes que uma malha corporal seja ajustada. Portanto, calibração e sincronização são entradas que determinam a qualidade da reconstrução, não etapas opcionais de acabamento. Reconstrução de uma pessoa.
Várias pessoas introduzem um problema de associação de identidades: as detecções em câmeras diferentes precisam pertencer à mesma pessoa. O artigo de pesquisa combina aparência e evidências epipolares com correspondência multicaminho consistente em ciclos. A demonstração do EasyMocap inspecionada é mais específica: sua configuração padrão usa afinidade geométrica baseada em raios e correspondência por limiarização de valores singulares, seguida de verificações de associação e aceitação geométrica. Ela exige pelo menos três vistas de suporte nessa configuração. Portanto, o método completo baseado em aparência do artigo não deve ser atribuído silenciosamente a toda predefinição do repositório. Configuração padrão; Implementação de afinidade.
O ajuste converte medições do esqueleto em uma superfície humana coerente. O pipeline inspecionado estima a forma corporal compartilhada a partir dos comprimentos dos membros, otimiza a rotação e a translação globais e, em seguida, a pose corporal, seguidas pelas mãos ou pela expressão facial quando o modelo selecionado oferece suporte a elas. Uma etapa 2D opcional ajusta adicionalmente as evidências de reprojeção. Perdas ponderadas das articulações, regularização e termos temporais restringem o resultado. Esses são parâmetros explícitos do modelo humano, e não um latente de difusão sendo dessaturado em movimento. Ajuste em etapas.
O fluxo monocular, por sua vez, combina observações 2D com inicialização por CNN e priors do modelo corporal. Ele não tem vistas simultâneas de câmera para triangular, portanto sua ambiguidade de profundidade difere da captura multicâmera. As saídas incluem JSON de articulações 3D por quadro e parâmetros corporais, como poses, forma, rotação global Rh e translação Th. A representação documentada usa V = R X(θ, β) + T; Rh não deve ser copiado cegamente para o campo global_orient do SMPL-X. Contrato de saída.
Aplicações, disponibilidade e direções futuras
O EasyMocap oferece um ponto de partida de pesquisa útil para análise de movimento, animação de avatares e reconstrução humana. Sua saída de captura não é automaticamente um avatar texturizado nem uma animação retargetizada para qualquer personagem. A exportação para BVH é documentada como uma etapa separada usando Blender e recursos SMPL. No commit inspecionado, a Licença de Registro de Projeto do repositório permite uso em pesquisa, educação, avaliação e uso pessoal sem registro, enquanto o uso do projeto por organizações exige registro; as dependências dos modelos corporais têm seus próprios termos. Licença do repositório.
O README ainda classifica a análise conjunta de vários vídeos da Internet mostrando uma ação específica e um exemplo de síntese de vistas de um movimento desafiador como “em breve”. A TODO genérica não fornece um cronograma detalhado, portanto esses itens continuam sendo tarefas inacabadas documentadas, e não promessas de entrega com data. Esta análise lê o commit e6006fd e as pesquisas vinculadas; ela não relata um novo experimento de captura. Status da versão.
Perguntas frequentes
Posso começar com um único vídeo comum?
Sim, uma rota monocular é fornecida. Sua dependência da inicialização e de priors corporais significa que a oclusão e a profundidade incerta continuam sendo problemas diferentes da captura multivista calibrada.
Isso animará imediatamente meu personagem existente?
Ele produz principalmente esqueletos e parâmetros da família SMPL. A exportação e o retargeting específico de cada personagem são etapas adicionais de integração; ajustar um modelo humano não estabelece um mapeamento para cada rig de personagem.
Como devo diagnosticar uma reconstrução inadequada?
Inspecione a calibração e a sincronização das câmeras, as detecções 2D, as identidades entre vistas e as sobreposições de reprojeção antes de ajustar o encaixe corporal. A caixa de ferramentas expõe essas etapas para que um erro de correspondência a montante não seja confundido com um problema de ajuste da malha.[](https://)
Artigos relacionados

CoDimRecon: Reconstrução Agêntica de Cenas 3D Prontas para Simulação com Geometria Deformável
 v2fun · 11 de nov. de 2026

UltraTex: Desencadeando a Difusão Multivista em 2K para Texturização 3D
 V2Fun AI Lab · 9 de nov. de 2026

Fluxo de trabalho de animação 3D com IA para protótipos iniciais de jogos jogáveis
 Tammy · 11 de ago. de 2026