UltraTex: Wykorzystanie dyfuzji wielowidokowej 2K do teksturowania 3D
UltraTex to projekt SIGGRAPH Asia 2026, który wykorzystuje modele dyfuzji wielowidokowej do generowania tekstur wysokiej rozdzielczości (2K) dla siatek 3D na podstawie obrazów referencyjnych, przezwyciężając ograniczenia niższych rozdzielczości, takich jak 512 lub 768.

Najważniejsze informacje i wyniki: więcej szczegółów, mniej zmarnowanych obliczeń
Oryginalny artykuł: UltraTex: Unleashing 2K Multi-View Diffusion for 3D Texturing
UltraTex generuje szczegółowe tekstury dla istniejącej siatki 3D na podstawie obrazu referencyjnego. Zaprezentowany jako projekt SIGGRAPH Asia 2026, rozwiązuje powszechne wąskie gardło: teksturowanie wielowidokowe w rozdzielczości 512 lub 768 traci drobne wzory i szczegóły powierzchni. UltraTex zwiększa rozdzielczość generowanych widoków do 2048 × 2048, koncentrując obliczenia na pierwszym planie obiektu. Jego głównym osiągnięciem jest praktyczne zastosowanie wysokorozdzielczej dyfuzji wielowidokowej dzięki skoordynowanym zmianom w przetwarzaniu tokenów, mechanizmie uwagi i dekodowaniu. Oficjalny projekt.
Na 100 obiektach TexVerse odłożonych do testów UltraTex odnotowuje niecieniowane LPIPS na poziomie 0.082 w porównaniu z 0.138 dla LumiTex, przy czym niższa wartość oznacza większą zgodność percepcyjną. Dla pojedynczego H200 autorzy podają przyspieszenie treningu na poziomie 20.6–91.1× oraz wnioskowania na poziomie 22.3–74.6× względem gęstego punktu odniesienia przy zajętości pierwszego planu wynoszącej 10–30% i zachowaniu 20% bloków uwagi. Są to wyniki zależne od konfiguracji, a nie stałe przyspieszenie dla każdego zasobu ani kompletnego procesu produkcyjnego. Artykuł, eksperymenty.
Jak to działa: od obrazu referencyjnego do oteksturowanej powierzchni
Potok najpierw renderuje sześć map normalnych z wejściowej siatki: cztery widoki boczne, widok z góry i widok z dołu. VAE koduje wskazówki geometryczne i obraz referencyjny do latentów. Wstępnie wytrenowany transformer dyfuzyjny FLUX generuje następnie sześć odpowiadających sobie widoków tekstury za pomocą dopasowania przepływu; pełny potok opisany w artykule ponownie rzutuje je na siatkę. Przy 2K sześć widoków docelowych, sześć widoków geometrii i jeden obraz referencyjny składają się na 212,992 tokenów obrazu, co wyjaśnia, dlaczego gęste przetwarzanie staje się kosztowne. Potok; wyjaśnienie kosztu tokenów.
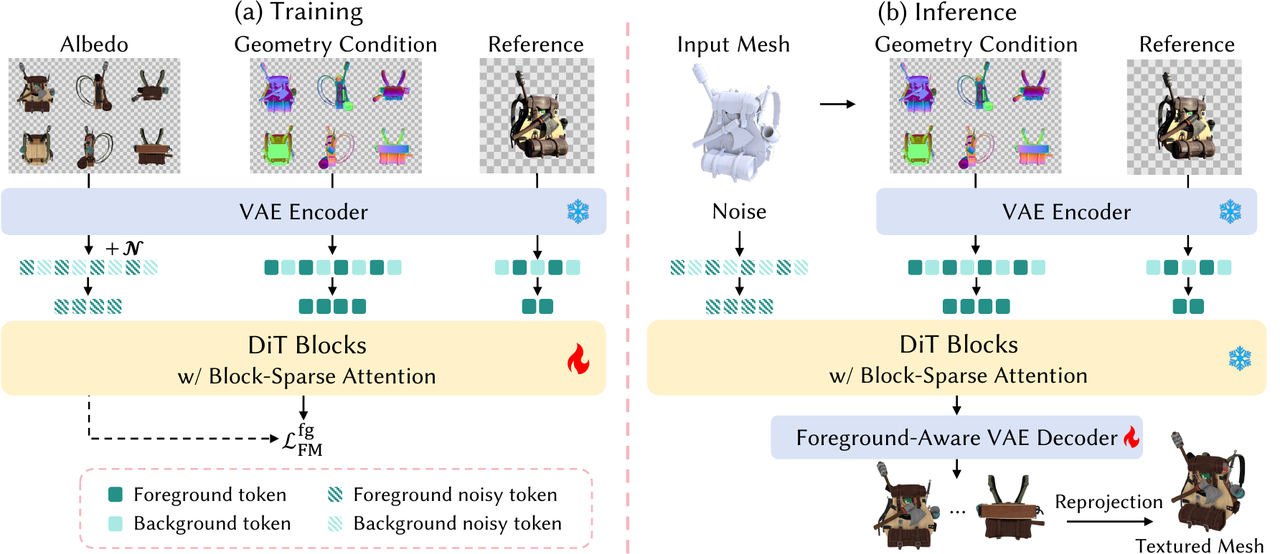
Usuwanie tokenów tła usuwa tokeny obrazu znajdujące się poza obiektem przed wejściem do bloków transformera. Maski identyfikują zachowane pozycje, a odpowiadające im oryginalne obrotowe osadzenia pozycyjne (RoPE) pozostają przypisane. Sekwencja staje się krótsza bez utraty współrzędnych przestrzennych. Oszczędza to obliczenia w całym szkielecie sieci, w tym w warstwach feed-forward. W udostępnionym samplerze aktualizacje Eulera modyfikują wyłącznie wybrane pozycje pierwszego planu; szum tła pozostaje nietknięty aż do przygotowania do dekodowania. Wybór tokenów; implementacja próbkowania.
Rzadkie blokowo mechanizmy uwagi zmniejszają koszt interakcji między pozostałymi tokenami. Implementacja uśrednia cechy zapytań i kluczy w blokach, szacuje ich znaczenie i wybiera bloki kluczy o najwyższych wynikach dla każdego bloku zapytań. Mechanizm uwagi korzysta następnie z oryginalnych cech tokenów wewnątrz wybranych bloków. Konfiguracja FLUX.1 zachowuje 20% bloków kluczy: pozwala to uniknąć wielu interakcji bez zmniejszania rozdzielczości obrazu. Wybór bloków; konfiguracja uwagi.
Dekodowanie VAE uwzględniające pierwszy plan odnosi się do skutków pominięcia odszumiania tła. Połączenie czystego pierwszego planu z zaszumionym tłem może zakłócić rekonstrukcję. UltraTex zastępuje tło latentem zakodowanym z jednolicie czarnego obrazu, a następnie używa dekodera dostosowanego do takiego obrazu złożonego. Enkoder pozostaje zamrożony; trening dekodera minimalizuje błąd rekonstrukcji wyłącznie na pikselach pierwszego planu. Po dekodowaniu udostępnione skrypty wnioskowania zapisują obrazy wielowidokowe. Zintegrowanie tych wyników z zasobem siatki nadal wymaga ponownego rzutowania lub wypalania. Trening dekodera; wyniki wnioskowania.
Podstawą danych jest G-buffer TexVerse. Jego publiczne wydanie obejmuje 351,847 zasobów BSDF, podczas gdy UltraTex korzysta z przefiltrowanego podzbioru treningowego zawierającego 268,365 zasobów. Renderingi dostarczają normalnych, współrzędnych, albedo i dostępnych kanałów materiału w rozdzielczości do 4096 × 4096. Tę rozdzielczość danych należy odróżnić od zademonstrowanej przez UltraTex generacji w 2K. Opis zbioru danych.
Zastosowania, dostępność i przyszłe kierunki
UltraTex jest przeznaczony do etapu tworzenia wyglądu zasobu: dostarczania szczegółowych tekstur powierzchni dla istniejącej geometrii postaci, rekwizytu i obiektu. Domyślnym wynikiem jest albedo, reprezentujące kolor powierzchni bez wstępnie wypalonego oświetlenia. Obecne repozytorium udostępnia również gałąź FLUX.2 dla metaliczności i szorstkości z oddzielnymi wagami LoRA. To dostępne rozszerzenie należy odróżnić od testu albedo w głównym artykule, w którym UltraTex renderuje obrazy ze stałymi wartościami szorstkości i metaliczności. Dostępne wyniki materiałowe; ustawienia ewaluacji.
Na dzień 6 listopada 2026 r. kod treningu i wnioskowania oraz instrukcje pobierania wag są publicznie dostępne. Repozytorium obsługuje warianty FLUX.1-dev i FLUX.2-Klein, z których każdy wymaga odpowiednich plików szkieletu, LoRA i dekodera. Testowane środowisko korzysta z Python 3.12, CUDA 12.4 i PyTorch 2.5.1. Ten artykuł omawia publikację i implementację; nie twierdzi, że przedstawia niezależne odtworzenie jakości lub szybkości. Oficjalne repozytorium.
Autorzy wskazują na trudności z bardzo powtarzalnymi teksturami oraz utratę szczegółów wynikającą ze skompresowanej reprezentacji wstępnie wytrenowanego VAE. Ich deklarowanym kierunkiem skalowania do 4K lub 8K jest przeprojektowanie bazowych modeli DiT–VAE, które natywnie obsługiwałyby te rozdzielczości, ponieważ istniejący szkielet FLUX jest lepiej dopasowany do wejść o rozdzielczości około 1K–2K. Są to nadal ograniczenia i kierunki badań, a nie udostępnione możliwości generowania w wysokiej rozdzielczości. Artykuł, ograniczenia.
Najczęściej zadawane pytania
Czy potrzebuję siatki 3D przed użyciem UltraTex?
Tak. UltraTex teksturuje istniejącą geometrię, korzystając z obrazu referencyjnego i widoków normalnych wyprowadzonych z siatki. Pasuje do etapu opracowywania wyglądu po modelowaniu lub generowaniu geometrii; nie rekonstruuje kompletnej siatki wyłącznie na podstawie obrazu referencyjnego. [Źródło](https://arxiv.org/html/2609.23169v1#S3).
Czy inferencja bezpośrednio dostarcza gotowy zasób PBR?
Wydane skrypty zapisują obrazy z wielu widoków, które nadal wymagają reprojekcji lub wypalenia na siatce. Albedo jest domyślnym wynikiem; rozszerzenie FLUX.2 dotyczące metaliczności–szorstkości używa osobnych wag. Tego rozszerzenia nie należy mylić z główną oceną albedo w artykule. [Źródło](https://github.com/yiboz2001/UltraTex#inference).
Czy każdy zasób uzyska zgłoszone przyspieszenie?
Nie. Zgłoszone przyspieszenie zmierzono na H200 względem gęstej bazy odniesienia przy określonym poziomie zajętości pierwszego planu i ustawieniach retencji uwagi. Pokrycie obiektów, sprzęt i konfiguracja wpływają na oszczędności; podane wartości nie gwarantują równoważnego przyspieszenia w całym potoku przetwarzania zasobów. [Źródło](https://arxiv.org/html/2609.23169v1#S4).


