SeMo3D: Ujednolicenie generowania, edycji i uzupełniania modeli 3D za pomocą selektywnego modelowania
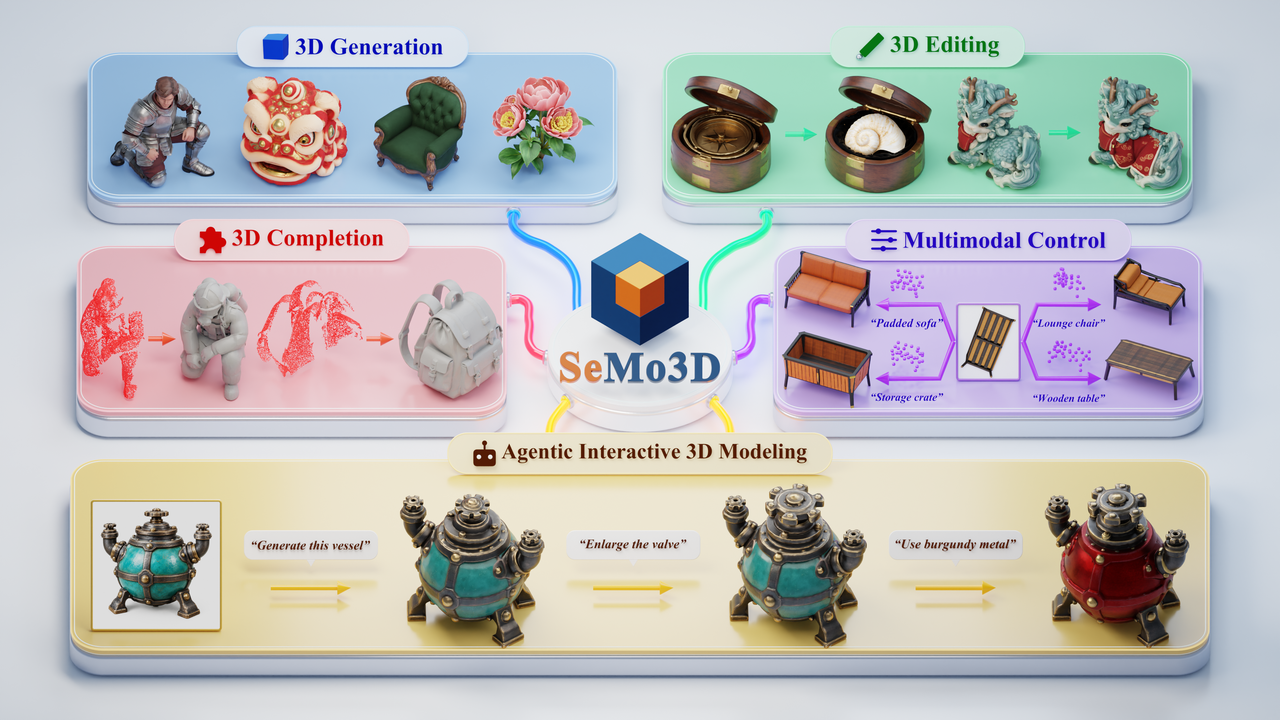
SeMo3D wprowadza ujednolicone podejście do generowania, lokalnej edycji i uzupełniania modeli 3D z wykorzystaniem selektywnego modelowania.

Najważniejsze informacje i wyniki: zmiana tego, co ma znaczenie
Oryginalny artykuł: SeMo3D: Unifying 3D Generation, Editing, and Completion via Selective Modeling
SeMo3D, przedstawiony przez naukowców z Uniwersytetu Nankińskiego, łączy generowanie 3D, lokalną edycję i uzupełnianie w jedną platformę. Dla zespołów zajmujących się tworzeniem zasobów z wykorzystaniem AI jego najważniejszą obietnicą jest ciągłość: utworzenie obiektu, zmiana wybranego regionu lub odtworzenie brakującego fragmentu przy zachowaniu istniejącego kontekstu. Nazwa oznacza Selective Modeling, czyli strategię, w której region przeznaczony do syntezy stanowi wspólny interfejs tych zadań. Oficjalne repozytorium.
Na zbiorze Toys4K autorzy podają geometryczną odległość Chamfera równą 0.0118 w porównaniu z 0.0330 dla TRELLIS.2 (niższa wartość jest lepsza). Zachowanie podczas edycji osiąga 37.39 dB PSNR w porównaniu z 31.55 dB dla VoxHammera. Wynik F-score dla uzupełniania osiąga 0.541 w porównaniu z 0.412 dla HY3D-Omni przy dodatkowym naprowadzaniu punktami. Obsługiwane dane wejściowe różnią się między metodami, a wskazówki punktowe pochodzą z danych referencyjnych; porównania te nie izolują zysków wynikających z architektury. Artykuł, tabele 1–3.
Jak to działa: wybór, synteza, zachowanie
Kluczowa abstrakcja dzieli zasób na wybrany region S i zachowany kontekst C. Generowanie wybiera wszystko; edycja wybiera obszar docelowy; uzupełnianie wybiera to, czego brakuje. W przypadku krzesła ten sam interfejs może utworzyć całe krzesło, wymienić jego oparcie lub odtworzyć brakującą nogę. Są to przykładowe zastosowania definicji zadania. Model uczy się wspólnego problemu syntezy regionalnej, zamiast wymagać osobnej, specyficznej dla zadania procedury treningowej. Przegląd repozytorium.
SeMo3D dostraja trzy modele przepływu TRELLIS.2 na zbiorze Trellis-500K i ponownie wykorzystuje jego SC-VAE. Rzadka struktura przewiduje zajętość na latentnej siatce 16³; kształt i tekstura działają w zajętych pozycjach na siatce 32³, generując geometrię i materiały PBR. Maska jest przekazywana między etapami. Zatem unifikacja zadań nadal wykorzystuje trzy modele specyficzne dla poszczególnych etapów. Artykuł, szczegóły metody i treningu.
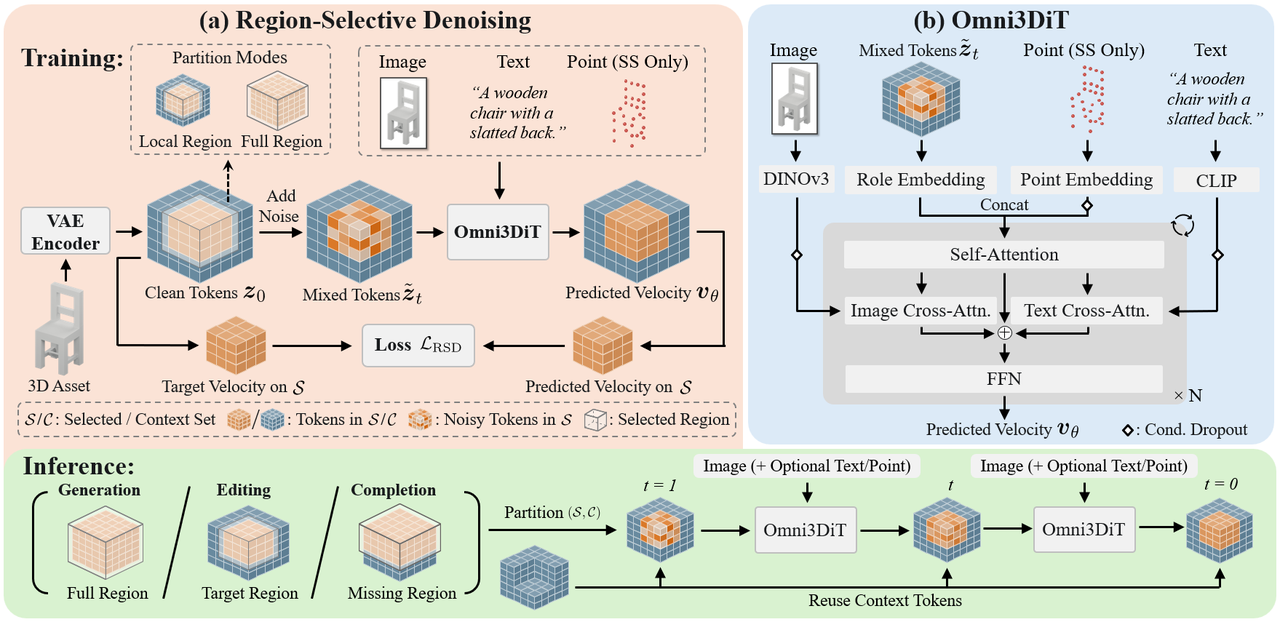
Selektywne odszumianie regionów tworzy przykłady treningowe ze zwykłych zasobów. Losowy region otrzymuje szum, podczas gdy jego otoczenie pozostaje czyste; tylko predykcje w tym regionie przyczyniają się do funkcji straty. Trening obejmuje zakres od lokalnych prostokątów po kompletne zasoby, dzięki czemu nie są potrzebne sparowane zbiory danych przed i po edycji ani uzupełnianiu. Podczas wnioskowania wybrane tokeny zaczynają od szumu i ewoluują pod wpływem wskazówek, a tokeny oryginalnego kontekstu są ponownie wykorzystywane w każdym kroku. Model może dzięki temu korzystać z całego obiektu bez ponownej syntezy całości. Oficjalne wyjaśnienie metody.
Omni3DiT sprawia, że takie mieszane dane wejściowe stają się zrozumiałe. Osadzenia ról identyfikują wybrane tokeny i tokeny kontekstu. Równoległe gałęzie cross-attention wprowadzają cechy obrazów DINOv3 i cechy tekstowe CLIP; tokeny punktów trafiają do self-attention na etapie rzadkiej struktury. Obrazy kierują wyglądem, tekst dodaje intencję semantyczną, a punkty ograniczają układ przestrzenny. Usuwanie warunkowania zmienia podczas treningu dostępne wskazówki, zachęcając model do wykorzystywania uzupełniających się sygnałów. Oficjalny diagram architektury.
Obraz pozostaje wymagany. Generowanie wykorzystuje 12 kroków Eulera na etap; edycja/uzupełnianie wykorzystuje 50 kroków dla struktury oraz 12 dla kształtu i tekstury. Ścisłe zachowanie dotyczy tokenów latentnych, a niekoniecznie każdego zdekodowanego wierzchołka. Artykuł i dodatek dotyczący wnioskowania.
Zastosowania i dalszy rozwój
Praktyczna możliwość dotyczy pracy iteracyjnej: tworzenia wariantów rekwizytów, naprawiania niekompletnych materiałów referencyjnych i udoskonalania zasobów za pomocą kolejnych instrukcji. Oficjalny projekt demonstruje również przepływy pracy agentów, którzy przygotowują obrazy referencyjne, identyfikują regiony edycji i wywołują SeMo3D. Sugeruje to użyteczny podział obowiązków: agent przekłada intencję na żądanie modelowania, a model 3D obsługuje syntezę regionalną. Interaktywne demonstracje projektu.
Gotowość pozostaje ograniczona. Według stanu na 6 listopada 2026 r. oficjalne repozytorium zawiera dokumentację i materiały demonstracyjne; wagi oraz kod treningu, wnioskowania i ewaluacji nie zostały jeszcze udostępnione. Licencja MIT nie określa warunków licencyjnych przyszłych wag. Ten artykuł omawia pracę i dostępne repozytorium, nie twierdząc, że przedstawia niezależną reprodukcję. Lista kontrolna wydania.
Autorzy wskazują dwa kierunki badań. Reprezentacje 3D o wyższej wierności mogłyby lepiej odwzorowywać cienkie struktury, takie jak liście palm, z którymi obecne latentne struktury mają trudności. Silniejsze enkodery wizji i języka mogłyby poprawić rozumienie złożonych promptów kompozycyjnych; artykuł pokazuje, że pomarańczowe owoce stają się pomarańczową teksturą, a nie oddzielnymi obiektami. Ograniczenia i przyszłe prace. Pozostałe etapy wydania projektu obejmują wagi modelu w Hugging Face oraz kompletny kod wnioskowania, treningu i ewaluacji. Oficjalna lista TODO.
Najczęściej zadawane pytania
Czy SeMo3D może wygenerować lub edytować zasób wyłącznie na podstawie tekstu?
Nie. Artykuł wymaga wskazówek obrazowych; tekst i nieliczne punkty są opcjonalnymi dodatkowymi warunkami. Edycja również wymaga wybranego regionu i kontekstu źródłowego. Demonstracje agenta w języku naturalnym obejmują przygotowanie obrazu, a nie usunięcie wymogu obrazu. [Źródło](https://arxiv.org/html/2611.02568v1#S3.SS2).
Czy mogę wymienić oparcie krzesła, zachowując resztę?
To ilustruje zamierzony przepływ pracy lokalnej edycji: wybierz obszar oparcia, podaj wskazówki i wygeneruj jego tokeny, ponownie wykorzystując tokeny kontekstu. Dokładne zachowanie dotyczy tokenów latentnych; nie należy tego odczytywać jako gwarancji, że każdy zdekodowany wierzchołek pozostanie identyczny. [Źródło](https://arxiv.org/html/2611.02568v1#S3.SS3).
Czy mogę teraz wdrożyć SeMo3D lokalnie?
Stan na 6 listopada 2026 r.: wagi modelu oraz kompletny kod wnioskowania, trenowania i ewaluacji nadal pozostają niezrealizowanymi punktami wydania. Publicznie dostępna publikacja i demonstracje umożliwiają ocenę techniczną, ale repozytorium nie udostępnia jeszcze kompletnego stosu do wdrażania lokalnego. [Źródło](https://github.com/XiaokunSun/SeMo3D#-todo).




