Ling-3.2-flash: Od wizualnych materiałów referencyjnych do przepływów pracy 3D
Ling-3.2-flash to multimodalny model bazowy, który przekształca odniesienia wizualne w praktyczne skrypty na potrzeby przepływów pracy 3D, umożliwiając iteracyjne sprawdzanie i udoskonalanie wyrenderowanych rezultatów.

Najważniejsze informacje i dowody
Ling-3.2-flash to multimodalny model bazowy Ant Ling służący do interpretowania obrazów, tekstu i wideo oraz wykonywania zadań za pomocą narzędzi. Dla twórców 3D interesującą demonstracją jest przepływ pracy, który przekształca wizualny materiał referencyjny w skrypty i wielokrotnie sprawdza ich wyrenderowane rezultaty. Publicznie dostępne dowody dotyczą tworzenia i poprawiania treści wspomaganych przez model; nie potwierdzają istnienia dedykowanej sieci przekształcającej obraz w siatkę.
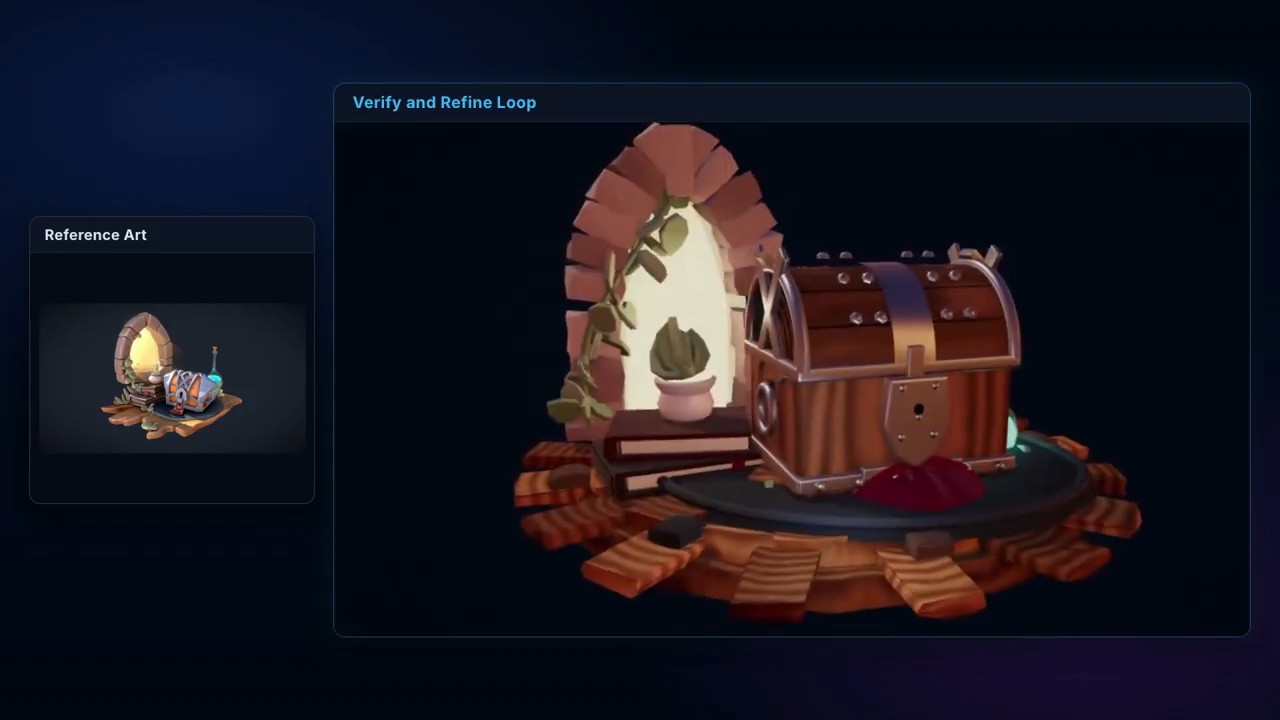
Źródło wideo: Ant Ling — sceny 3D na podstawie referencji 2D.
Oficjalna specyfikacja opisuje model typu mixture-of-experts z łączną liczbą 560 miliardów parametrów, z czego około 25 miliardów jest aktywowanych dla każdego tokenu, oraz z oknem kontekstowym obejmującym do miliona tokenów. Wydanie kładzie nacisk na złożone rozumienie wizualne, długotrwałych agentów multimodalnych oraz rozumienie i interakcję w 3D.
Ant Ling podaje wyniki 92.21 w OmniDocBench 1.5, 43.71 w ZEROBench (Sub) i 85.86 w Vision2Web, w porównaniu odpowiednio z 90.56, 39.52 i 80.20 dla modelu porównawczego Opus 5 max. Są to wyniki podane przez dostawcę dla tych ewaluacji. Nie mierzą one dokładności geometrii 3D, użyteczności zasobów ani czasu modelowania od początku do końca. Analizowane wydanie dostarcza demonstracji, a nie standaryzowanego benchmarku rekonstrukcji 3D.
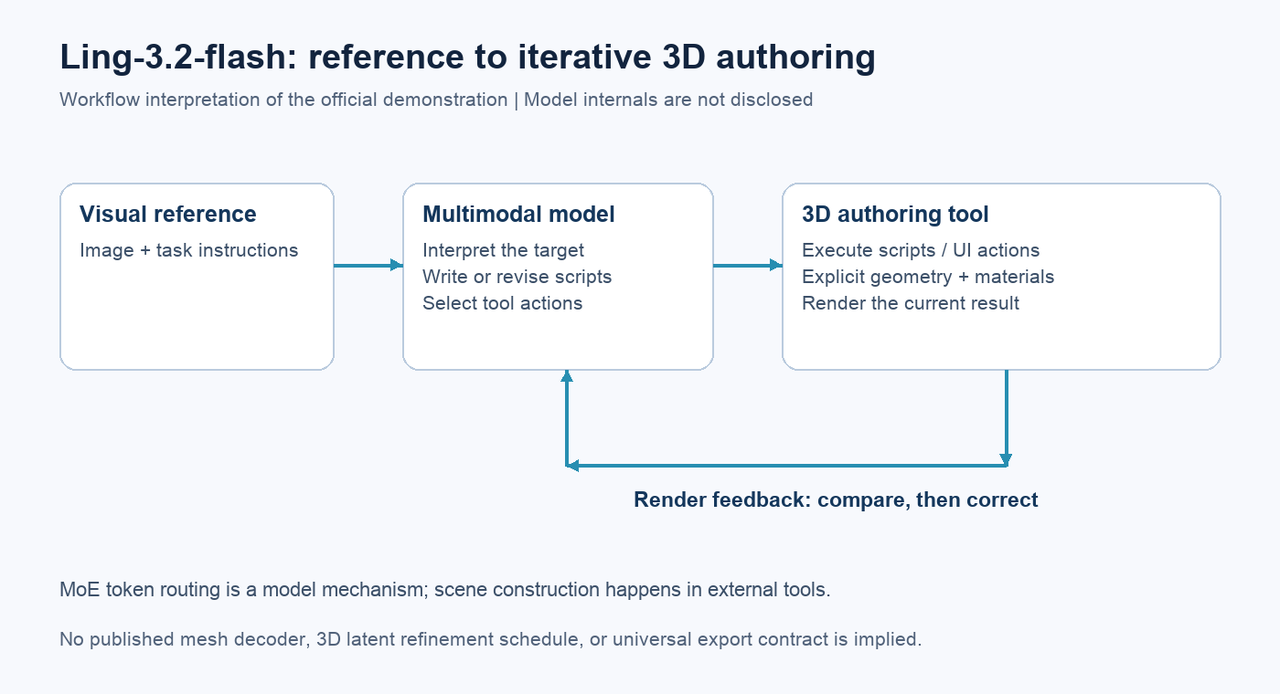
Jak działa przepływ pracy 3D
Oficjalny przykład 3D rozpoczyna się od referencji 2D i wykorzystuje skrypty do odtwarzania zasobów z gier lub symulacji. Model analizuje renderingi bez interfejsu materiałowych sfer, porównuje chropowatość, efekty map normalnych i szczegóły wypukłości, a następnie poprawia skrypty. Na poziomie przepływu pracy pętla obejmuje interpretację referencji, konstruowanie kodu, wykonanie, inspekcję wizualną i korektę. Geometria i materiały znajdują się w scenie wygenerowanej przez narzędzie; model wykorzystuje obrazy tej sceny jako informację zwrotną.
Rozdziela to dwie reprezentacje, które łatwo pomylić. Model neuronowy przetwarza kontekst multimodalny, podczas gdy zewnętrzne narzędzie do tworzenia treści utrzymuje jawne obiekty sceny, parametry materiałów i wykonywalny kod. Zademonstrowane edycje dotyczą skryptów i stanu narzędzia. Wydanie nie ujawnia siatki latentnej 3D, dekodera tokenów siatki, harmonogramu udoskonalania dyfuzyjnego ani celu treningowego geometrii, więc tych mechanizmów nie można wywnioskować z wideo.
Ujawniony mechanizm MoE dotyczy obliczeń wewnątrz modelu językowego: routing tokenów aktywuje wybrane podsieci ekspertów zamiast całej puli parametrów na każdym kroku. Nie oznacza to, że każdy ekspert odpowiada części 3D. Podobnie limit kontekstu wynoszący milion tokenów oznacza pojemność pozwalającą utrzymywać informacje o zadaniu, a nie gwarancję, że długa sesja modelowania pozostanie dokładna.
Inny oficjalny przykład pokazuje interakcję z Blenderem za pomocą działań w interfejsie i zmian parametrów, a kolejny przekształca rysunki inżynieryjne w treści internetowe 3D. Pokazują one alternatywne interfejsy narzędzi, a nie dowód, że każdy zasób przechodzi przez jeden stały potok. Materiały publiczne nie określają odtwarzalnego środowiska agenta 3D, budżetu iteracji, reguły zatrzymania ani jednolitego formatu eksportu. Zbudowanie porównywalnej integracji wymaga zatem dostarczenia narzędzi wykonawczych oraz przekazywania agentowi ich renderingów lub błędów.
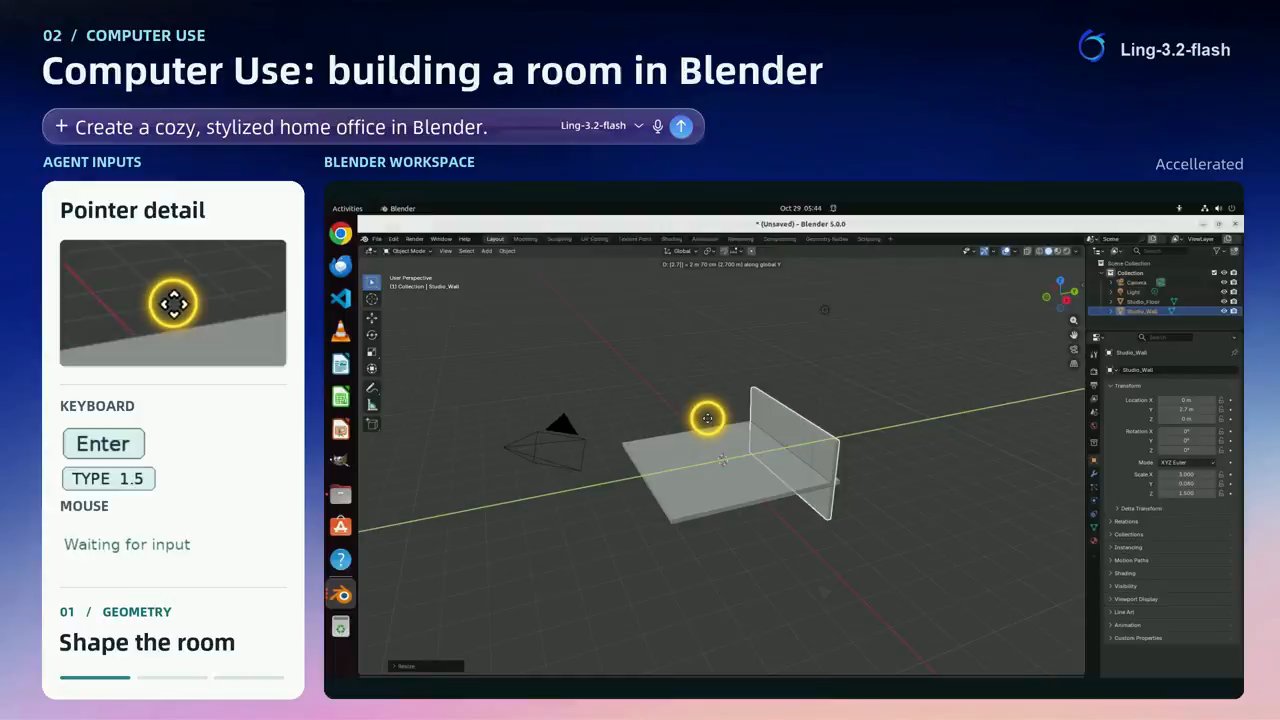
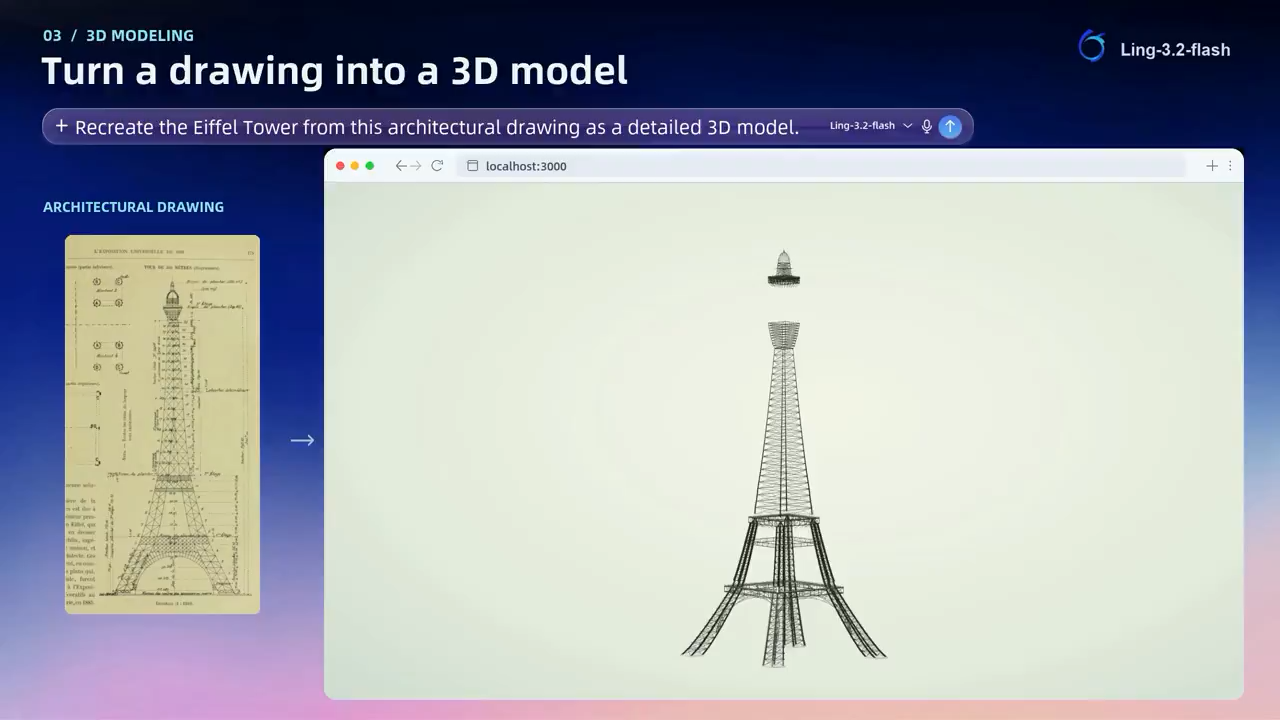
Źródło wideo: Ant Ling — projektowanie frontendów i profesjonalne narzędzia. Przykłady te ilustrują przepływy pracy zgłoszone przez autorów, a nie niezależne testy dokładności.
Zastosowania, dostęp i ograniczenia
Demonstracje są istotne dla prototypowania wizualnego, iteracji materiałów i asystentów obsługujących istniejące oprogramowanie 3D. Ich praktyczna atrakcyjność polega na tym, że referencja może kierować kolejnymi zmianami sceny, zamiast służyć tylko jednorazowemu opisowi tekstowemu. Jakość zasobów, możliwość ich edycji i dostępne formaty eksportu nadal zależą od wybranych narzędzi i zadania.
Oficjalna platforma oferuje dostęp przez czat oraz dokumentację API z interfejsami żądań zgodnymi z OpenAI i Anthropic. Interfejsy te zapewniają dostęp do modelu; działająca integracja z Blenderem pozostaje odrębną kwestią. Analizowane wydanie 3.2 nie udostępnia otwartych wag, samodzielnego opracowania technicznego ani źródła przepływu pracy demonstracji 3D. Wcześniejszych otwartych wydań Ling nie należy traktować jako implementacji wersji 3.2.
W analizowanych oficjalnych materiałach nie znaleziono konkretnej mapy drogowej 3D dla wersji 3.2 ani listy przyszłych prac. Dlatego ten artykuł opisuje ujawnione mechanizmy i demonstracje bez dodawania proponowanych architektur ani obiecanych możliwości eksportu. Model i demonstracje nie zostały niezależnie uruchomione na potrzeby tej recenzji.
Najczęściej zadawane pytania
Czy bezpośrednie przesłanie jednego obrazu gwarantuje otrzymanie pliku GLB?
Oficjalna demonstracja wykorzystuje przepływ pracy oparty na skrypcie i renderowaniu. Na podstawie przeanalizowanych materiałów nie ustalono stałego endpointu zwracającego GLB ani jednolitego kontraktu dostarczania zasobów.
Czy udoskonalanie odbywa się w opublikowanej przestrzeni latentnej 3D?
Nie ujawniono żadnego takiego mechanizmu. Widoczny proces udoskonalania zmienia skrypty i parametry sceny po przeanalizowaniu informacji zwrotnych z renderowania; wewnętrzna reprezentacja 3D modelu nie jest określona.
Co jest potrzebne do odtworzenia podobnego procesu pracy w Blenderze?
Dostęp do modelu, integracja wykonująca skrypty lub działania w interfejsie użytkownika oraz sposób przekazywania renderów i błędów z powrotem do rozmowy. Dokładne oficjalne środowisko 3D nie jest publicznie udostępniane w przeanalizowanym wydaniu.




