Frontier3DBench: Testowanie agentów programistycznych w tworzeniu obiektów, scen i otwartych światów 3D
Frontier3DBench ocenia zdolność agentów programistycznych do tworzenia edytowalnych i wykonywalnych projektów 3D obejmujących obiekty, sceny i interaktywne otwarte światy.
Oryginalny artykuł: Frontier3DBench: Benchmarking Coding Agents for 3D Creation across Objects, Scenes, and Interactive Open Worlds (6 listopada 2026 r.; v1).
Najważniejsze informacje i wyniki
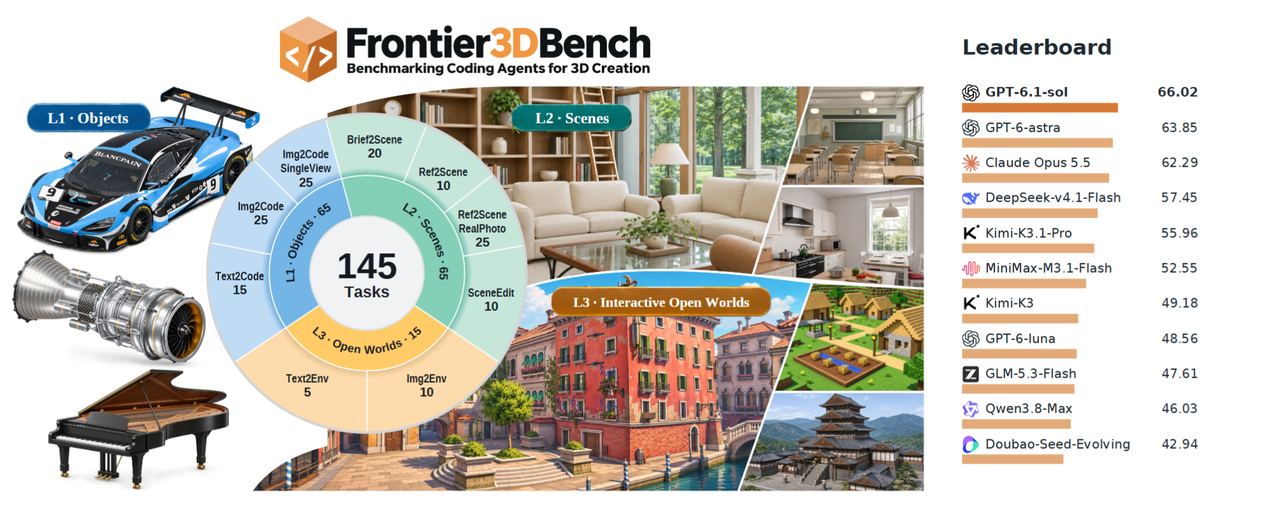
Frontier3DBench bada, czy agenci kodujący potrafią dostarczać edytowalne i wykonywalne projekty 3D obejmujące obiekty, sceny i interaktywne światy. Dla zespołów wybierających proces tworzenia z wykorzystaniem AI jego wkładem jest wspólne ramy oceny: 145 zadań w dziewięciu rodzinach, w tym 65 zadań dotyczących obiektów w Blenderze, 65 zadań dotyczących scen w Blenderze oraz 15 zadań dotyczących światów w Unreal Engine. Dane wejściowe obejmują instrukcje, obrazy referencyjne, fotografie i istniejące sceny.
Autorzy oceniają 11 konfiguracji model–uprząż. GPT-6.1-sol z Codexem prowadzi w klasyfikacji ogólnej z wynikiem 66.02/100; GPT-6-astra z Codexem prowadzi w kategorii interaktywnych światów z wynikiem 61.28. Każda konfiguracja radzi sobie gorzej z rekonstrukcją na podstawie materiału referencyjnego niż z generowaniem obiektów i scen na podstawie tekstu. Wśród 165 zgłoszeń światów mechanizmy lokalne osiągają średnio 83.08, prześwit części ruchomych 20.82, a przepływy pracy ze stanem 30.26. Są to wyniki składowe, a nie wartości procentowe pomyślnie ukończonych światów.
Badanie z udziałem ludzi zapewnia ograniczoną kalibrację: ośmiu oceniających szereguje czterech kandydatów dla każdego z 45 elementów dotyczących obiektów/scen uwarunkowanych materiałem referencyjnym. Wyniki automatyczne osiągają średnie tau-b Kendalla na poziomie 0.727 i 79.2% zgodności co do zwycięzcy, ale tylko 44.7% zgodności co do pełnego rankingu. Nie potwierdza to poprawności każdej rodziny zadań ani zachowania światów. Zob. eksperymenty.
Jak działa ocena
Agent otrzymuje kontrakt zadania: wymaganą geometrię i wygląd, obrazy referencyjne, gdy mają zastosowanie, oraz zasoby początkowe do edycji. Zadania dotyczące światów dodatkowo definiują encje, stany początkowe, dozwolone operacje i warunki wstępne. Agent zapisuje i wykonuje kod konstrukcyjny, a następnie przesyła natywny projekt Blendera lub Unreal wraz z wymaganymi eksportami. Pliki oceny pozostają poza jego obszarem roboczym.
W udostępnionym orkiestratorze publiczne kontrole wykonywania mogą uruchamiać naprawy, ale agent otrzymuje błędy, a nie prywatne wyniki. Zaakceptowane źródło jest zamrażane i haszowane przed oceną. Oddzielni ewaluatorzy ponownie uruchamiają program, sprawdzają natywną geometrię, renderują widoki i oceniają realizację zadania. W artykule wykorzystano Blender 5.2.1 i Unreal Engine 5.8.3; generowanie L1/L2 pozwala na maksymalnie sześć prób w ciągu 32 godzin. Są to górne limity budżetu, a nie zmierzone czasy ukończenia.
Sposób punktacji zmienia się zależnie od zadania. Rekonstrukcja na podstawie materiału referencyjnego łączy wagi: 50% podobieństwa obrazu, 20% lokalizacji obiektu na projekcji, 20% oceny wizualnej i 10% szczegółowości. Podobieństwo obrazu mierzy strukturę, krawędzie, kolor i ton; lokalizacja dopasowuje ramki obiektów oraz nakłada kary za brakujące lub dodatkowe instancje. GPT-6-astra przy średnim poziomie wysiłku ocenia ustalone kryteria wizualne przy ukrytej tożsamości generatora. Kontrole szczegółowości wykorzystują pokrycie pomnożone przez jeden minus odchylenie, a następnie wybierają najsłabszy wymagany wariant wykonania/eksportu. Zwykłe zadania L1 sprawdzają cztery wykonania w formie natywnej i GLB; L2 wykorzystuje cztery warianty natywne.
Edycja scen osobno mierzy żądaną modyfikację i zachowanie chronionego otoczenia. Ocena świata odbudowuje przesłany projekt z niezależnym obserwatorem i sprawdza widoczne skutki działań, przecięcia części ruchomych, rzeczywisty ruch postaci oraz trwały stan. Ciągłe przepływy pracy zakazują teleportacji i resetów. Samo otwarcie drzwi w izolacji nie może więc zastąpić ukończenia trasy wymagającej podejścia do drzwi, odblokowania ich i przejścia przez nie.
Wyniki światów uwzględniają wagi jakości wizualnej, zgodności z zadaniem, układu i interakcji wynoszące 60/20/5/15. Końcowy wynik benchmarku uwzględnia wagi L1/L2/L3 wynoszące 30/30/40. Kontrakt punktacji rozróżnia potwierdzone usterki kandydata od brakujących dowodów technicznych: awaria interfejsu API lub pomiaru nie może po cichu stać się zerem.
Zastosowania i otwarte wyzwania
Benchmark wspiera wybór procesów pracy z agentami kodującymi oraz diagnozowanie, czy awarie dotyczą wyglądu, geometrii, edycji czy zachowania. Jego otwarte repozytorium zawiera dane wejściowe zadań, kod generowania/oceny i kontrakty punktacji; oprogramowanie benchmarku jest objęte licencją Apache-2.0, natomiast zasoby zadań zachowują własne licencje. Blender, Unreal Engine i dostęp do modeli wymagają osobnej konfiguracji.
Artykuł wskazuje dwa główne otwarte wyzwania: dopasowanie określonej geometrii i układów oraz koordynację części ruchomych, działań i trwałego stanu. Są to kierunki badań autorów, a nie zapowiedziane funkcje produktu. Porównania opisują kompletne konfiguracje model–uprząż, a ocena wizualna zachowuje ograniczenia kalibracji; zadaniom fotograficznym brakuje również uniwersalnej natywnej prawdy referencyjnej 3D. Niniejszy przegląd analizuje artykuł i implementację, ale nie uruchamia ponownie benchmarku.
Najczęściej zadawane pytania
Czy Frontier3DBench jest sam w sobie modelem generowania 3D?
Nie. Dostarcza zadania i ewaluatory dla agentów programistycznych, które tworzą projekty w Blenderze i Unreal Engine. Nie wprowadza wytrenowanego generatora siatek ani nowej latentnej reprezentacji 3D.
Dlaczego zrzuty ekranu są niewystarczające do zgłoszenia?
Kontrakt wymaga edytowalnych natywnych artefaktów i wykonywalnego zachowania. Oceniający analizują geometrię, ponownie renderują zapisane sceny i testują interakcje, więc sam wygląd nie może potwierdzić poprawności.
Czy najwyższy wynik ogólny wskazuje najlepszego agenta do każdego zadania?
Nie. Liderzy różnią się w zależności od rodziny zadań, a wynik uwzględnia konfigurację harnessu i rozumowania. Przed wyborem przepływu pracy porównaj odpowiedni profil zadania.




