SeMo3D: 3D-generatie, -bewerking en -aanvulling verenigen via selectieve modellering
SeMo3D introduceert een geïntegreerde aanpak voor 3D-generatie, lokale bewerking en aanvulling met behulp van selectieve modellering.

Hoogtepunten en resultaten: verander wat ertoe doet
Oorspronkelijk artikel: SeMo3D: 3D-generatie, bewerking en voltooiing verenigen via selectieve modellering
SeMo3D, geïntroduceerd door onderzoekers van de Universiteit van Nanjing, brengt 3D-generatie, lokale bewerking en voltooiing samen in één framework. Voor teams die AI-creatie van assets verkennen, ligt de centrale belofte in continuïteit: maak een object, pas een gekozen regio aan of reconstrueer een ontbrekend deel terwijl de bestaande context behouden blijft. De naam staat voor Selective Modeling, een strategie waarbij de te synthetiseren regio de gemeenschappelijke interface tussen deze taken vormt. Officiële repository.
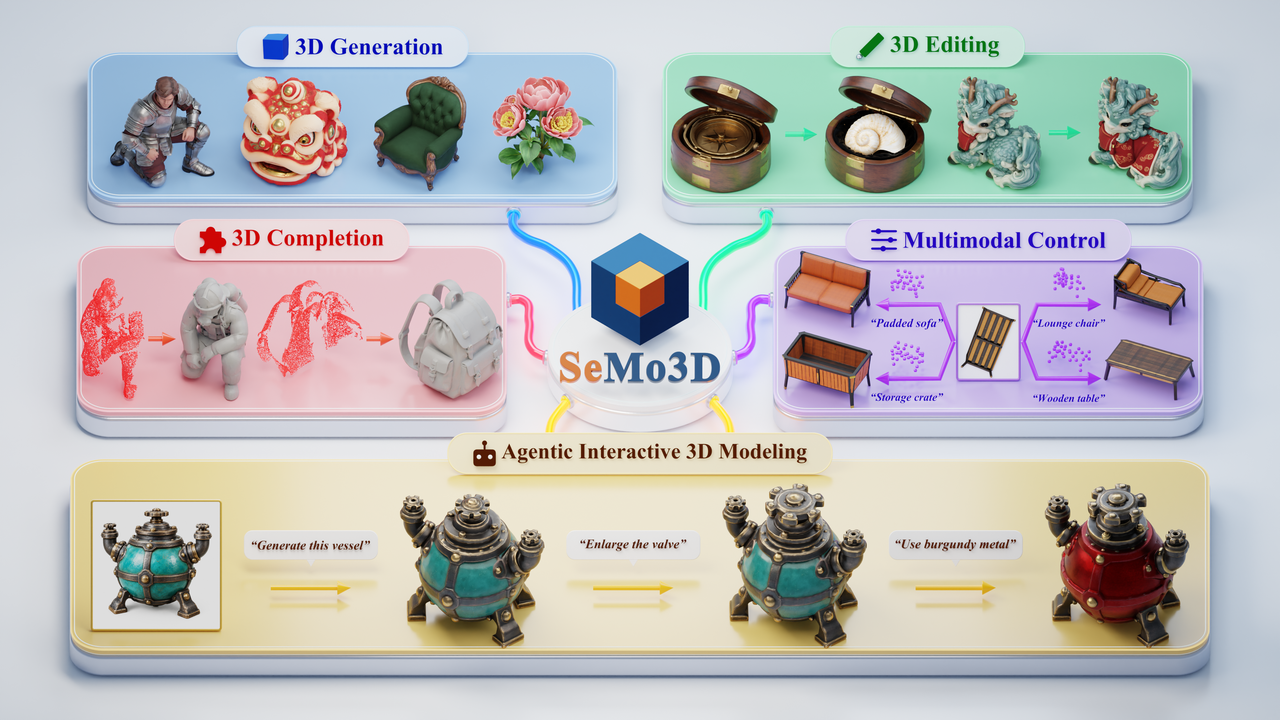
Op Toys4K rapporteren de auteurs een geometrische Chamfer Distance van 0.0118 tegenover 0.0330 voor TRELLIS.2 (lager is beter). De behoudscore bij bewerking bereikt 37.39 dB PSNR tegenover 31.55 dB voor VoxHammer. De F-score voor voltooiing bereikt 0.541 tegenover 0.412 voor HY3D-Omni met aanvullende puntbegeleiding. De ondersteunde invoer verschilt per methode, en de puntaanwijzingen komen uit de ground truth; deze vergelijkingen isoleren de architectuurwinst niet. Artikel, tabellen 1–3.
Hoe het werkt: selecteren, synthetiseren, behouden
De belangrijkste abstractie verdeelt een asset in een geselecteerde regio S en behouden context C. Bij generatie wordt alles geselecteerd; bij bewerking wordt het doel geselecteerd; bij voltooiing wordt geselecteerd wat ontbreekt. Voor een stoel kan dezelfde interface de volledige stoel maken, de rugleuning vervangen of een ontbrekende poot reconstrueren. Dit zijn illustratieve toepassingen van de taakdefinitie. Het model leert een gedeeld probleem voor regionale synthese in plaats van een afzonderlijk taakspecifiek trainingsrecept te vereisen. Overzicht van de repository.
SeMo3D finetunet de drie flowmodellen van TRELLIS.2 op Trellis-500K en hergebruikt de SC-VAE. De sparse structuur voorspelt occupancy op een 16³ latent grid; vorm en textuur werken op bezette posities in een 32³ grid en produceren geometrie en PBR-materialen. Het masker wordt tussen de fasen overgedragen. Task-unificatie gebruikt dus nog steeds drie fasespecifieke modellen. Artikel, methode en trainingsdetails.
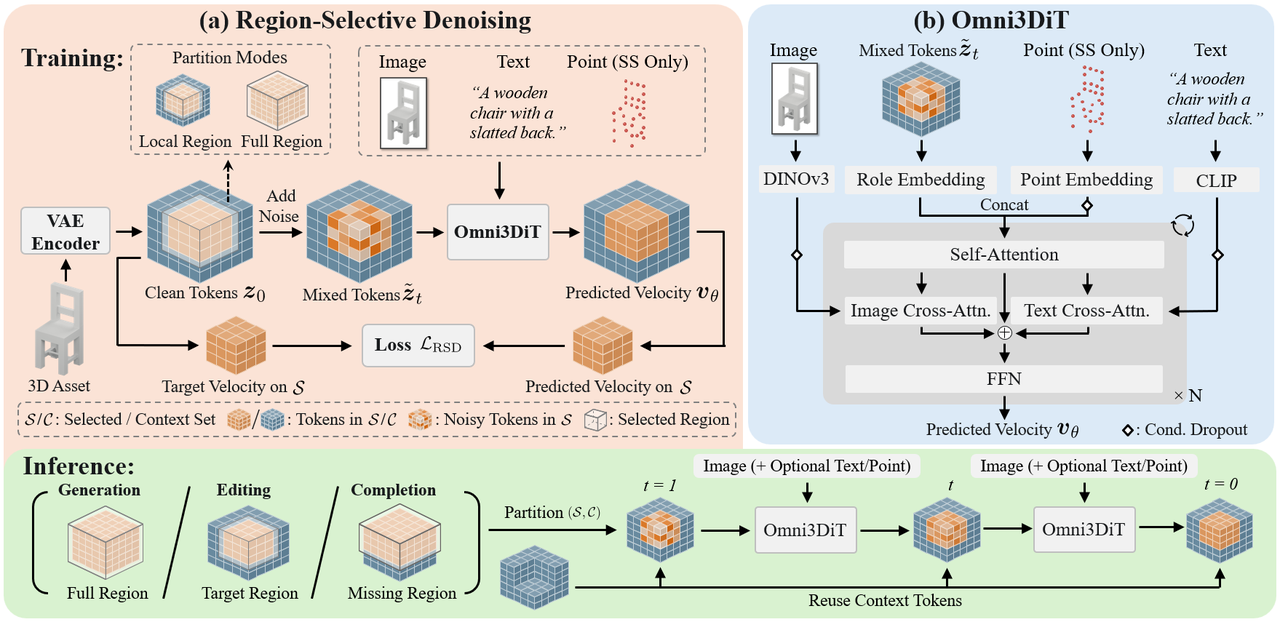
Regioselectieve denoising creëert trainingsvoorbeelden uit gewone assets. Een willekeurige regio krijgt ruis, terwijl de omgeving schoon blijft; alleen voorspellingen in die regio dragen bij aan de loss. De training omvat lokale kaders tot volledige assets, zonder gepaarde datasets voor bewerking of voltooiing vóór en na. Bij inferentie starten geselecteerde tokens vanuit ruis en evolueren ze onder begeleiding, terwijl oorspronkelijke contexttokens bij elke stap opnieuw worden gebruikt. Het model kan daardoor het volledige object raadplegen zonder alles opnieuw te synthetiseren. Officiële uitleg van de methode.
Omni3DiT maakt deze gemengde invoer begrijpelijk. Role embeddings identificeren geselecteerde tokens en contexttokens. Parallelle cross-attention-branches voegen DINOv3-beeldfeatures en CLIP-tekstfeatures toe; puntentokens komen in de self-attention in de fase van de sparse structuur. Afbeeldingen sturen het uiterlijk, tekst voegt semantische intentie toe en punten beperken de ruimtelijke lay-out. Condition dropout varieert tijdens de training de beschikbare begeleiding, waardoor het model wordt aangemoedigd de complementaire signalen te gebruiken. Officieel architectuurdiagram.
Een afbeelding blijft verplicht. Generatie gebruikt 12 Euler-stappen per fase; bewerking/voltooiing gebruikt 50 stappen voor structuur en 12 voor vorm en textuur. Strikt behoud geldt voor latente tokens, niet noodzakelijk voor elke gedecodeerde vertex. Artikel en appendix over inferentie.
Toepassingen en wat hierna komt
De praktische kans ligt in iteratief werk: varianten van props verkennen, onvolledige referenties repareren en assets verfijnen via opeenvolgende instructies. Het officiële project demonstreert ook agent-workflows die referentieafbeeldingen voorbereiden, bewerkingsregio's identificeren en SeMo3D aanroepen. Dit suggereert een nuttige taakverdeling: een agent vertaalt intentie naar een modelleringsverzoek, terwijl het 3D-model de regionale synthese afhandelt. Interactieve projectdemo's.
De inzetbaarheid blijft beperkt. Zoals gecontroleerd op 6 november 2026 bevat de officiële repository documentatie en demo-assets; gewichten en code voor training, inferentie en evaluatie zijn nog niet vrijgegeven. De MIT-licentie legt geen licentievoorwaarden vast voor toekomstige gewichten. Dit artikel bespreekt het artikel en de beschikbare repository, zonder aanspraak te maken op een onafhankelijke reproductie. Releasechecklist.
De auteurs noemen twee onderzoeksrichtingen. 3D-representaties met hogere getrouwheid zouden dunne structuren zoals palmbladeren beter kunnen vastleggen, die de huidige gestructureerde latents moeilijk kunnen oplossen. Sterkere vision-language-encoders zouden het begrip van complexe compositional prompts kunnen verbeteren; het artikel laat zien dat oranje vruchten oranje textuur worden in plaats van afzonderlijke objecten. Beperkingen en toekomstig werk. De resterende release-mijlpalen van het project zijn modelgewichten op Hugging Face en volledige code voor inferentie, training en evaluatie. Officiële TODO-lijst.
Veelgestelde vragen
Kan SeMo3D een asset genereren of bewerken op basis van alleen tekst?
Nee. Het artikel vereist beeldbegeleiding; tekst en schaarse punten zijn optionele aanvullende voorwaarden. Voor bewerking zijn ook een geselecteerde regio en broncontext nodig. Demonstraties van agents in natuurlijke taal omvatten beeldvoorbereiding in plaats van de beeldvereiste te verwijderen. [Bron](https://arxiv.org/html/2611.02568v1#S3.SS2).
Kan ik de rugleuning van een stoel vervangen en de rest behouden?
Dat illustreert de beoogde workflow voor lokale bewerking: selecteer het gebied van de rugleuning, geef aanwijzingen en synthetiseer de tokens ervan terwijl contexttokens opnieuw worden gebruikt. Exacte conservering geldt voor latente tokens; dit moet niet worden opgevat als een garantie dat elk gedecodeerd hoekpunt identiek blijft. [Bron](https://arxiv.org/html/2611.02568v1#S3.SS3).
Kan ik SeMo3D nu lokaal implementeren?
Zoals gecontroleerd op 6 november 2026 blijven modelgewichten en volledige code voor inferentie, training en evaluatie nog niet-afgevinkte release-mijlpalen. Het openbare paper en de demonstraties maken technische evaluatie mogelijk, maar de repository biedt nog geen volledige stack voor lokale implementatie. [Bron](https://github.com/XiaokunSun/SeMo3D#-todo).




