Frontier3DBench: Benchmark voor codeeragents voor 3D-creatie van objecten, scènes en open werelden
Frontier3DBench evalueert het vermogen van codeeragents om bewerkbare en uitvoerbare 3D-projecten te maken voor objecten, scènes en interactieve open werelden.
Origineel artikel: Frontier3DBench: Benchmarking van codeeragenten voor 3D-creatie met objecten, scènes en interactieve open werelden (6 november 2026; v1).
Hoogtepunten en resultaten
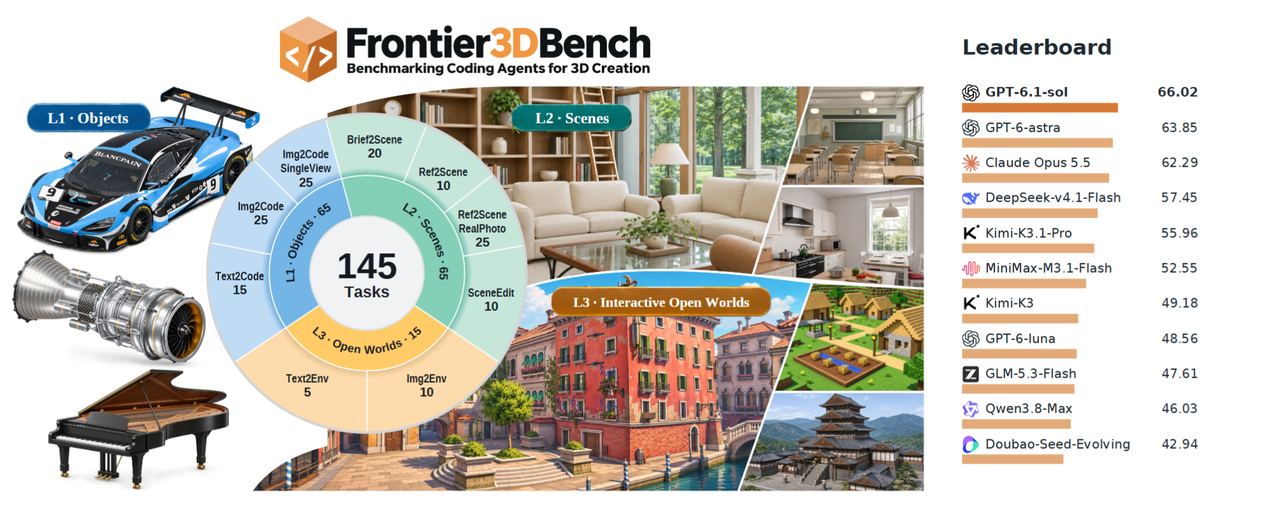
Frontier3DBench onderzoekt of codeeragenten bewerkbare, uitvoerbare 3D-projecten kunnen opleveren voor objecten, scènes en interactieve werelden. Voor teams die een AI-gestuurde workflow voor contentcreatie kiezen, bestaat de bijdrage uit een gemeenschappelijk evaluatiekader: 145 taken verdeeld over negen families, waaronder 65 Blender-objecttaken, 65 Blender-scènetaken en 15 Unreal Engine-wereldtaken. De input bestaat uit instructies, referentieafbeeldingen, foto's en bestaande scènes.
De auteurs evalueren 11 model-harnasconfiguraties. GPT-6.1-sol met Codex leidt overall met 66.02/100; GPT-6-astra met Codex leidt bij interactieve werelden met 61.28. Elke configuratie presteert slechter bij reconstructie op basis van referenties dan bij tekstgestuurde generatie van objecten en scènes. Over 165 wereldinzendingen behalen lokale mechanismen gemiddeld 83.08, bewegende-onderdelenvrijheid 20.82 en stateful workflows 30.26. Dit zijn componentscores, geen percentages van succesvol voltooide werelden.
Een menselijke studie biedt beperkte kalibratie: acht beoordelaars rangschikken vier kandidaten voor elk van 45 referentiegeconditioneerde object-/scène-items. Automatische scores behalen een gemiddelde Kendall tau-b van 0.727 en 79.2% overeenstemming over de winnaar, maar slechts 44.7% overeenstemming over de volledige rangschikking. Dit valideert niet elke taakfamilie of elk wereldgedrag. Zie de experimenten.
Hoe de evaluatie werkt
De agent ontvangt een taakcontract: vereiste geometrie en vormgeving, waar van toepassing referentieafbeeldingen en initiële assets voor bewerking. Wereldtaken definiëren daarnaast entiteiten, beginstaten, toegestane bewerkingen en vereisten. De agent schrijft en voert constructiecode uit en dient vervolgens een native Blender- of Unreal-project plus de vereiste exports in. Evaluatiebestanden blijven buiten zijn werkruimte.
In de vrijgegeven orchestrator kunnen openbare uitvoeringscontroles reparaties activeren, maar de agent ontvangt fouten in plaats van privéscores. Geaccepteerde broncode wordt vóór de evaluatie bevroren en gehasht. Afzonderlijke evaluatoren voeren het programma opnieuw uit, inspecteren native geometrie, renderen weergaven en beoordelen of de taak is vervuld. Het artikel gebruikt Blender 5.2.1 en Unreal Engine 5.8.3; voor L1/L2-generatie zijn maximaal zes pogingen binnen 32 uur toegestaan. Dit zijn budgetplafonds, geen gemeten voltooiingstijden.
De scoring verschilt per taak. Reconstructie op basis van referenties combineert 50% beeldsimilariteit, 20% geprojecteerde objectlokalisatie, 20% visuele beoordeling en 10% detail. Beeldsimilariteit meet structuur, randen, kleur en toon; lokalisatie koppelt objectkaders en bestraft ontbrekende of extra instanties. GPT-6-astra beoordeelt bij gemiddelde inspanning vaste visuele criteria, waarbij de identiteit van de generator verborgen blijft. Voor detail wordt dekking vermenigvuldigd met één min de afwijking; vervolgens wordt de zwakste vereiste uitvoerings-/exportvariant genomen. Bij gewone L1-taken worden vier uitvoeringen in native en GLB-vorm geïnspecteerd; L2 gebruikt vier native varianten.
Bij scènebewerking worden de gevraagde wijziging en het behoud van beschermde omgevingen afzonderlijk gemeten. Bij wereldevaluatie wordt het ingediende project opnieuw opgebouwd met een onafhankelijke observator en worden zichtbare actie-effecten, intersecties van bewegende onderdelen, daadwerkelijke personagebeweging en persistente toestand getest. Continue workflows verbieden teleportatie en resets. Een deur die afzonderlijk opengaat kan daarom niet dienen als vervanging voor het voltooien van een route waarvoor je de deur moet bereiken, ontgrendelen en passeren.
Wereldscores wegen visuele kwaliteit, taakgetrouwheid, lay-out en interactie met 60/20/5/15. Het totale benchmarkresultaat weegt L1/L2/L3 met 30/30/40. Het scoringcontract maakt onderscheid tussen bevestigde defecten van kandidaten en ontbrekend technisch bewijs: een API- of meetfout mag niet stilzwijgend in een nulscore veranderen.
Toepassingen en open uitdagingen
De benchmark ondersteunt het selecteren van workflows voor codeeragenten en het vaststellen of fouten betrekking hebben op vormgeving, geometrie, bewerking of gedrag. De open repository bevat taakinput, generatie-/evaluatiecode en scoringcontracten; de benchmarksoftware gebruikt Apache-2.0, terwijl taakassets hun eigen licenties behouden. Voor Blender, Unreal Engine en modeltoegang is afzonderlijke configuratie vereist.
Het artikel identificeert twee centrale open uitdagingen: het afstemmen op gespecificeerde geometrie en lay-outs, en het coördineren van bewegende onderdelen, acties en persistente toestand. Dit zijn de onderzoeksrichtingen van de auteurs, geen aangekondigde productfuncties. Vergelijkingen beschrijven volledige model-harnasopstellingen en visuele beoordeling kent kalibratiebeperkingen; voor fotografische taken ontbreekt bovendien universele native 3D-ground truth. Deze review leest het artikel en de implementatie, maar voert de benchmark niet opnieuw uit.
Veelgestelde vragen
Is Frontier3DBench zelf een 3D-generatiemodel?
Nee. Het levert taken en evaluatoren voor code-agents die Blender- en Unreal-projecten opbouwen. Het introduceert geen getrainde meshgenerator of een nieuwe latente 3D-representatie.
Waarom zijn screenshots onvoldoende voor een inzending?
Het contract vereist bewerkbare native artefacten en uitvoerbaar gedrag. Beoordelaars inspecteren de geometrie, renderen opgeslagen scènes opnieuw en testen interacties, dus alleen het uiterlijk kan de correctheid niet aantonen.
Identificeert de hoogste totaalscore de beste agent voor elke taak?
Nee. Leiders verschillen per taakfamilie, en de score omvat de harness en de redeneerconfiguratie. Vergelijk het relevante taakprofiel voordat je een workflow kiest.




