SeMo3D: 선택적 모델링을 통한 3D 생성, 편집 및 완성의 통합
SeMo3D 는 선택적 모델링을 사용한 3D 생성, 로컬 편집 및 완성을 위한 통합 접근 방식을 소개합니다.

주요 내용 및 결과: 중요한 것을 바꾸다
원 논문: SeMo3D: 선택적 모델링을 통한 3D 생성, 편집 및 완성의 통합
난징 대학교 연구진이 소개한 SeMo3D 는 3D 생성, 로컬 편집 및 완성을 하나의 프레임워크로 통합합니다. AI 에셋 제작을 탐색하는 팀에게 핵심적인 약속은 연속성입니다. 기존 맥락을 유지하면서 객체를 만들고, 선택한 영역을 수정하거나, 누락된 부분을 재구성할 수 있습니다. 이름은 Selective Modeling을 의미하며, 이는 합성할 영역을 이러한 작업들의 공통 인터페이스로 만드는 전략입니다. 공식 저장소.
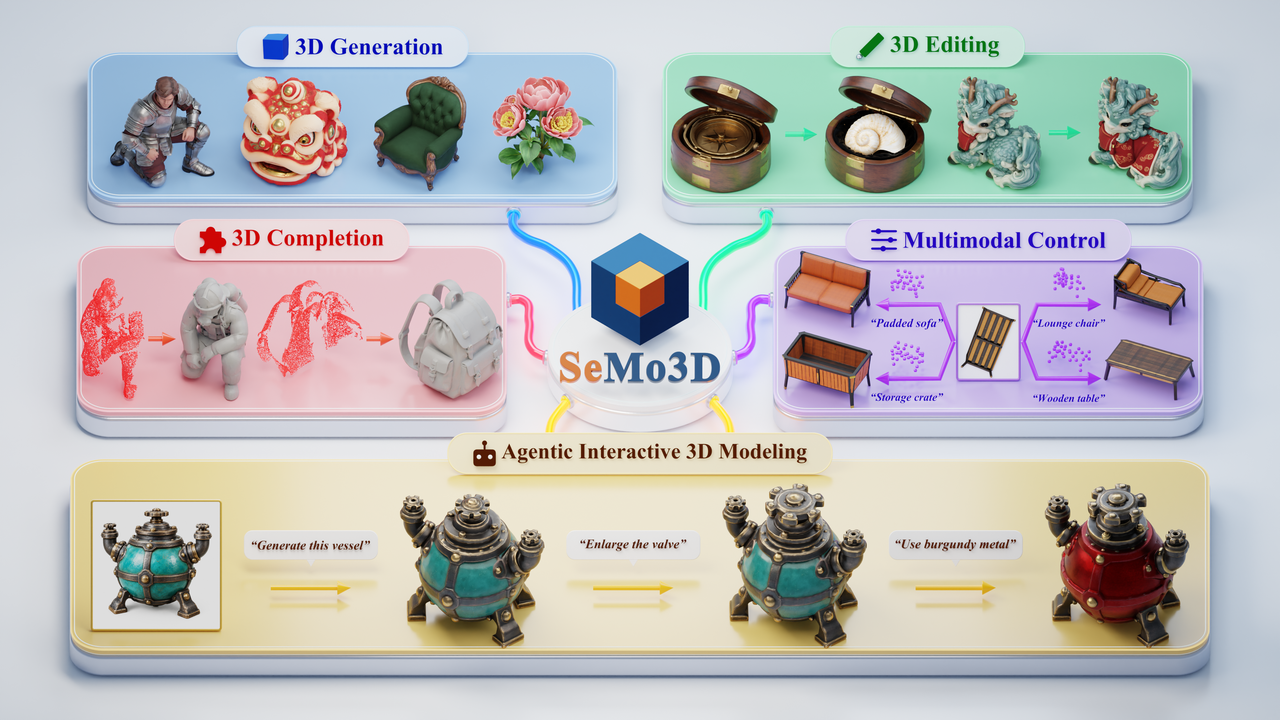
저자들은 Toys4K 에서 기하학적 Chamfer Distance 가 TRELLIS.2의 0.0330 대비 0.0118이라고 보고합니다(낮을수록 우수). 편집 보존 성능은 37.39 dB PSNR로 VoxHammer의 31.55 dB에 비해 높습니다. 완성 F-score 는 추가적인 점 가이던스를 사용했을 때 HY3D-Omni의 0.412 대비 0.541에 도달합니다. 지원되는 입력은 방법마다 다르며, 점 힌트는 ground truth 에서 가져옵니다. 이러한 비교만으로는 아키텍처의 성능 향상을 분리해 확인할 수 없습니다. 논문, 표 1–3.
작동 방식: 선택, 합성, 보존
핵심 추상화는 에셋을 선택된 영역 S와 보존되는 맥락 C로 나눕니다. 생성에서는 모든 영역을 선택하고, 편집에서는 대상 영역을 선택하며, 완성에서는 누락된 영역을 선택합니다. 의자의 경우 동일한 인터페이스로 의자 전체를 만들거나, 등받이를 교체하거나, 사라진 다리를 재구성할 수 있습니다. 이는 작업 정의를 설명하기 위한 예시입니다. 모델은 별도의 작업별 학습 방법을 요구하는 대신 공유된 지역 합성 문제를 학습합니다. 저장소 개요.
SeMo3D 는 Trellis-500K에서 TRELLIS.2의 세 가지 flow 모델을 파인튜닝하고 해당 모델의 SC-VAE 를 재사용합니다. 희소 구조는 16³ latent grid에서 점유 상태를 예측하며, 형상과 텍스처는 32³ grid의 점유 위치에서 작동하여 기하 구조와 PBR 재질을 생성합니다. 마스크는 단계 간에 전달됩니다. 따라서 작업 통합은 여전히 세 개의 단계별 모델을 사용합니다. 논문, 방법 및 학습 세부 정보.
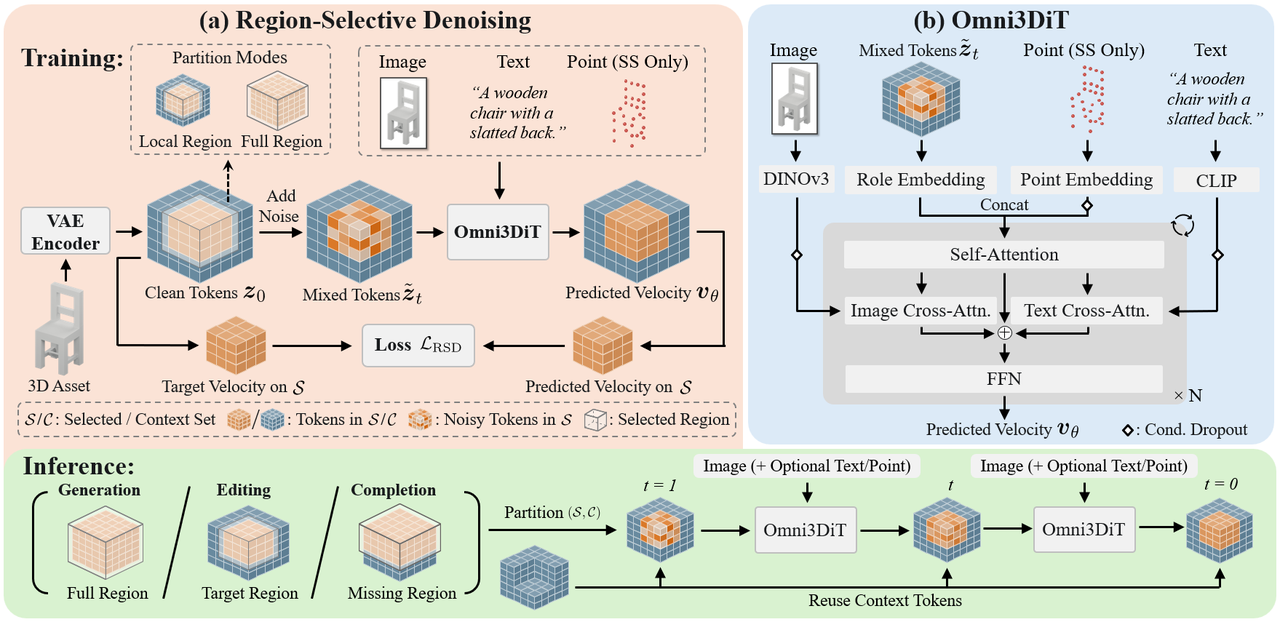
영역 선택적 디노이징은 일반 에셋에서 학습 예시를 생성합니다. 무작위 영역에 노이즈를 추가하고 주변 영역은 깨끗하게 유지하며, 해당 영역의 예측만 손실에 반영합니다. 학습은 로컬 박스부터 에셋 전체까지 포괄하므로, 편집 또는 완성을 위한 전후 쌍 데이터셋이 필요하지 않습니다. 추론 시 선택된 토큰은 노이즈에서 시작해 가이던스에 따라 변화하며, 원래의 맥락 토큰은 모든 단계에서 재사용됩니다. 따라서 모델은 객체 전체를 다시 합성하지 않고도 객체 전체를 참고할 수 있습니다. 공식 방법 설명.
Omni3DiT는 이러한 혼합 입력을 이해할 수 있도록 합니다. 역할 임베딩은 선택된 토큰과 맥락 토큰을 식별합니다. 병렬 cross-attention 분기는 DINOv3 이미지 특징과 CLIP 텍스트 특징을 주입하며, 점 토큰은 희소 구조 단계에서 self-attention 에 입력됩니다. 이미지는 외형을 안내하고, 텍스트는 의미적 의도를 추가하며, 점은 공간적 배치를 제한합니다. 조건 드롭아웃은 학습 중 사용 가능한 가이던스를 다양화하여 모델이 상호 보완적인 신호를 사용하도록 유도합니다. 공식 아키텍처 다이어그램.
이미지는 여전히 필수입니다. 생성에는 단계마다 12회의 Euler 스텝을 사용하고, 편집 및 완성에는 구조에 50회, 형상과 텍스처에 12회를 사용합니다. 엄격한 보존은 latent 토큰에 적용되며, 디코딩된 모든 정점에 반드시 적용되는 것은 아닙니다. 논문 및 추론 부록.
애플리케이션과 향후 방향
실질적인 기회는 반복적인 작업에 있습니다. 소품 변형을 탐색하고, 불완전한 참조를 수정하며, 연속적인 지시를 통해 에셋을 다듬을 수 있습니다. 공식 프로젝트는 참조 이미지를 준비하고, 편집 영역을 식별하며, SeMo3D 를 호출하는 에이전트 워크플로도 시연합니다. 이는 유용한 역할 분담을 시사합니다. 에이전트는 의도를 모델링 요청으로 변환하고, 3D 모델은 지역 합성을 처리합니다. 대화형 프로젝트 시연.
준비도는 여전히 제한적입니다. 2026년 11월 6일에 확인한 결과, 공식 repository에는 문서와 데모 에셋이 포함되어 있지만, 가중치와 학습·추론·평가 코드는 아직 공개되지 않았습니다. MIT 라이선스는 향후 가중치에 대한 라이선스 조건을 정하지 않습니다. 이 글은 논문과 이용 가능한 저장소를 검토한 것이며, 독립적인 재현을 주장하지 않습니다. 출시 체크리스트.
저자들은 두 가지 연구 방향을 제시합니다. 더 높은 충실도의 3D 표현은 현재의 구조화된 latent 가 표현하기 어려워하는 야자수 잎과 같은 얇은 구조를 더 잘 포착할 수 있습니다. 더 강력한 vision-language 인코더는 복잡한 구성적 프롬프트에 대한 이해를 향상할 수 있습니다. 논문에서는 오렌지색 과일이 별도의 객체가 아니라 오렌지색 텍스처가 되는 사례를 보여줍니다. 한계 및 향후 연구. 프로젝트의 남은 출시 단계는 Hugging Face의 모델 가중치와 완전한 추론·학습·평가 코드입니다. 공식 TODO 목록.
자주 묻는 질문
텍스트만으로 SeMo3D 가 에셋을 생성하거나 편집할 수 있나요?
아니요. 이 논문은 이미지 안내를 요구하며, 텍스트와 희소한 포인트는 선택적인 추가 조건입니다. 편집에는 선택한 영역과 소스 컨텍스트도 필요합니다. 자연어 에이전트 데모에는 이미지를 제거하는 것이 아니라 이미지 준비가 포함됩니다. [출처](https://arxiv.org/html/2611.02568v1#S3.SS2).
의자의 나머지 부분은 그대로 두고 등받이만 교체할 수 있나요?
이는 의도된 로컬 편집 워크플로를 보여 줍니다: 등받이 영역을 선택하고, 지침을 제공한 다음, 컨텍스트 토큰을 재사용하면서 해당 영역의 토큰을 합성합니다. 정확한 보존은 잠재 토큰에 적용되며, 디코딩된 모든 정점이 계속 동일하다는 보장을 의미하지는 않습니다. [출처](https://arxiv.org/html/2611.02568v1#S3.SS3).
이제 SeMo3D 를 로컬에 배포할 수 있나요?
2026년 11월 6일 기준으로 확인한 결과, 모델 가중치와 완전한 추론, 학습 및 평가 코드는 여전히 확인되지 않은 릴리스 마일스톤으로 남아 있습니다. 공개 논문과 데모는 기술적 평가를 지원하지만, 저장소는 아직 완전한 로컬 배포 스택을 제공하지 않습니다. [출처](https://github.com/XiaokunSun/SeMo3D#-todo)




