Frontier3DBench: 객체, 장면 및 오픈 월드 전반의 3D 생성 코딩 에이전트 벤치마킹
Frontier3DBench 는 코딩 에이전트가 객체, 씬 및 상호작용형 오픈 월드 전반에서 편집 가능하고 실행 가능한 3D 프로젝트를 생성하는 능력을 평가합니다.
원 논문: Frontier3DBench: 객체, 장면 및 상호작용형 오픈 월드 전반의 코딩 에이전트 3D 생성 벤치마킹 (2026년 11월 6일; v1).
주요 내용 및 결과
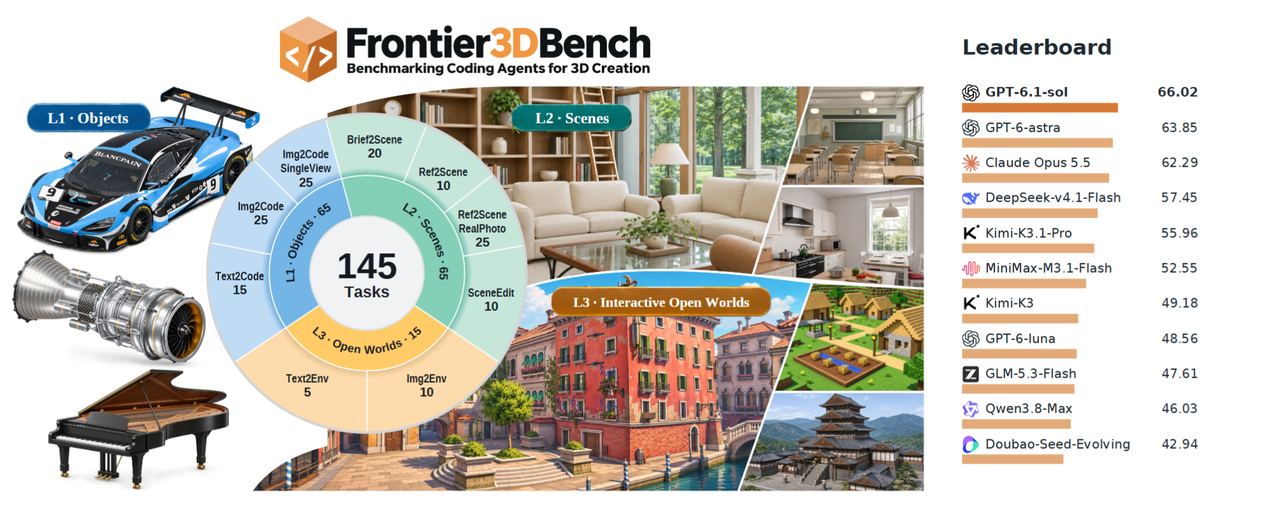
Frontier3DBench는 코딩 에이전트가 객체, 장면 및 상호작용형 월드 전반에서 편집 가능하고 실행 가능한 3D 프로젝트를 제공할 수 있는지 묻습니다. AI 저작 워크플로를 선택하는 팀을 위해 이 벤치마크가 기여하는 바는 공통 평가 프레임워크입니다. 여기에는 9개 분야에 걸친 145개 태스크가 포함되며, Blender 객체 태스크 65개, Blender 장면 태스크 65개, Unreal Engine 월드 태스크 15개로 구성됩니다. 입력에는 지침, 참조 이미지, 사진 및 기존 장면이 포함됩니다.
저자들은 11개의 모델–하네스 구성을 평가합니다. GPT-6.1-sol과 Codex 조합이 전체에서 66.02/100으로 앞서며, GPT-6-astra와 Codex 조합이 상호작용형 월드에서 61.28로 앞섭니다. 모든 구성에서 텍스트 기반 객체 및 장면 생성보다 참조 재구성 성능이 낮습니다. 165개의 월드 제출물 전반에서 로컬 메커니즘은 평균 83.08, 이동 부품 간 간격은 20.82, 상태 유지 워크플로는 30.26을 기록했습니다. 이는 성공적으로 완료된 월드의 비율이 아니라 구성 요소 점수입니다.
인간 연구는 제한적인 보정을 제공합니다. 8명의 평가자가 45개의 참조 조건부 객체/장면 항목 각각에서 4개의 후보를 순위 지정합니다. 자동 점수는 평균 Kendall tau-b 0.727과 승자에 대한 79.2%의 일치율을 달성했지만, 전체 순위에 대한 일치율은 44.7%에 불과했습니다. 이는 모든 태스크 분야나 월드 동작을 검증하는 결과가 아닙니다. 실험을 참조하세요.
평가 방식
에이전트는 필요한 형상과 외관, 해당되는 경우 참조 이미지, 편집을 위한 초기 에셋이 포함된 태스크 계약을 받습니다. 월드 태스크는 엔티티, 시작 상태, 허용된 작업 및 사전 조건을 추가로 정의합니다. 에이전트는 생성 코드를 작성하고 실행한 다음, 네이티브 Blender 또는 Unreal 프로젝트와 필요한 내보내기 결과물을 제출합니다. 평가 파일은 에이전트의 작업 공간 외부에 유지됩니다.
공개된 오케스트레이터에서는 공개 실행 검사가 수정을 트리거할 수 있지만, 에이전트는 비공개 점수가 아니라 오류를 받습니다. 승인된 소스는 평가 전에 고정되고 해시됩니다. 별도의 평가기는 프로그램을 다시 실행하고, 네이티브 형상을 검사하고, 뷰를 렌더링하고, 태스크 수행 여부를 판단합니다. 이 논문은 Blender 5.2.1 및 Unreal Engine 5.8.3을 사용하며, L1/L2 생성에는 32시간 이내에 최대 6번의 시도가 허용됩니다. 이는 측정된 완료 시간이 아니라 예산 상한입니다.
점수 산정 방식은 태스크에 따라 달라집니다. 참조 재구성은 이미지 유사도 50%, 투영된 객체 위치 파악 20%, 시각적 판단 20%, 세부 정보 10%를 결합합니다. 이미지 유사도는 구조, 가장자리, 색상 및 톤을 측정하며, 위치 파악은 객체 상자를 매칭하고 누락되거나 추가된 인스턴스에 페널티를 부여합니다. 중간 수준의 작업량에서 GPT-6-astra가 생성기 식별 정보를 숨긴 채 고정된 시각적 기준을 판단합니다. 세부 정보 검사는 커버리지에 1에서 편차를 뺀 값을 곱한 뒤 가장 취약한 필수 실행/내보내기 변형을 취합니다. 일반 L1 태스크는 네이티브 및 GLB 형식으로 4개의 실행을 검사하고, L2는 4개의 네이티브 변형을 사용합니다.
장면 편집은 요청된 수정 사항과 보호된 주변 환경의 보존을 별도로 측정합니다. 월드 평가는 독립적인 관찰자를 사용해 제출된 프로젝트를 다시 구축하고, 보이는 행동의 효과, 이동 부품의 교차, 실제 캐릭터 이동 및 지속 상태를 테스트합니다. 연속 워크플로에서는 순간 이동과 초기화를 금지합니다. 따라서 문이 단독으로 열리는 것만으로는 해당 문에 도달하고, 잠금을 해제하고, 통과해야 하는 경로의 완료를 대신할 수 없습니다.
월드 점수는 시각적 품질, 태스크 충실도, 레이아웃 및 상호작용에 60/20/5/15의 가중치를 적용합니다. 최종 벤치마크 총점은 L1/L2/L3에 30/30/40의 가중치를 적용합니다. 점수 산정 계약은 확인된 후보 결함과 기술적 증거의 부재를 구분합니다. API 또는 측정 실패가 조용히 0점으로 처리되어서는 안 됩니다.
적용 분야 및 미해결 과제
이 벤치마크는 코딩 에이전트 워크플로를 선택하고, 실패가 외관, 형상, 편집 또는 동작 중 어느 부분과 관련되는지 진단하는 데 도움을 줍니다. 공개 저장소에는 태스크 입력, 생성/평가 코드 및 점수 산정 계약이 포함됩니다. 벤치마크 소프트웨어는 Apache-2.0을 사용하며, 태스크 에셋은 자체 라이선스를 유지합니다. Blender, Unreal Engine 및 모델 액세스에는 별도의 설정이 필요합니다.
이 논문은 두 가지 핵심 미해결 과제를 제시합니다. 지정된 형상과 레이아웃을 일치시키는 것, 그리고 이동 부품, 동작 및 지속 상태를 조정하는 것입니다. 이는 저자들이 제시한 연구 방향이지, 발표된 제품 기능이 아닙니다. 비교는 완전한 모델–하네스 설정을 설명하며, 시각적 판단에는 보정의 한계가 남아 있습니다. 또한 사진 기반 태스크에는 보편적인 네이티브 3D 정답 데이터가 없습니다. 이 리뷰는 논문과 구현을 읽고 작성했지만 벤치마크를 다시 실행하지는 않았습니다.
자주 묻는 질문
Frontier3DBench 자체가 3D 생성 모델인가요?
아니요. Blender 및 Unreal 프로젝트를 구성하는 코딩 에이전트에 작업과 평가자를 제공합니다. 학습된 메시 생성기나 새로운 3D 잠재 표현을 도입하지 않습니다.
제출에 스크린샷만으로는 왜 충분하지 않나요?
계약은 편집 가능한 네이티브 아티팩트와 실행 가능한 동작을 요구합니다. 평가자는 형상을 검사하고, 저장된 장면을 다시 렌더링하며, 상호작용을 테스트하므로 외관만으로는 올바름을 입증할 수 없습니다.
가장 높은 종합 점수가 모든 업무에 가장 적합한 에이전트를 나타내나요?
아니요. 리더는 작업군별로 다르며, 점수에는 하네스와 추론 구성이 포함됩니다. 워크플로를 선택하기 전에 관련 작업 프로필을 비교하세요.




