UltraTex: 3D テクスチャリングのための 2K マルチビュー拡散の可能性を解き放つ
UltraTex は SIGGRAPH Asia 2026 のプロジェクトで、複数視点拡散モデルを活用して、参照画像から高解像度 (2K) テクスチャを 3D メッシュ向けに生成し、512 や 768 のような低解像度の限界に対処します。

ハイライトと結果:詳細度を高め、無駄な計算を削減
原論文:UltraTex: Unleashing 2K Multi-View Diffusion for 3D Texturing
UltraTex は、参照画像を使用して既存の 3D メッシュ向けに詳細なテクスチャを生成します。 SIGGRAPH Asia 2026 のプロジェクトとして発表されたこの手法は、512 または 768 解像度でのマルチビュー テクスチャリングでは細かなパターンや表面ディテールが失われるという、一般的なボトルネックに取り組みます。UltraTex は、オブジェクトの前景に計算を集中させることで、生成するビューを 2048 × 2048 まで引き上げます。中心的な貢献は、トークン処理、アテンション、デコーディングに協調的な変更を加えることで、高解像度マルチビュー拡散を実用化したことです。公式プロジェクト。
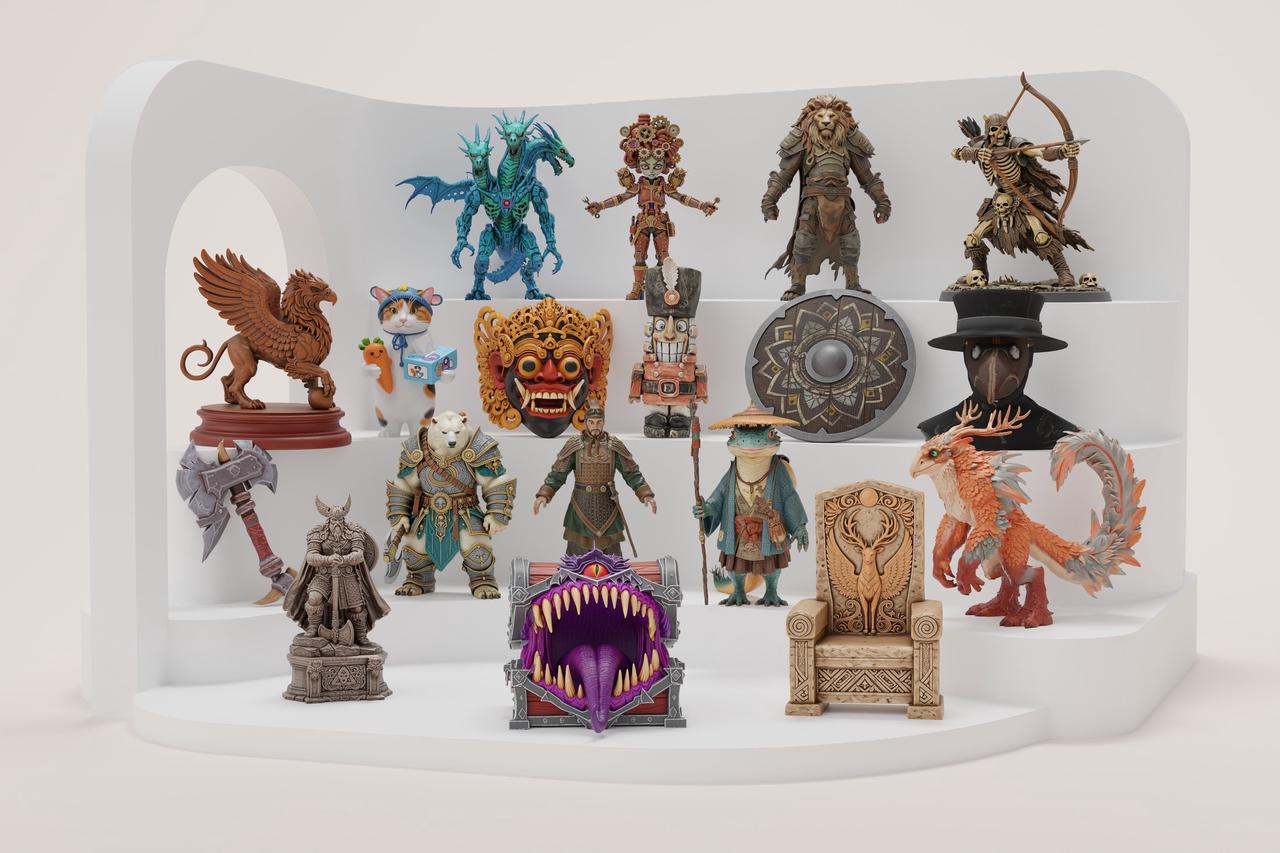
100 個のホールドアウト TexVerse オブジェクトにおいて、UltraTex は アンシェーディング LPIPS 0.082、LumiTex は 0.138 と報告しています。値が低いほど知覚的な一致度が高いことを示します。単一の H200 上で、著者らは、前景占有率 10~30%、アテンション ブロック保持率 20% の条件において、密なベースラインに対して トレーニングで 20.6~91.1 倍、推論で 22.3~74.6 倍の高速化を報告しています。これらは設定に依存する結果であり、すべてのアセットや完全な本番ワークフローに対して固定的な高速化を保証するものではありません。論文、実験。
仕組み:参照画像からテクスチャ付き表面まで
パイプラインはまず、入力メッシュから 6 枚の法線マップをレンダリングします。内訳は 4 つの側面ビュー、上面ビュー、底面ビューです。VAE はジオメトリ ガイダンスと参照画像を潜在表現にエンコードします。事前学習済みの FLUX 拡散トランスフォーマーは、フローマッチングによって対応する 6 枚のテクスチャ ビューを生成し、論文の完全なパイプラインがそれらをメッシュ上に再投影します。2K では、6 枚の対象ビュー、6 枚のジオメトリ ビュー、1 枚の参照画像によって、合計 212,992 個の画像トークンが生成されるため、密な処理が高コストになる理由が分かります。パイプライン; トークン コストの説明。
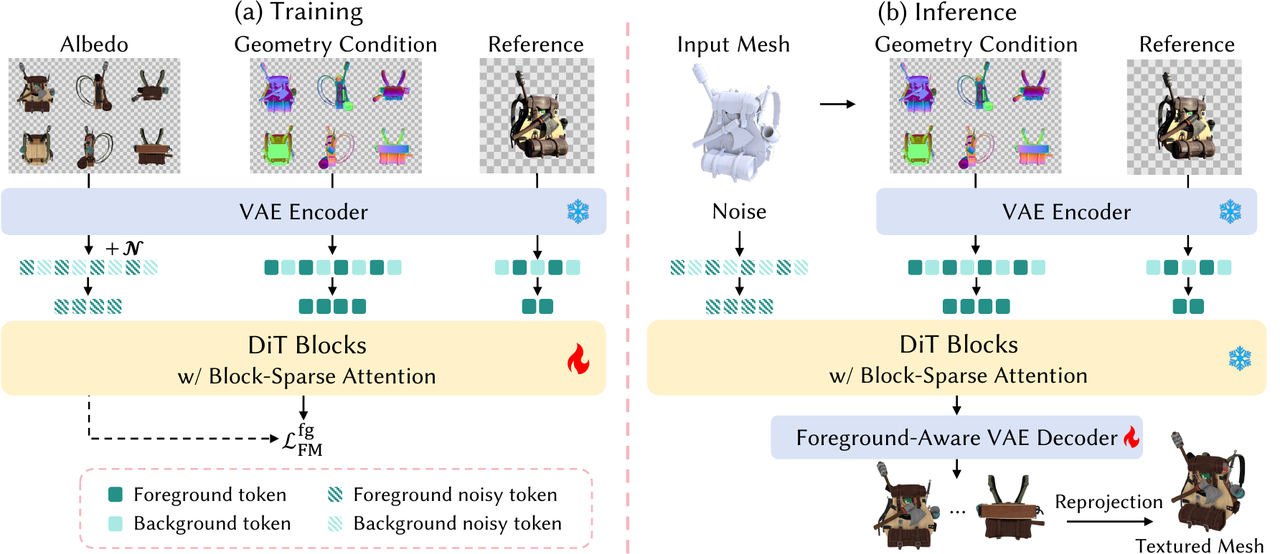
Background Token Dropping は、トランスフォーマー ブロックに入る前に、オブジェクトの外側にある画像トークンを削除します。マスクによって保持する位置を識別し、対応する元の回転位置埋め込み(RoPE)は付加されたままになります。空間座標を失うことなくシーケンスが短くなります。これにより、フィードフォワード層を含むバックボーン全体での処理量が削減されます。公開されているサンプラーでは、オイラー更新は選択された前景位置だけを変更し、デコーディング準備まで背景ノイズはそのまま残されます。トークン選択; サンプリング実装。
Block-Sparse Attention は、残ったトークン間の相互作用コストを削減します。実装では、ブロック内のクエリおよびキー特徴量を平均し、それらの関連性を推定して、各クエリ ブロックに対してスコアの高いキー ブロックを選択します。その後、アテンションは選択されたブロック内の元のトークン特徴量を使用します。FLUX.1 の設定ではキー ブロックの 20% を保持します。これにより、画像解像度を下げることなく多くの相互作用を回避できます。[ブロック選択](https://github.com/yb oz2001/UltraTex/blob/main/ultratex/sparse_attention/utils.py); アテンション設定。
Foreground-Aware VAE デコーディングは、背景のデノイジングを省略した結果に対処します。クリーンな前景とノイズのある背景を組み合わせると、再構成が破損する可能性があります。UltraTex は背景を単色の黒画像からエンコードした潜在表現に置き換え、その複合入力に適応したデコーダーを使用します。エンコーダーは凍結されたままで、デコーダーのトレーニングでは前景ピクセルのみの再構成誤差を最小化します。デコーディング後、公開されている推論スクリプトはマルチビュー画像を保存します。これらの出力をメッシュ アセットに統合するには、依然として再投影またはベイキングの工程が必要です。[デコーダー トレーニング](https://github.com/yb oz2001/UltraTex/blob/main/train_vae/train_decoder.py); [推論出力](https://github.com/yb oz2001/UltraTex/blob/main/inference_flux2.py)。
データ基盤は G-buffer TexVerse です。公開リリースには 351,847 個の BSDF アセットが含まれていますが、UltraTex はフィルタリングされた 268,365 アセットのトレーニング サブセットを使用します。レンダリングでは、最大 4096 × 4096 の解像度で、法線、座標、アルベド、利用可能なマテリアル チャネルが提供されます。このデータ解像度は、UltraTex が実証した 2K 生成とは区別する必要があります。データセットの説明。
アプリケーション、提供状況、今後の方向性
UltraTex はアセット制作における外観工程を対象とします。既存のキャラクター、プロップ、オブジェクトのジオメトリに詳細な表面テクスチャを付与します。デフォルト出力は アルベドで、ベイク済みのライティングを含まない表面色を表します。現在のリポジトリには、個別の LoRA 重みを使用する FLUX.2 メタリック・ラフネス ブランチも用意されています。この利用可能な拡張機能は、メイン論文のアルベド ベンチマークとは区別する必要があります。メイン ベンチマークでは、固定されたラフネス値とメタリック値で UltraTex をレンダリングしています。利用可能なマテリアル出力; 評価設定。
2026 年 11 月 6 日時点で確認した限り、トレーニングおよび推論コードと重みのダウンロード手順は公開されています。リポジトリは FLUX.1-dev と FLUX.2-Klein のバリアントに対応しており、それぞれ対応するバックボーン、LoRA、デコーダー ファイルが必要です。テスト済み環境では Python 3.12、CUDA 12.4、PyTorch 2.5.1 が使用されています。この記事は論文と実装をレビューするものであり、独立した品質または速度の再現結果を主張するものではありません。公式リポジトリ。
著者らは、非常に反復的なテクスチャと、事前学習済み VAE の圧縮表現によるディテール損失を課題として挙げています。4K または 8K へスケールするために示されている方向性は、それらの解像度をネイティブにサポートする DiT–VAE 基盤モデルを再設計することです。既存の FLUX バックボーンは、およそ 1K~2K の入力に適しているためです。これらは、公開済みの高解像度機能ではなく、現時点での制限事項および研究方向です。論文、制限事項。
よくある質問
UltraTex を 使用する前に 3D メッシュが 必要ですか?
はい。 UltraTex は、参照画像とメッシュから導出された法線ビューを使用して、既存のジオメトリにテクスチャを適用します。モデリングまたはジオメトリ生成後の外観ステージに適していますが、参照画像だけから完全なメッシュを再構築するものではありません。 [Source](https://arxiv.org/html/2609.23169v1#S3)。
推論は完成した PBR アセットを直接提供しますか?
公開されたスクリプトはマルチビュー画像を保存しますが、これらには依然としてメッシュへの再投影またはベイク処理が必要です。アルベドがデフォルトの出力です。FLUX.2 のメタリック–ラフネス拡張では、個別の重みを使用します。この拡張を、論文の主要なアルベド評価と混同しないでください。[Source](https://github.com/yiboz2001/UltraTex#inference)。
すべてのアセットで報告された速度向上が得られますか?
いいえ。報告された高速化は、指定された前景占有率およびアテンション保持設定の下で、密なベースラインを基準に H200 上で測定されたものです。オブジェクトのカバレッジ、ハードウェア、構成によって削減量は異なります。数値は、完全なアセットパイプラインで同等の高速化が得られることを保証するものではありません。 [出典](https://arxiv.org/html/2609.23169v1#S4)。


