
ハイライトと成果:重要なものを変える
原論文: SeMo3D:選択的モデリングによる 3D 生成・編集・補完の統合
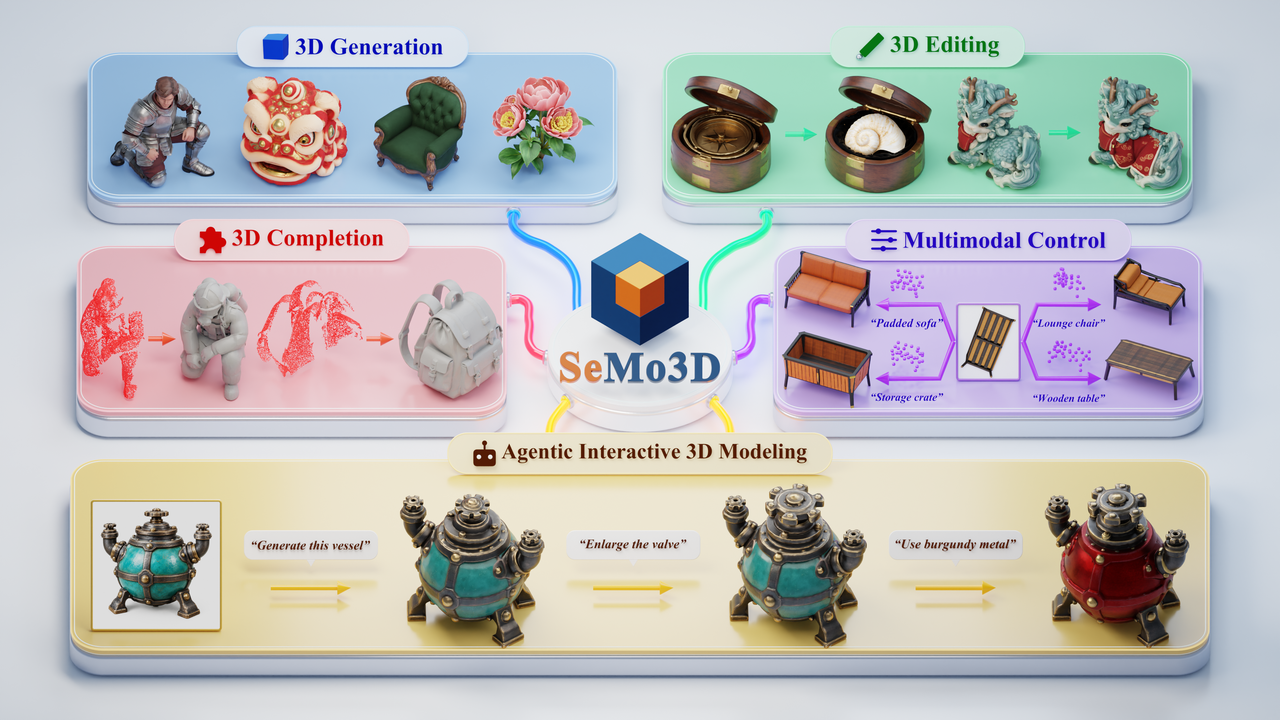
南京大学の研究者によって発表された SeMo3D は、3D 生成、局所編集、補完を 1 つのフレームワークに統合します。AI アセット制作を検討するチームにとって、その中心的な価値は継続性にあります。つまり、既存のコンテキストを維持しながら、オブジェクトを作成し、選択した領域を修正し、欠損部分を再構築できます。この名称は Selective Modeling(選択的モデリング)を意味し、合成する領域をこれらのタスクに共通するインターフェースとする戦略です。公式リポジトリ。
Toys4K において、著者らは幾何学的 Chamfer Distance が TRELLIS.2 の 0.0330 に対して 0.0118(低いほど良好)だったと報告しています。編集後の保持性能は 37.39 dB PSNRで、VoxHammer の 31.55 dB を上回ります。補完の F-score は、追加の点ガイダンスを使用した場合、HY3D-Omni の 0.412 に対して 0.541 に達します。対応する入力は手法ごとに異なり、点ヒントはグラウンドトゥルースから取得されています。これらの比較では、アーキテクチャによる向上を切り分けていません。論文、表 1~3。
仕組み:選択、合成、保持
中核となる抽象化では、アセットを選択領域 S と保持コンテキスト C に分けます。生成ではすべてを選択し、編集では対象を選択し、補完では欠損部分を選択します。椅子の場合、同じインターフェースで椅子全体を作成したり、背もたれを交換したり、欠けた脚を再構築したりできます。これらはタスク定義を説明するための例です。モデルは、タスクごとに別の学習レシピを必要とするのではなく、共有された領域合成問題を学習します。リポジトリ概要。
SeMo3D は TRELLIS.2 の 3 つのフローモデルを Trellis-500K でファインチューニングし、その SC-VAE を再利用します。スパース構造は 16³ の潜在 グリッド上で占有状態を予測し、形状とテクスチャは 32³ グリッド内の占有位置で処理され、ジオメトリと PBR マテリアルを生成します。マスクは各ステージ間で引き継がれます。したがって、タスクの統合には依然として 3 つのステージ固有モデルが使用されます。論文、手法と学習の詳細。
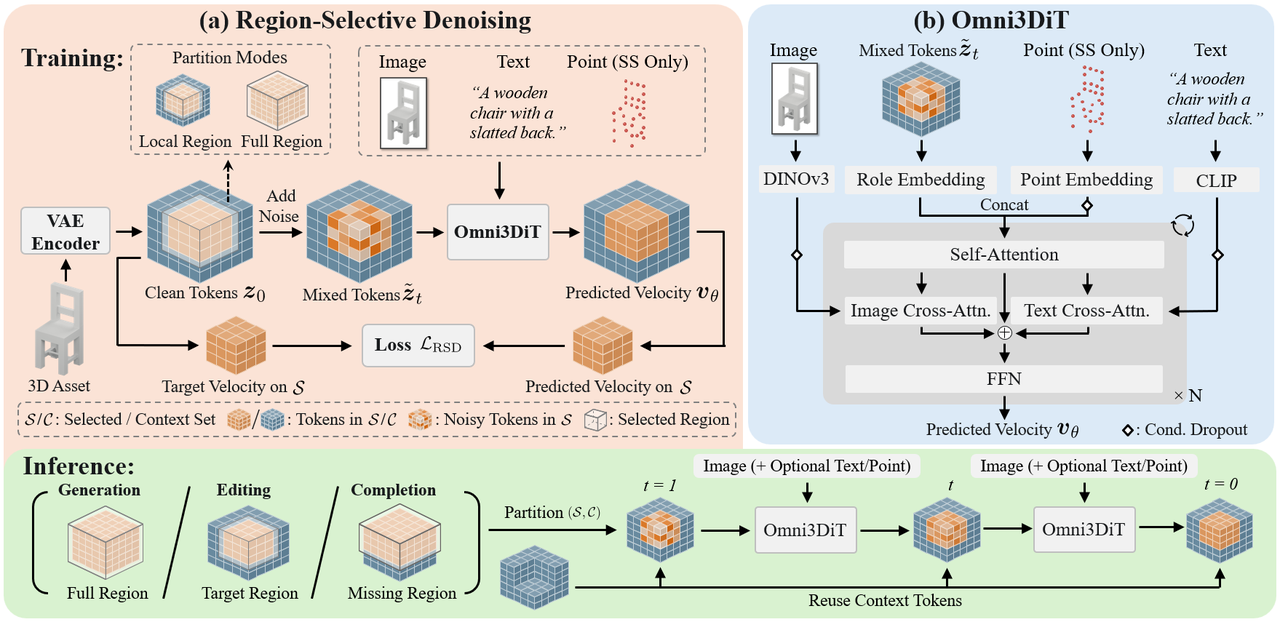
領域選択的デノイジングは、通常のアセットから学習例を作成します。ランダムな領域にノイズを加え、その周囲はクリーンな状態に保ちます。損失には、その領域内の予測だけが寄与します。学習は局所的なボックスからアセット全体まで対象とし、編集前後のペアデータセットや補完データセットを必要としません。推論時には、選択されたトークンがノイズから開始してガイダンスのもとで変化する一方、元のコンテキストトークンは各ステップで再利用されます。そのためモデルは、オブジェクト全体を再合成せずに、全体を参照できます。公式の手法説明。
Omni3DiTは、この混合入力を理解可能にします。ロール埋め込みによって、選択トークンとコンテキストトークンを識別します。並列クロスアテンションブランチは DINOv3 の画像特徴と CLIP のテキスト特徴を注入し、点トークンはスパース構造ステージの自己注意に入力されます。画像は外観を導き、テキストは意味的な意図を加え、点は空間レイアウトを制約します。条件ドロップアウトは、学習中に利用可能なガイダンスを変化させ、相補的な信号を活用するようモデルを促します。公式アーキテクチャ図。
画像は必須のままです。生成では各ステージで 12 回の Euler ステップを使用し、編集・補完では構造に 50 回、形状とテクスチャに 12 回を使用します。厳密な保持が適用されるのは潜在トークンであり、デコードされたすべての頂点に適用されるとは限りません。論文と推論付録。
応用と今後の展開
実用上の機会は反復的な作業にあります。小道具のバリエーションを検討し、不完全な参照を修復し、連続した指示によってアセットを洗練できます。公式プロジェクトでは、参照画像の準備、編集領域の特定、SeMo3D の呼び出しを行うエージェントワークフローも実演しています。これは有用な役割分担を示唆します。エージェントが意図をモデリング要求に変換し、3D モデルが領域合成を処理するという分担です。インタラクティブなプロジェクト実演。
実用化への準備はまだ限定的です。2026 年 11 月 6 日時点で確認したところ、公式 リポジトリにはドキュメントとデモ用アセットが含まれていますが、重みと学習・推論・評価コードは未公開です。 MIT ライセンスは、将来公開される重みのライセンス条件を定めるものではありません。この記事では論文と利用可能なリポジトリをレビューしており、独自の再現実験を主張するものではありません。リリースチェックリスト。
著者らは 2 つの研究方向を示しています。より高忠実度の 3D 表現によって、ヤシの葉のような細い構造をより適切に捉えられる可能性があります。現在の構造化潜在表現では、こうした構造の解像が難しいためです。より強力な視覚言語エンコーダによって、複雑な合成プロンプトの理解が向上する可能性があります。論文では、オレンジの果実が個別のオブジェクトではなくオレンジ色のテクスチャになる例が示されています。制限事項と今後の研究。プロジェクトに残るリリースマイルストーンは、Hugging Face でのモデル重みと、完全な推論・学習・評価コードです。公式 TODO リスト。
よくある質問
SeMo3D はテキストだけでアセットを生成または編集できますか?
いいえ。論文では画像ガイダンスが必要とされており、テキストと疎な点は追加の任意条件です。編集には選択した領域とソースコンテキストも必要です。自然言語エージェントのデモには、画像要件を削除するのではなく、画像の準備が含まれています。 [出典](https://arxiv.org/html/2611.02568v1#S3.SS2)。
椅子の背もたれだけを交換して、他の部分はそのままにできますか?
これは、意図されたローカル編集のワークフローを示しています:背もたれ領域を選択し、ガイダンスを提供して、コンテキストトークンを再利用しながらそのトークンを合成します。潜在トークンには厳密な保持が適用されますが、復号されたすべての頂点が同一のままであることを保証するものと解釈してはなりません。 [Source](https://arxiv.org/html/2611.02568v1#S3.SS3)
今すぐ SeMo3D をローカルにデプロイできますか?
2026年11月6日時点で、モデルの重みと完全な推論・訓練・評価コードは、未チェックのリリースマイルストーンのままです。公開論文とデモは技術評価を支援しますが、リポジトリには完全なローカルデプロイメントスタックがまだ提供されていません。 [出典](https://github.com/XiaokunSun/SeMo3D#-todo)




