Frontier3DBench:オブジェクト、シーン、オープンワールドにまたがる 3D 制作向けコーディングエージェントのベンチマーク
Frontier3DBench は、コーディングエージェントがオブジェクト、シーン、インタラクティブなオープンワールドにわたって、編集可能かつ実行可能な 3D プロジェクトを作成する能力を評価します。
原論文: Frontier3DBench: オブジェクト、シーン、インタラクティブなオープンワールドにわたるコーディングエージェントの 3D 制作ベンチマーク(2026 年 11 月 6 日、v1)。
ハイライトと結果
Frontier3DBench は、コーディングエージェントがオブジェクト、シーン、インタラクティブなワールドにわたって、編集可能かつ実行可能な 3D プロジェクトを提供できるかを検証します。AI オーサリングワークフローを選択するチームにとって、その貢献は共通の評価フレームワークです。9 つのファミリーにまたがる 145 のタスクで構成され、その内訳は Blender オブジェクトタスク 65 件、Blender シーンタスク 65 件、Unreal Engine ワールドタスク 15 件です。入力には、指示、参照画像、写真、既存のシーンが含まれます。
著者らは 11 のモデル・ハーネス構成を評価しています。GPT-6.1-sol と Codex の組み合わせが総合で 66.02/100 を獲得して首位となり、GPT-6-astra と Codex の組み合わせがインタラクティブワールドで 61.28 を獲得して首位となりました。すべての構成で、参照画像からの再構成は、テキスト駆動のオブジェクトおよびシーン生成よりも低い成績でした。165 件のワールド提出物全体では、ローカルメカニズムの平均スコアは 83.08、可動部のクリアランスは 20.82、ステートフルワークフローは 30.26 でした。これらはコンポーネントスコアであり、正常に完了したワールドの割合ではありません。
人手による研究では限定的なキャリブレーションが行われています。8 人の評価者が、45 件の参照条件付きオブジェクト・シーン項目ごとに 4 つの候補を順位付けしました。自動スコアは、平均 Kendall の tau-b で 0.727、勝者について 79.2% の一致率を達成しましたが、完全な順位についての一致率は 44.7% にとどまりました。これは、すべてのタスクファミリーやワールドの挙動を検証するものではありません。実験を参照してください。
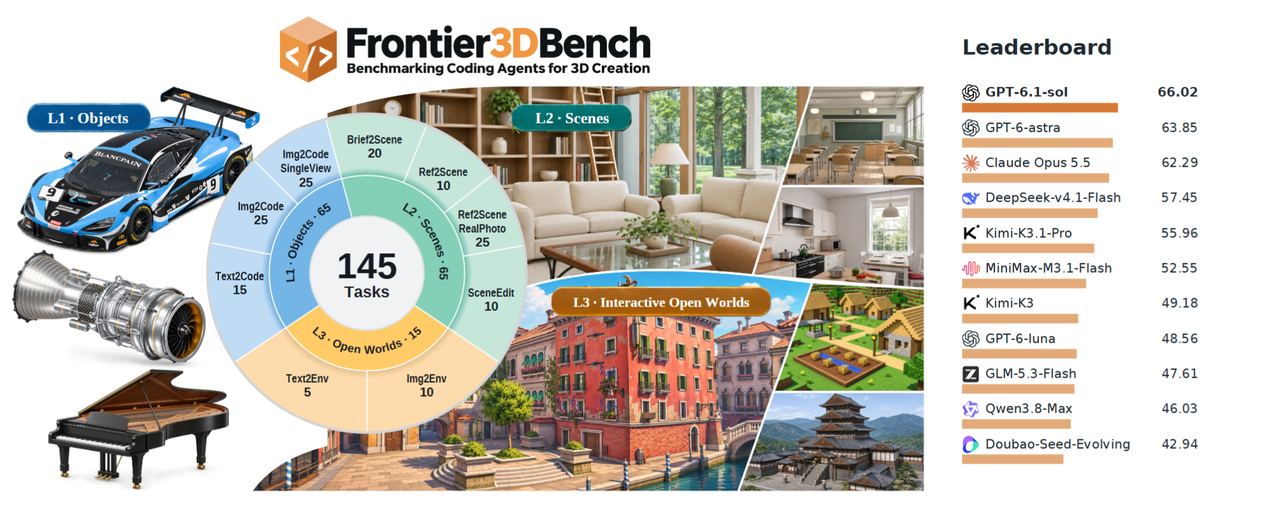
評価の仕組み
エージェントは、必要なジオメトリと外観、該当する場合は参照画像、編集用の初期アセットからなるタスク契約を受け取ります。ワールドタスクではさらに、エンティティ、開始状態、許可される操作、前提条件が定義されます。エージェントは構築コードを記述して実行し、その後、ネイティブの Blender または Unreal プロジェクトと必要なエクスポートを提出します。評価ファイルはエージェントのワークスペース外に保持されます。
公開されたオーケストレーターでは、公開実行チェックによって修復がトリガーされる場合がありますが、エージェントが受け取るのは非公開スコアではなくエラーです。受理されたソースは評価前に凍結され、ハッシュ化されます。別個の評価器がプログラムを再実行し、ネイティブジオメトリを検査し、ビューをレンダリングし、タスク達成度を判定します。論文では Blender 5.2.1 と Unreal Engine 5.8.3 を使用しています。L1/L2 生成では、32 時間以内に最大 6 回の試行が許可されます。これらは予算上限であり、測定された完了時間ではありません。
スコアリングはタスクによって異なります。参照再構成では、画像類似度 50%、投影されたオブジェクト位置特定 20%、視覚的判定 20%、詳細度 10% を組み合わせます。画像類似度は構造、エッジ、色、トーンを測定します。位置特定ではオブジェクトボックスを照合し、欠落または余分なインスタンスにペナルティを課します。GPT-6-astra は、中程度の推論 effort で、生成器の識別情報を隠した固定の視覚基準を判定します。詳細度のチェックでは、カバレッジに 1 から偏差を引いた値を乗じ、その後、必要な実行・エクスポート形式のうち最も低いものを採用します。通常の L1 タスクではネイティブ形式と GLB 形式で 4 回の実行を検査し、L2 では 4 つのネイティブバリアントを使用します。
シーン編集では、要求された変更と保護対象の周辺環境の維持を別々に測定します。ワールド評価では、独立したオブザーバーを用いて提出されたプロジェクトを再構築し、目に見えるアクションの効果、可動部同士の交差、実際のキャラクター移動、永続状態をテストします。連続ワークフローではテレポートとリセットが禁止されます。したがって、ドアを単独で開けることは、ドアに到達し、ロックを解除し、通過する必要があるルートの完了の代わりにはなりません。
ワールドスコアでは、視覚品質、タスク忠実度、レイアウト、インタラクションに 60/20/5/15 の重みを付けます。最終ベンチマーク総合スコアでは、L1/L2/L3 に 30/30/40 の重みを付けます。スコアリング契約では、確認済みの候補の欠陥と、技術的証拠の不足を区別しています。API または測定の失敗を、黙ってゼロとして扱ってはなりません。
用途と未解決の課題
このベンチマークは、コーディングエージェントのワークフローを選択し、失敗が外観、ジオメトリ、編集、挙動のいずれに関係するかを診断するために役立ちます。公開リポジトリには、タスク入力、生成・評価コード、スコアリング契約が含まれています。ベンチマークソフトウェアは Apache-2.0 を使用しますが、タスクアセットにはそれぞれのライセンスが適用されます。Blender、Unreal Engine、モデルへのアクセスには別途セットアップが必要です。
この論文では、2 つの中心的な未解決課題が示されています。指定されたジオメトリとレイアウトの再現、および可動部、アクション、永続状態の調整です。これらは著者らの研究方針であり、発表済みの製品機能ではありません。比較では完全なモデル・ハーネス構成を説明しており、視覚的判定にはキャリブレーション上の制限が残っています。また、写真タスクには普遍的なネイティブ 3D グラウンドトゥルースがありません。このレビューでは論文と実装を読みましたが、ベンチマークを再実行してはいません。
よくある質問
Frontier3DBench 自体が 3D 生成モデルですか?
いいえ。Blender と Unreal のプロジェクトを構築するコーディングエージェント向けに、タスクと評価者を提供します。訓練済みのメッシュジェネレーターや、新しい 3D 潜在表現を導入するものではありません。
提出にスクリーンショットだけでは不十分なのはなぜですか?
契約では、編集可能なネイティブアーティファクトと実行可能な動作が必要です。評価者はジオメトリを検査し、保存されたシーンを再レンダリングし、インタラクションをテストするため、外観だけでは正しさを証明できません。
総合スコアが最も高いエージェントが、すべての仕事において最適なエージェントだと言えますか?
いいえ。リーダーはタスク ファミリーごとに異なり、スコアにはハーネスと推論設定が含まれます。ワークフローを選ぶ前に、関連するタスク プロファイルを比較してください。




