UltraTex: Sfruttare la diffusione multi-view 2K per la texturizzazione 3D
UltraTex è un progetto SIGGRAPH Asia 2026 che sfrutta modelli di diffusione multi-vista per generare texture ad alta risoluzione (2K) per mesh 3D a partire da immagini di riferimento, affrontando i limiti delle risoluzioni inferiori come 512 o 768.

Punti salienti e risultati: più dettaglio, meno calcolo sprecato
Articolo originale: UltraTex: Unleashing 2K Multi-View Diffusion for 3D Texturing
UltraTex genera texture dettagliate per una mesh 3D esistente utilizzando un'immagine di riferimento. Presentato come progetto SIGGRAPH Asia 2026, affronta un collo di bottiglia comune: la texturizzazione multi-view a risoluzione 512 o 768 perde i pattern fini e i dettagli della superficie. UltraTex porta le viste generate a 2048 × 2048, concentrando il calcolo sul primo piano dell'oggetto. Il suo contributo centrale consiste nel rendere pratica la diffusione multi-view ad alta risoluzione attraverso modifiche coordinate all'elaborazione dei token, all'attenzione e al decoding. Progetto ufficiale.
Su 100 oggetti TexVerse tenuti da parte per la valutazione, UltraTex riporta un LPIPS non ombreggiato di 0.082 rispetto a 0.138 di LumiTex, dove un valore più basso indica una maggiore corrispondenza percettiva. Su un singolo H200, gli autori riportano accelerazioni di 20.6–91.1× nell'addestramento e di 22.3–74.6× nell'inferenza rispetto alla baseline densa, per un'occupazione del primo piano del 10–30% e con il 20% dei blocchi di attenzione mantenuti. Si tratta di risultati dipendenti dalla configurazione, non di un'accelerazione fissa per ogni asset o per un workflow produttivo completo. Articolo, esperimenti.
Come funziona: dall'immagine di riferimento alla superficie texturizzata
La pipeline esegue innanzitutto il rendering di sei normal map dalla mesh di input: quattro viste laterali, una vista dall'alto e una vista dal basso. Una VAE codifica la guida geometrica e l'immagine di riferimento in latent. Un transformer di diffusione FLUX pretrained genera quindi sei viste texture corrispondenti tramite flow matching; la pipeline completa dell'articolo le riproietta sulla mesh. A 2K, sei viste target, sei viste geometriche e un'immagine di riferimento contribuiscono per 212,992 token immagine, spiegando perché l'elaborazione densa diventa costosa. Pipeline; spiegazione del costo dei token.
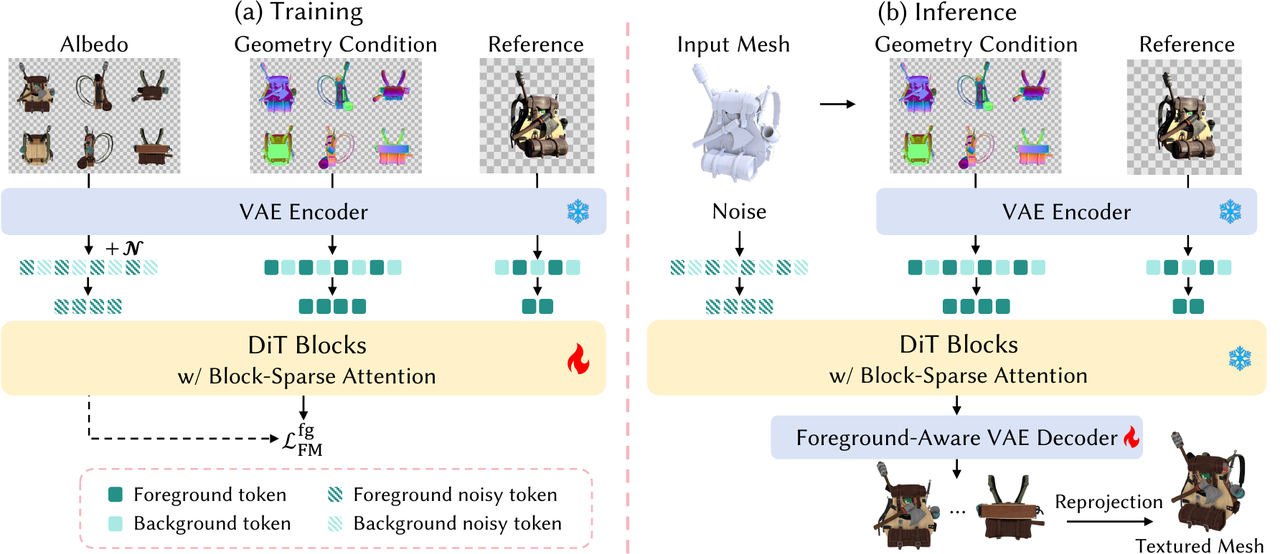
Background Token Dropping rimuove i token immagine esterni all'oggetto prima dei blocchi transformer. Le maschere identificano le posizioni mantenute, mentre i corrispondenti embedding posizionali rotatori (RoPE) originali restano associati. La sequenza diventa più breve senza perdere le coordinate spaziali. Ciò riduce il lavoro lungo tutto il backbone, inclusi i livelli feed-forward. Nel sampler rilasciato, gli aggiornamenti di Euler modificano solo le posizioni selezionate del primo piano; il rumore dello sfondo resta invariato fino alla preparazione del decoding. Selezione dei token; implementazione del sampling.
Block-Sparse Attention riduce il costo delle interazioni tra i token rimanenti. L'implementazione calcola la media delle feature di query e key all'interno dei blocchi, ne stima la rilevanza e seleziona i blocchi key con il punteggio più alto per ciascun blocco query. L'attenzione utilizza quindi le feature originali dei token all'interno di quei blocchi selezionati. La configurazione FLUX.1 conserva il 20% dei blocchi key: evita molte interazioni senza ridurre la risoluzione dell'immagine. Selezione dei blocchi; configurazione dell'attenzione.
Foreground-Aware VAE Decoding affronta la conseguenza del salto del denoising dello sfondo. La combinazione di un primo piano pulito con uno sfondo rumoroso può compromettere la ricostruzione. UltraTex sostituisce lo sfondo con un latent codificato da un'immagine completamente nera, quindi utilizza un decoder adattato a questo composito. L'encoder rimane congelato; l'addestramento del decoder minimizza l'errore di ricostruzione solo sui pixel del primo piano. Dopo il decoding, gli script di inferenza rilasciati salvano immagini multi-view. L'integrazione di questi output in un asset mesh richiede comunque il passaggio di riproiezione o baking. Addestramento del decoder; output dell'inferenza.
La base dati è G-buffer TexVerse. La release pubblica comprende 351,847 asset BSDF, mentre UltraTex utilizza un sottoinsieme di addestramento filtrato composto da 268,365 asset. I rendering forniscono normali, coordinate, albedo e i canali dei materiali disponibili fino a 4096 × 4096. Questa risoluzione dei dati va distinta dalla generazione a 2K dimostrata da UltraTex. Descrizione del dataset.
Applicazioni, disponibilità e direzioni future
UltraTex è destinato alla fase di definizione dell'aspetto nella creazione degli asset: fornisce texture dettagliate per la superficie di geometrie esistenti di personaggi, props e oggetti. L'output predefinito è albedo, che rappresenta il colore della superficie senza illuminazione incorporata. Il repository attuale fornisce anche un ramo FLUX.2 metallic–roughness con pesi LoRA separati. Questa estensione disponibile va distinta dal benchmark albedo principale dell'articolo, che esegue il rendering di UltraTex con valori fissi di roughness e metallic. Output dei materiali disponibili; impostazioni di valutazione.
Alla verifica del 6 novembre 2026, il codice per l'addestramento e l'inferenza e le istruzioni per scaricare i pesi sono pubblici. Il repository supporta le varianti FLUX.1-dev e FLUX.2-Klein, ciascuna delle quali richiede file corrispondenti per backbone, LoRA e decoder. L'ambiente testato utilizza Python 3.12, CUDA 12.4 e PyTorch 2.5.1. Questo articolo esamina l'articolo scientifico e l'implementazione; non sostiene di aver riprodotto in modo indipendente la qualità o la velocità. Repository ufficiale.
Gli autori segnalano difficoltà con le texture altamente ripetitive e la perdita di dettagli dovuta alla rappresentazione compressa della VAE pretrained. La direzione dichiarata per arrivare a 4K o 8K consiste nel riprogettare modelli foundation DiT–VAE che supportino nativamente tali risoluzioni, poiché il backbone FLUX esistente è più adatto a input di circa 1K–2K. Questi elementi restano limitazioni e direzioni di ricerca, non funzionalità ad alta risoluzione rilasciate. Articolo, limitazioni.
Domande frequenti
Devo avere una mesh 3D prima di usare UltraTex?
Sì. UltraTex texturizza la geometria esistente utilizzando un'immagine di riferimento e visualizzazioni delle normali derivate dalla mesh. Si inserisce nella fase di definizione dell'aspetto dopo la modellazione o la generazione della geometria; non ricostruisce una mesh completa partendo dalla sola immagine di riferimento. [Fonte](https://arxiv.org/html/2609.23169v1#S3).
L'inferenza fornisce direttamente un asset PBR finito?
Gli script rilasciati salvano immagini multi-view, che devono ancora essere riproiettate o sottoposte a baking sulla mesh. Albedo è l'output predefinito; l'estensione metallic–roughness di FLUX.2 usa pesi separati. Tale estensione non va confusa con la valutazione principale dell'albedo descritta nel paper. [Fonte](https://github.com/yiboz2001/UltraTex#inference).
Ogni risorsa riceverà l'aumento di velocità dichiarato?
No. L’accelerazione riportata è stata misurata su un H200 rispetto a una baseline densa, con impostazioni specificate di occupazione del primo piano e mantenimento dell’attenzione. La copertura degli oggetti, l’hardware e la configurazione influiscono sui risparmi; i dati non garantiscono accelerazioni equivalenti per l’intera pipeline degli asset. [Fonte](https://arxiv.org/html/2609.23169v1#S4).


