SeMo3D: Unificare la generazione, la modifica e il completamento 3D tramite la modellazione selettiva
SeMo3D introduce un approccio unificato alla generazione 3D, alla modifica locale e al completamento mediante modellazione selettiva.

Punti salienti e risultati: cambiare ciò che conta
Articolo originale: SeMo3D: unificare generazione, modifica e completamento 3D attraverso la modellazione selettiva
SeMo3D, introdotto da ricercatori dell'Università di Nanchino, riunisce generazione 3D, modifica locale e completamento in un unico framework. Per i team che esplorano la creazione di risorse tramite IA, la sua promessa centrale è la continuità: creare un oggetto, modificare una regione selezionata o ricostruire una sezione mancante mantenendo il contesto esistente. Il nome sta per Selective Modeling, una strategia che rende la regione da sintetizzare l'interfaccia comune tra queste attività. Repository ufficiale.
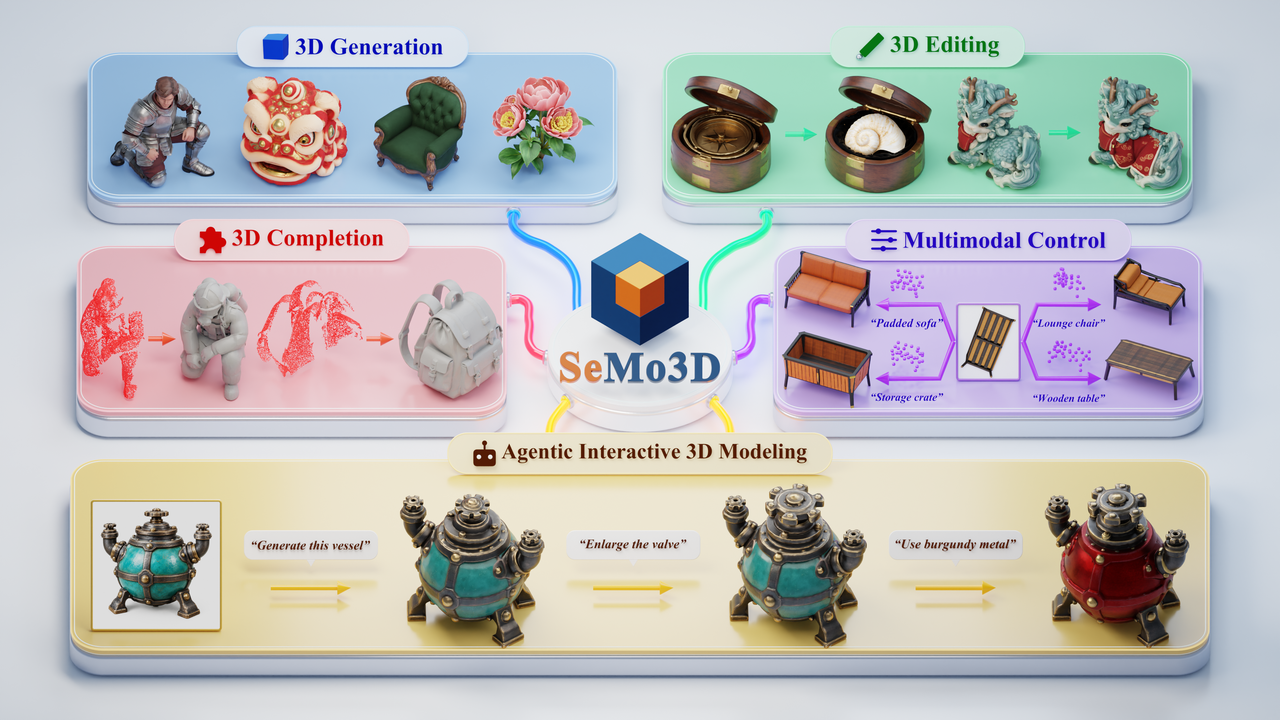
Su Toys4K, gli autori riportano una Chamfer Distance geometrica di 0.0118 contro 0.0330 di TRELLIS.2 (più basso è meglio). La preservazione durante la modifica raggiunge 37.39 dB PSNR contro i 31.55 dB di VoxHammer. L'F-score del completamento raggiunge 0.541 contro 0.412 di HY3D-Omni con una guida aggiuntiva tramite punti. Gli input supportati differiscono tra i metodi e gli indizi puntuali provengono dal ground truth; questi confronti non isolano i miglioramenti dovuti all'architettura. Articolo, Tabelle 1–3.
Come funziona: selezionare, sintetizzare, preservare
L'astrazione chiave divide una risorsa in una regione selezionata S e un contesto preservato C. La generazione seleziona tutto; la modifica seleziona l'obiettivo; il completamento seleziona ciò che manca. Per una sedia, la stessa interfaccia potrebbe creare l'intera sedia, sostituirne lo schienale o ricostruire una gamba assente. Si tratta di esempi illustrativi della definizione delle attività. Il modello apprende un problema condiviso di sintesi regionale invece di richiedere una ricetta di addestramento separata e specifica per ogni attività. Panoramica del repository.
SeMo3D esegue il fine-tuning dei tre modelli di flusso di TRELLIS.2 su Trellis-500K e riutilizza il suo SC-VAE. La struttura sparsa predice l'occupazione su una griglia latente 16³; forma e texture operano nelle posizioni occupate di una griglia 32³, producendo geometria e materiali PBR. La maschera viene trasferita tra le fasi. Pertanto, l'unificazione delle attività utilizza comunque tre modelli specifici per fase. Articolo, dettagli su metodo e addestramento.
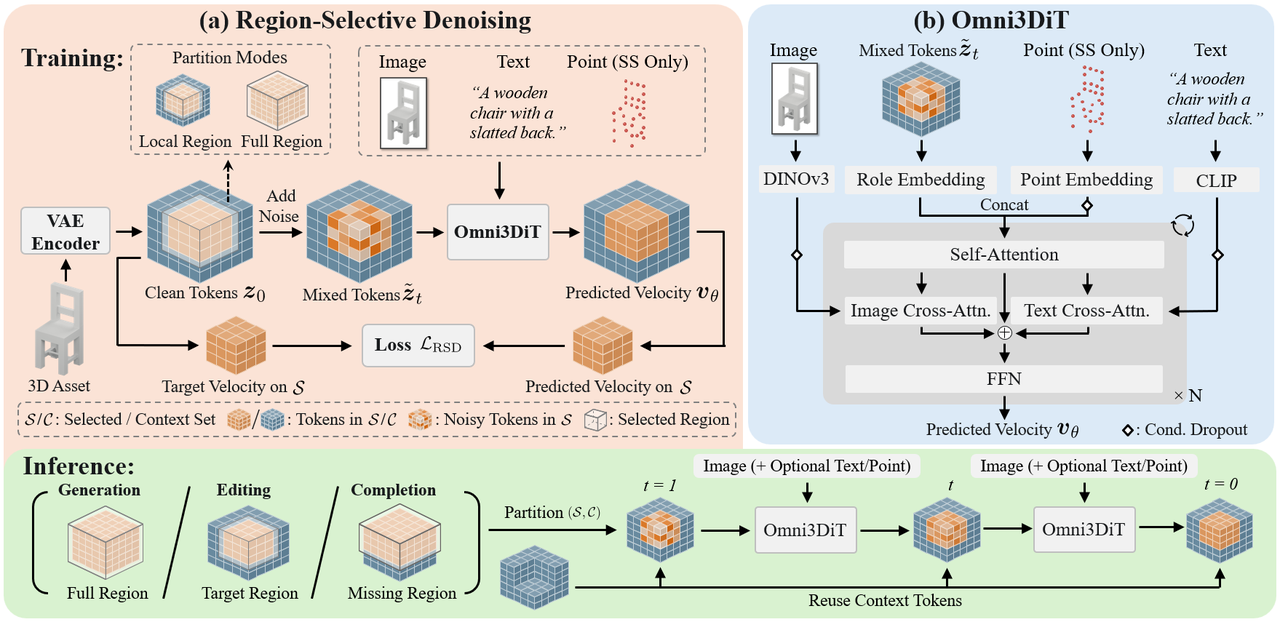
La denoising selettiva per regione crea esempi di addestramento a partire da risorse ordinarie. Una regione casuale riceve rumore mentre ciò che la circonda rimane pulito; solo le predizioni in quella regione contribuiscono alla loss. L'addestramento spazia da riquadri locali a risorse complete, evitando dataset appaiati di modifica o completamento prima-dopo. Durante l'inferenza, i token selezionati partono dal rumore e si evolvono sotto guida, mentre i token del contesto originale vengono riutilizzati a ogni passaggio. Il modello può quindi consultare l'intero oggetto senza risintetizzarlo completamente. Spiegazione ufficiale del metodo.
Omni3DiT rende comprensibile questo input misto. Gli embedding dei ruoli identificano i token selezionati e quelli del contesto. Rami paralleli di cross-attention iniettano le feature delle immagini DINOv3 e le feature testuali di CLIP; i token dei punti entrano nella self-attention nella fase della struttura sparsa. Le immagini guidano l'aspetto, il testo aggiunge l'intento semantico e i punti vincolano la disposizione spaziale. Il condition dropout varia la guida disponibile durante l'addestramento, incoraggiando il modello a utilizzare i segnali complementari. Diagramma ufficiale dell'architettura.
Un'immagine rimane obbligatoria. La generazione utilizza 12 passaggi di Eulero per fase; la modifica/il completamento ne utilizza 50 per la struttura e 12 per forma e texture. La preservazione rigorosa si applica ai token latenti, non necessariamente a ogni vertice decodificato. Articolo e appendice sull'inferenza.
Applicazioni e prossimi sviluppi
L'opportunità pratica è il lavoro iterativo: esplorare varianti di oggetti di scena, riparare riferimenti incompleti e perfezionare le risorse attraverso istruzioni successive. Il progetto ufficiale mostra anche flussi di lavoro agentici che preparano immagini di riferimento, identificano le regioni da modificare e invocano SeMo3D. Ciò suggerisce una divisione del lavoro utile: un agente traduce l'intento in una richiesta di modellazione, mentre il modello 3D gestisce la sintesi regionale. Dimostrazioni interattive del progetto.
La prontezza all'uso rimane limitata. Alla verifica del 6 novembre 2026, il repository ufficiale contiene documentazione e risorse dimostrative; i pesi e il codice per addestramento, inferenza e valutazione non sono ancora stati rilasciati. La sua licenza MIT non stabilisce i termini di licenza per eventuali pesi futuri. Questo articolo esamina l'articolo e il repository disponibile, senza sostenere di aver effettuato una riproduzione indipendente. Checklist del rilascio.
Gli autori identificano due direzioni di ricerca. Rappresentazioni 3D a maggiore fedeltà potrebbero catturare meglio strutture sottili come le fronde delle palme, che gli attuali latenti strutturati faticano a risolvere. Encoder visione-linguaggio più avanzati potrebbero migliorare la comprensione di prompt composizionali complessi; l'articolo mostra frutti arancioni che diventano texture arancione invece di oggetti separati. Limitazioni e sviluppi futuri. Le milestone di rilascio ancora mancanti del progetto sono i pesi del modello su Hugging Face e il codice completo per inferenza, addestramento e valutazione. Elenco ufficiale delle attività.
Domande frequenti
SeMo3D può generare o modificare un asset solo a partire dal testo?
No. Il documento richiede la guida tramite immagini; il testo e i punti sparsi sono condizioni aggiuntive facoltative. Anche la modifica richiede una regione selezionata e il contesto sorgente. Le dimostrazioni dell'agente in linguaggio naturale includono la preparazione dell'immagine, anziché rimuovere il requisito dell'immagine. [Fonte](https://arxiv.org/html/2611.02568v1#S3.SS2).
Posso sostituire lo schienale di una sedia mantenendo il resto?
Ciò illustra il flusso di lavoro previsto per la modifica locale: selezionare la regione dello schienale, fornire indicazioni e sintetizzarne i token riutilizzando i token di contesto. La conservazione esatta si applica ai token latenti; non va interpretata come una garanzia che ogni vertice decodificato rimanga identico. [Fonte](https://arxiv.org/html/2611.02568v1#S3.SS3).
Posso distribuire SeMo3D localmente ora?
Come verificato il 6 novembre 2026, i pesi del modello e il codice completo per l'inferenza, l'addestramento e la valutazione restano traguardi di rilascio non verificati. Il paper pubblico e le dimostrazioni consentono una valutazione tecnica, ma il repository non fornisce ancora lo stack completo per la distribuzione locale. [Source](https://github.com/XiaokunSun/SeMo3D#-todo).




