Frontier3DBench: benchmark degli agenti di programmazione per la creazione 3D tra oggetti, scene e mondi aperti
Frontier3DBench valuta la capacità degli agenti di programmazione di creare progetti 3D modificabili ed eseguibili tra oggetti, scene e mondi aperti interattivi.
Articolo originale: Frontier3DBench: Benchmarking degli agenti di coding per la creazione 3D tra oggetti, scene e mondi aperti interattivi (6 novembre 2026; v1).
Punti salienti e risultati
Frontier3DBench valuta se gli agenti di coding siano in grado di fornire progetti 3D modificabili ed eseguibili relativi a oggetti, scene e mondi interattivi. Per i team che scelgono un flusso di lavoro di authoring tramite IA, il suo contributo è un framework di valutazione comune: 145 attività suddivise in nove famiglie, tra cui 65 attività su oggetti in Blender, 65 attività su scene in Blender e 15 attività su mondi in Unreal Engine. Gli input includono istruzioni, immagini di riferimento, fotografie e scene esistenti.
Gli autori valutano 11 configurazioni modello–harness. GPT-6.1-sol con Codex è in testa nella classifica generale con 66.02/100; GPT-6-astra con Codex è in testa nei mondi interattivi con 61.28. Ogni configurazione ottiene risultati peggiori nella ricostruzione da riferimento rispetto alla generazione di oggetti e scene guidata dal testo. Su 165 invii relativi ai mondi, i meccanismi locali hanno una media di 83.08, la distanza delle parti mobili 20.82 e i flussi di lavoro con stato 30.26. Si tratta di punteggi dei componenti, non di percentuali di mondi completati con successo.
Uno studio umano fornisce una calibrazione limitata: otto valutatori classificano quattro candidati per ciascuno dei 45 elementi relativi a oggetti/scene condizionati da riferimento. I punteggi automatici raggiungono un tau-b di Kendall medio pari a 0.727 e un accordo del 79.2% sul vincitore, ma solo un accordo del 44.7% sulla classifica completa. Questo non convalida ogni famiglia di attività né il comportamento nei mondi. Vedere gli esperimenti.
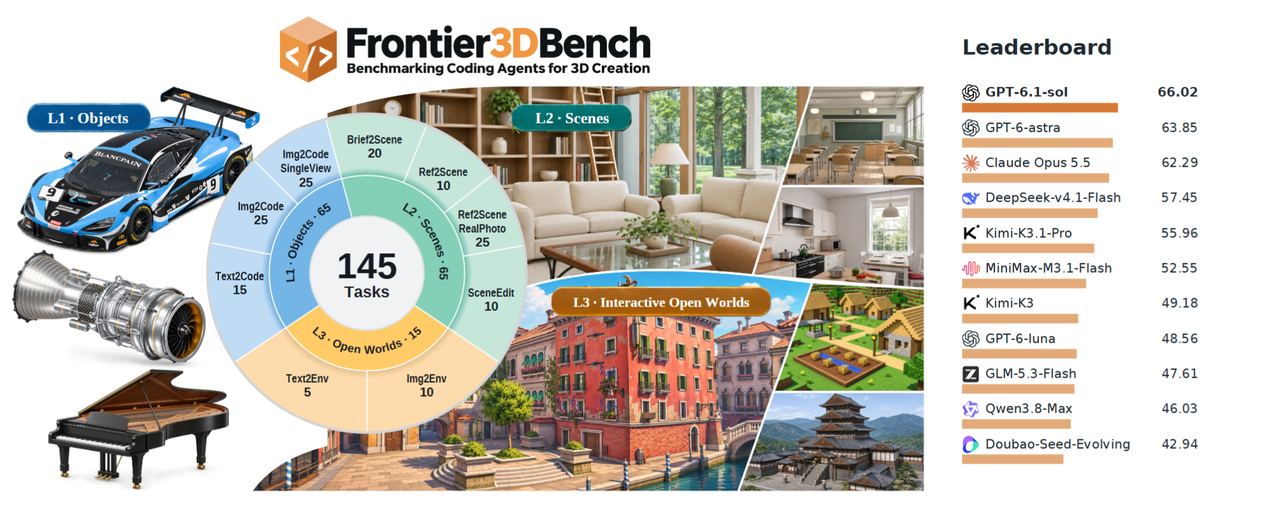
Come funziona la valutazione
L'agente riceve un contratto dell'attività: geometria e aspetto richiesti, immagini di riferimento quando applicabili e risorse iniziali da modificare. Le attività relative ai mondi definiscono inoltre entità, stati iniziali, operazioni consentite e prerequisiti. L'agente scrive ed esegue codice di costruzione, quindi invia un progetto nativo Blender o Unreal insieme alle esportazioni richieste. I file di valutazione rimangono al di fuori del suo spazio di lavoro.
Nell'orchestratore rilasciato, i controlli pubblici dell'esecuzione possono attivare riparazioni, ma l'agente riceve errori anziché punteggi privati. Il codice sorgente accettato viene congelato e sottoposto ad hashing prima della valutazione. Valutatori separati rieseguono il programma, ispezionano la geometria nativa, eseguono il rendering delle viste e giudicano il completamento dell'attività. Il documento utilizza Blender 5.2.1 e Unreal Engine 5.8.3; la generazione L1/L2 consente fino a sei tentativi nell'arco di 32 ore. Si tratta di limiti di budget, non di tempi di completamento misurati.
Il punteggio cambia in base all'attività. La ricostruzione da riferimento combina il 50% di similarità dell'immagine, il 20% di localizzazione dell'oggetto proiettato, il 20% di valutazione visiva e il 10% di dettaglio. La similarità dell'immagine misura struttura, bordi, colore e tonalità; la localizzazione confronta i riquadri degli oggetti e penalizza le istanze mancanti o aggiuntive. GPT-6-astra, con impegno medio, valuta criteri visivi fissi con l'identità del generatore nascosta. I controlli dei dettagli utilizzano la copertura moltiplicata per uno meno la deviazione, quindi prendono la variante di esecuzione/esportazione richiesta più debole. Le normali attività L1 esaminano quattro esecuzioni in formato nativo e GLB; L2 utilizza quattro varianti native.
La modifica delle scene misura separatamente la modifica richiesta e la conservazione degli ambienti protetti. La valutazione dei mondi ricostruisce il progetto inviato con un osservatore indipendente e verifica gli effetti visibili delle azioni, le intersezioni tra parti mobili, l'effettivo movimento del personaggio e lo stato persistente. I flussi di lavoro continui vietano il teletrasporto e i reset. L'apertura di una porta in isolamento non può quindi sostituire il completamento di un percorso che richiede di raggiungerla, sbloccarla e attraversarla.
I punteggi dei mondi ponderano qualità visiva, fedeltà all'attività, layout e interazione con pesi pari a 60/20/5/15. Il punteggio finale del benchmark pondera L1/L2/L3 con 30/30/40. Il contratto di valutazione distingue i difetti confermati del candidato dalle prove tecniche mancanti: un errore dell'API o della misurazione non deve diventare silenziosamente zero.
Applicazioni e sfide aperte
Il benchmark supporta la selezione dei flussi di lavoro con agenti di coding e la diagnosi del fatto che i fallimenti riguardino aspetto, geometria, modifica o comportamento. Il suo repository aperto include input delle attività, codice di generazione/valutazione e contratti di valutazione; il software del benchmark utilizza Apache-2.0, mentre le risorse delle attività mantengono le proprie licenze. Blender, Unreal Engine e l'accesso ai modelli richiedono configurazioni separate.
Il documento individua due sfide aperte centrali: riprodurre la geometria e i layout specificati e coordinare parti mobili, azioni e stato persistente. Queste sono le direzioni di ricerca degli autori, non funzionalità di prodotto annunciate. I confronti descrivono configurazioni complete di modello–harness e la valutazione visiva conserva limiti di calibrazione; inoltre, le attività fotografiche non dispongono di un ground truth 3D nativo universale. Questa recensione analizza il documento e l'implementazione, ma non riesegue il benchmark.
Domande frequenti
Frontier3DBench è di per sé un modello di generazione 3D?
No. Fornisce attività e valutatori per agenti di programmazione che costruiscono progetti Blender e Unreal. Non introduce un generatore di mesh addestrato né una nuova rappresentazione latente 3D.
Perché gli screenshot non sono sufficienti per una candidatura?
Il contratto richiede artefatti nativi modificabili e un comportamento eseguibile. I valutatori ispezionano la geometria, rieseguono il rendering delle scene salvate e testano le interazioni, quindi il solo aspetto non può dimostrare la correttezza.
Il punteggio complessivo più alto identifica il miglior agente per ogni incarico?
No. I leader variano in base alla famiglia di attività e il punteggio include l'harness e la configurazione del ragionamento. Confronta il profilo dell'attività pertinente prima di scegliere un flusso di lavoro.




