UltraTex: Memanfaatkan Difusi Multi-Tampilan 2K untuk Tekstur 3D
UltraTex adalah proyek SIGGRAPH Asia 2026 yang memanfaatkan model difusi multi-tampilan untuk menghasilkan tekstur beresolusi tinggi (2K) untuk mesh 3D dari gambar referensi, mengatasi keterbatasan resolusi yang lebih rendah seperti 512 atau 768.

Sorotan dan Hasil: Detail Lebih Banyak, Komputasi yang Terbuang Lebih Sedikit
Makalah asli: UltraTex: Unleashing 2K Multi-View Diffusion for 3D Texturing
UltraTex menghasilkan tekstur terperinci untuk mesh 3D yang sudah ada menggunakan gambar referensi. Dipresentasikan sebagai proyek SIGGRAPH Asia 2026, teknologi ini mengatasi hambatan umum: tekstur multi-tampilan pada resolusi 512 atau 768 kehilangan pola halus dan detail permukaan. UltraTex meningkatkan tampilan yang dihasilkan menjadi 2048 × 2048 dengan memusatkan komputasi pada latar depan objek. Kontribusi utamanya adalah menjadikan difusi multi-tampilan beresolusi tinggi praktis melalui perubahan terkoordinasi pada pemrosesan token, perhatian, dan dekode. Proyek resmi.
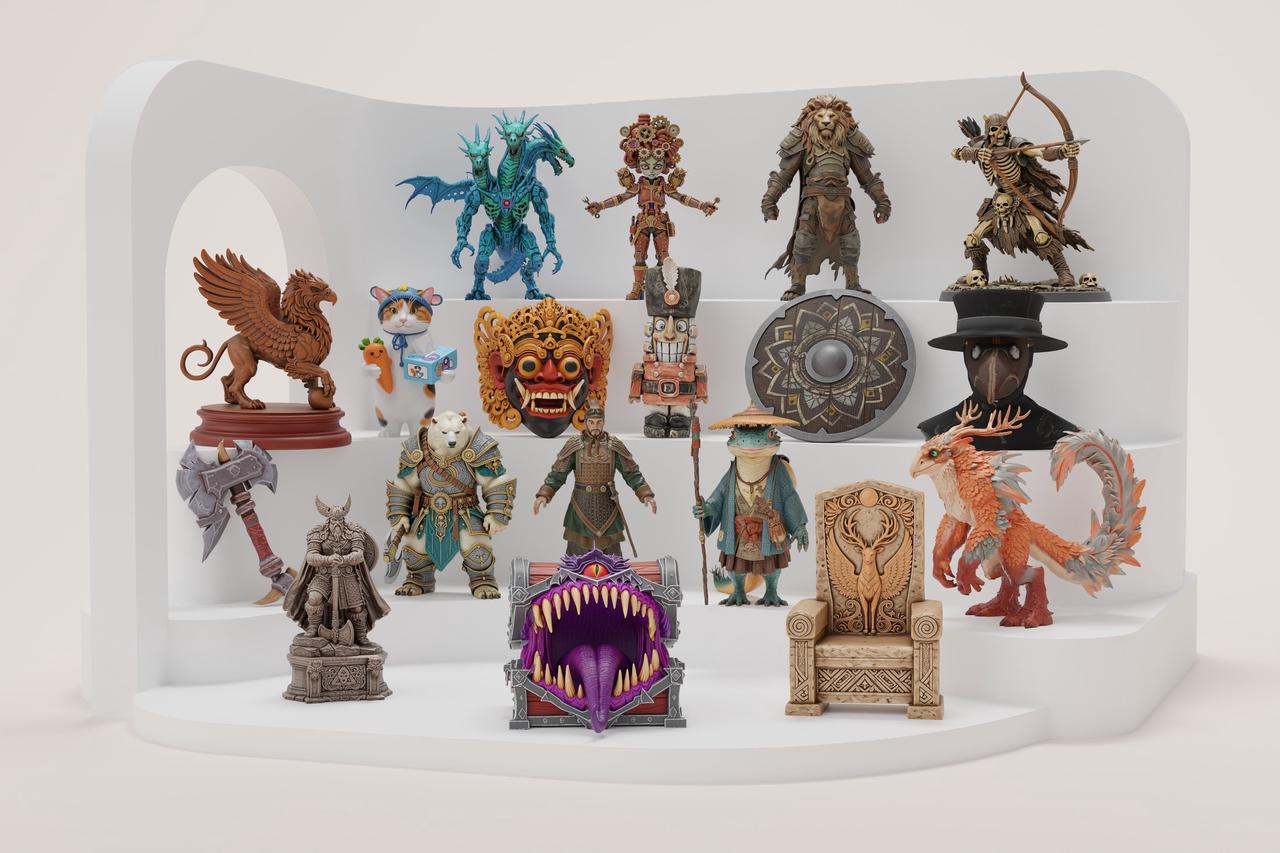
Pada 100 objek TexVerse yang disisihkan untuk pengujian, UltraTex melaporkan LPIPS tanpa bayangan sebesar 0.082 dibandingkan dengan 0.138 milik LumiTex, dengan nilai yang lebih rendah menunjukkan kesesuaian perseptual yang lebih dekat. Pada satu H200, penulis melaporkan peningkatan kecepatan pelatihan sebesar 20.6–91.1× dan inferensi sebesar 22.3–74.6× dibandingkan baseline padat untuk okupansi latar depan 10–30% dengan retensi blok perhatian 20%. Ini adalah hasil yang bergantung pada konfigurasi, bukan percepatan tetap untuk setiap aset atau alur kerja produksi lengkap. Makalah, eksperimen.
Cara Kerjanya: Dari Gambar Referensi ke Permukaan Bertekstur
Pipeline ini pertama-tama merender enam peta normal dari mesh input: empat tampilan samping, satu tampilan atas, dan satu tampilan bawah. VAE menyandikan panduan geometri dan gambar referensi menjadi latensi. Transformer difusi FLUX yang telah dilatih sebelumnya kemudian menghasilkan enam tampilan tekstur yang sesuai melalui pencocokan aliran; pipeline lengkap makalah ini memproyeksikannya kembali ke mesh. Pada 2K, enam tampilan target, enam tampilan geometri, dan satu referensi menyumbang 212,992 token gambar, yang menjelaskan mengapa pemrosesan padat menjadi mahal. Pipeline; penjelasan biaya token.
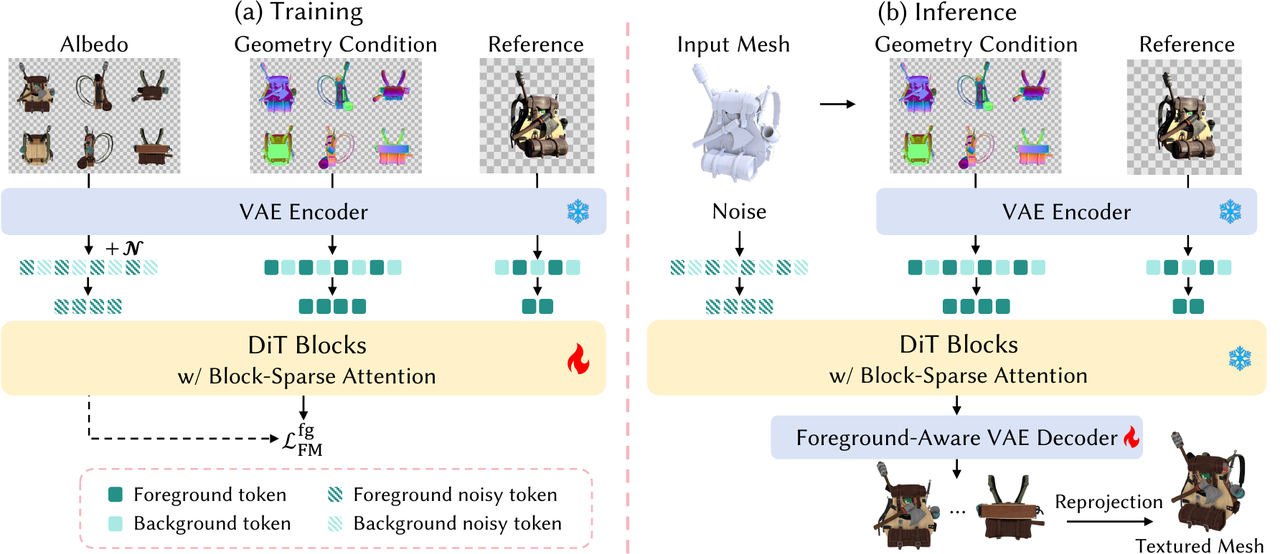
Background Token Dropping menghapus token gambar di luar objek sebelum blok transformer. Mask mengidentifikasi posisi yang dipertahankan, sementara embedding posisi rotari (RoPE) asli yang sesuai tetap terpasang. Urutan menjadi lebih pendek tanpa kehilangan koordinat spasialnya. Hal ini menghemat pekerjaan di seluruh backbone, termasuk lapisan feed-forward. Dalam sampler yang dirilis, pembaruan Euler hanya mengubah posisi latar depan yang dipilih; noise latar belakang dibiarkan tidak berubah hingga persiapan dekode. Pemilihan token; implementasi sampling.
Block-Sparse Attention mengurangi biaya interaksi di antara token yang tersisa. Implementasinya merata-ratakan fitur kueri dan kunci di dalam blok, memperkirakan relevansinya, lalu memilih blok kunci dengan skor tertinggi untuk setiap blok kueri. Perhatian kemudian menggunakan fitur token asli di dalam blok-blok yang dipilih tersebut. Konfigurasi FLUX.1 mempertahankan 20% blok kunci: metode ini menghindari banyak interaksi tanpa mengurangi resolusi gambar. Pemilihan blok; konfigurasi perhatian.
Foreground-Aware VAE Decoding mengatasi konsekuensi dari melewati denoising latar belakang. Menggabungkan latar depan yang bersih dengan latar belakang yang bising dapat merusak rekonstruksi. UltraTex mengganti latar belakang dengan latensi yang disandikan dari gambar hitam polos, lalu menggunakan dekoder yang disesuaikan dengan komposit ini. Encoder tetap dibekukan; pelatihan dekoder meminimalkan galat rekonstruksi hanya pada piksel latar depan. Setelah dekode, skrip inferensi yang dirilis menyimpan gambar multi-tampilan. Mengintegrasikan output tersebut ke dalam aset mesh tetap memerlukan langkah reproyeksi atau baking. Pelatihan dekoder; output inferensi.
Fondasi datanya adalah G-buffer TexVerse. Rilis publiknya mencakup 351,847 aset BSDF, sementara UltraTex menggunakan subset pelatihan yang telah difilter, yang terdiri dari 268,365 aset. Hasil render menyediakan normal, koordinat, albedo, dan kanal material yang tersedia hingga 4096 × 4096. Resolusi data ini harus dibedakan dari generasi 2K UltraTex yang telah didemonstrasikan. Deskripsi dataset.
Aplikasi, Ketersediaan, dan Arah Masa Depan
UltraTex menargetkan tahap tampilan dalam pembuatan aset: menyediakan tekstur permukaan terperinci untuk geometri karakter, properti, dan objek yang sudah ada. Output default-nya adalah albedo, yang merepresentasikan warna permukaan tanpa pencahayaan yang sudah di-bake. Repositori saat ini juga menyediakan cabang metallic–roughness FLUX.2 dengan bobot LoRA terpisah. Ekstensi yang tersedia ini harus dibedakan dari benchmark albedo utama makalah, yang merender UltraTex dengan nilai roughness dan metallic tetap. Output material yang tersedia; pengaturan evaluasi.
Saat diperiksa pada 6 November 2026, kode pelatihan dan inferensi serta instruksi pengunduhan bobot tersedia untuk publik. Repositori ini mendukung varian FLUX.1-dev dan FLUX.2-Klein, yang masing-masing memerlukan file backbone, LoRA, dan dekoder yang sesuai. Lingkungan yang diuji menggunakan Python 3.12, CUDA 12.4, dan PyTorch 2.5.1. Artikel ini mengulas makalah dan implementasinya; artikel ini tidak mengklaim reproduksi kualitas atau kecepatan secara independen. Repositori resmi.
Penulis mengidentifikasi kesulitan pada tekstur yang sangat repetitif dan hilangnya detail akibat representasi terkompresi dari VAE yang telah dilatih sebelumnya. Arah yang mereka nyatakan untuk meningkatkan skala hingga 4K atau 8K adalah mendesain ulang model fondasi DiT–VAE yang secara native mendukung resolusi tersebut, karena backbone FLUX yang ada lebih sesuai untuk input sekitar 1K–2K. Ini tetap merupakan keterbatasan dan arah penelitian, bukan kemampuan resolusi tinggi yang telah dirilis. Makalah, keterbatasan.
Pertanyaan Umum
Apakah saya memerlukan mesh 3D sebelum menggunakan UltraTex?
Ya. UltraTex memberi tekstur pada geometri yang ada menggunakan gambar referensi dan tampilan normal yang diturunkan dari mesh. Ini cocok untuk tahap tampilan setelah pemodelan atau pembuatan geometri; ini tidak merekonstruksi mesh lengkap hanya dari gambar referensi. [Sumber](https://arxiv.org/html/2609.23169v1#S3).
Apakah inferensi secara langsung menghasilkan aset PBR yang sudah jadi?
Skrip yang dirilis menyimpan gambar multi-tampilan, yang masih perlu diproyeksikan ulang atau dibake ke mesh. Albedo adalah output default; ekstensi metallic–roughness FLUX.2 menggunakan bobot terpisah. Ekstensi tersebut tidak boleh disalahartikan sebagai evaluasi albedo utama dalam paper. [Sumber](https://github.com/yiboz2001/UltraTex#inference).
Apakah setiap aset akan mendapatkan peningkatan kecepatan yang dilaporkan?
Tidak. Percepatan yang dilaporkan diukur pada H200 dibandingkan dengan baseline padat dalam kondisi okupansi latar depan dan pengaturan retensi perhatian yang ditentukan. Cakupan objek, perangkat keras, dan konfigurasi memengaruhi penghematan; angka-angka tersebut tidak menjamin peningkatan kecepatan yang setara untuk seluruh pipeline aset Anda. [Sumber](https://arxiv.org/html/2609.23169v1#S4).


