Frontier3DBench: Pembandingan Agen Pengodean untuk Kreasi 3D pada Objek, Adegan & Dunia Terbuka
Frontier3DBench mengevaluasi kemampuan agen pemrograman untuk membuat proyek 3D yang dapat diedit dan dijalankan di berbagai objek, adegan, dan dunia terbuka interaktif.
Makalah asli: Frontier3DBench: Membandingkan Agen Pengodean untuk Kreasi 3D lintas Objek, Adegan, dan Dunia Terbuka Interaktif (6 November 2026; v1).
Sorotan dan Hasil
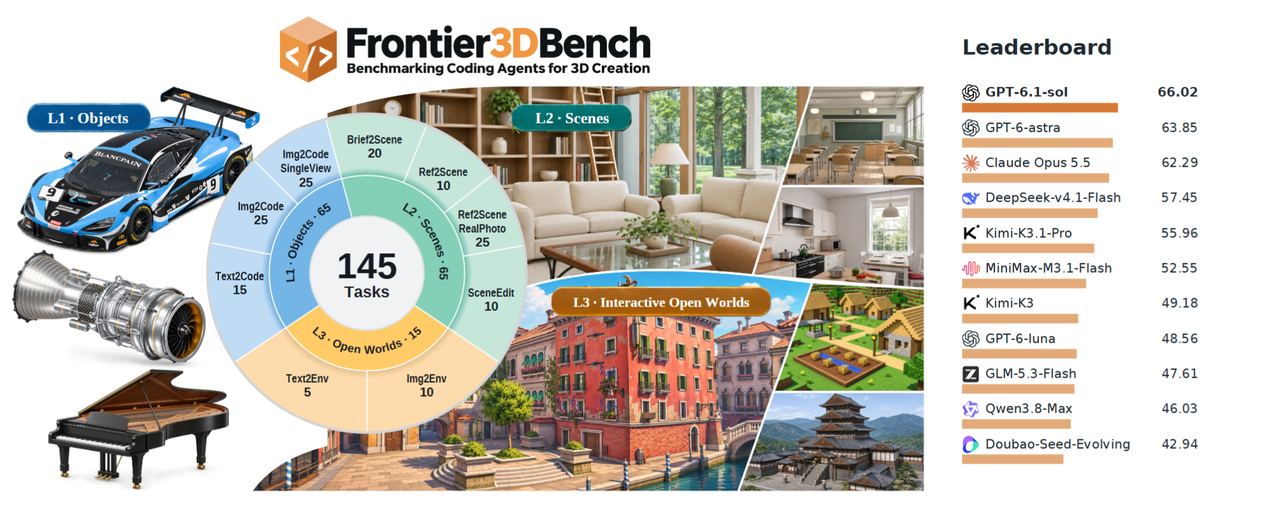
Frontier3DBench menanyakan apakah agen pengodean dapat menghasilkan proyek 3D yang dapat diedit dan dieksekusi di seluruh objek, adegan, dan dunia interaktif. Bagi tim yang memilih alur kerja pembuatan berbantuan AI, kontribusinya adalah kerangka evaluasi umum: 145 tugas dalam sembilan keluarga, termasuk 65 tugas objek Blender, 65 tugas adegan Blender, dan 15 tugas dunia Unreal Engine. Input mencakup instruksi, gambar referensi, foto, dan adegan yang sudah ada.
Penulis mengevaluasi 11 konfigurasi model–harness. GPT-6.1-sol dengan Codex memimpin secara keseluruhan dengan skor 66.02/100; GPT-6-astra dengan Codex memimpin dunia interaktif dengan skor 61.28. Setiap konfigurasi berkinerja lebih buruk pada rekonstruksi referensi dibandingkan pada pembuatan objek dan adegan berbasis teks. Dari 165 pengiriman dunia, mekanisme lokal rata-rata mendapat skor 83.08, jarak bebas bagian bergerak 20.82, dan alur kerja stateful 30.26. Ini adalah skor komponen, bukan persentase dunia yang berhasil diselesaikan.
Studi manusia menyediakan kalibrasi terbatas: delapan penilai mengurutkan empat kandidat pada masing-masing dari 45 item objek/adegan yang dikondisikan referensi. Skor otomatis mencapai rata-rata Kendall tau-b sebesar 0.727 dan kesepakatan 79.2% pada pemenang, tetapi hanya kesepakatan 44.7% pada peringkat lengkap. Hal ini tidak memvalidasi setiap keluarga tugas atau perilaku dunia. Lihat eksperimen.
Cara Kerja Evaluasi
Agen menerima kontrak tugas: geometri dan tampilan yang diwajibkan, gambar referensi jika berlaku, serta aset awal untuk diedit. Tugas dunia juga mendefinisikan entitas, keadaan awal, operasi yang diizinkan, dan prasyarat. Agen menulis dan mengeksekusi kode konstruksi, lalu mengirimkan proyek Blender atau Unreal native beserta ekspor yang diwajibkan. Berkas evaluasi tetap berada di luar ruang kerjanya.
Dalam orkestrator yang dirilis, pemeriksaan eksekusi publik dapat memicu perbaikan, tetapi agen menerima galat, bukan skor privat. Sumber yang diterima dibekukan dan di-hash sebelum evaluasi. Evaluator terpisah menjalankan ulang program, memeriksa geometri native, merender tampilan, dan menilai pemenuhan tugas. Makalah ini menggunakan Blender 5.2.1 dan Unreal Engine 5.8.3; pembuatan L1/L2 memungkinkan hingga enam percobaan dalam 32 jam. Ini adalah batas anggaran, bukan waktu penyelesaian yang diukur.
Penilaian berubah sesuai tugas. Rekonstruksi referensi menggabungkan 50% kemiripan gambar, 20% lokalisasi objek yang diproyeksikan, 20% penilaian visual, dan 10% detail. Kemiripan gambar mengukur struktur, tepi, warna, dan nada; lokalisasi mencocokkan kotak objek serta memberikan penalti untuk instance yang hilang atau ekstra. GPT-6-astra pada upaya sedang menilai kriteria visual tetap dengan identitas generator yang disembunyikan. Pemeriksaan detail menggunakan cakupan dikalikan satu dikurangi deviasi, lalu mengambil varian eksekusi/ekspor wajib yang paling lemah. Tugas L1 biasa memeriksa empat eksekusi dalam bentuk native dan GLB; L2 menggunakan empat varian native.
Pengeditan adegan secara terpisah mengukur modifikasi yang diminta dan pelestarian lingkungan yang dilindungi. Evaluasi dunia membangun ulang proyek yang dikirimkan dengan pengamat independen dan menguji efek tindakan yang terlihat, persinggungan bagian bergerak, pergerakan karakter yang sebenarnya, serta keadaan persisten. Alur kerja kontinu melarang teleportasi dan reset. Oleh karena itu, pembukaan pintu secara terisolasi tidak dapat menggantikan penyelesaian rute yang memerlukan tindakan mencapai, membuka kunci, dan melewatinya.
Skor dunia memberi bobot pada kualitas visual, kesetiaan terhadap tugas, tata letak, dan interaksi sebesar 60/20/5/15. Total akhir benchmark memberi bobot pada L1/L2/L3 sebesar 30/30/40. Kontrak penilaian membedakan cacat kandidat yang terkonfirmasi dari bukti teknis yang hilang: kegagalan API atau pengukuran tidak boleh secara diam-diam menjadi nol.
Aplikasi dan Tantangan Terbuka
Benchmark ini mendukung pemilihan alur kerja agen pengodean dan diagnosis apakah kegagalan berkaitan dengan tampilan, geometri, pengeditan, atau perilaku. Repositori terbukanya mencakup input tugas, kode pembuatan/evaluasi, dan kontrak penilaian; perangkat lunak benchmark menggunakan Apache-2.0, sementara aset tugas mempertahankan lisensinya masing-masing. Blender, Unreal Engine, dan akses model memerlukan penyiapan terpisah.
Makalah ini mengidentifikasi dua tantangan terbuka utama: mencocokkan geometri dan tata letak yang ditentukan, serta mengoordinasikan bagian bergerak, tindakan, dan keadaan persisten. Itu adalah arah penelitian penulis, bukan fitur produk yang diumumkan. Perbandingan menjelaskan penyiapan model–harness yang lengkap, dan penilaian visual tetap memiliki keterbatasan kalibrasi; tugas fotografi juga tidak memiliki ground truth 3D native yang universal. Tinjauan ini membaca makalah dan implementasinya, tetapi tidak menjalankan ulang benchmark.
Pertanyaan Umum
Apakah Frontier3DBench sendiri merupakan model generasi 3D?
Tidak. Ini menyediakan tugas dan evaluator untuk agen coding yang membangun proyek Blender dan Unreal. Ini tidak memperkenalkan generator mesh terlatih atau representasi laten 3D baru.
Mengapa tangkapan layar tidak memadai untuk pengajuan?
Kontrak tersebut mensyaratkan artefak native yang dapat diedit dan perilaku yang dapat dieksekusi. Evaluator memeriksa geometri, merender ulang adegan yang disimpan, dan menguji interaksi, sehingga tampilan saja tidak dapat membuktikan kebenaran.
Apakah skor keseluruhan tertinggi menunjukkan agen terbaik untuk setiap pekerjaan?
Tidak. Pemimpin berbeda menurut kelompok tugas, dan skor mencakup harness serta konfigurasi penalaran. Bandingkan profil tugas yang relevan sebelum memilih alur kerja.




