SeMo3D: चयनात्मक मॉडलिंग के माध्यम से 3D निर्माण, संपादन और पूर्णता का एकीकरण
SeMo3D चयनात्मक मॉडलिंग का उपयोग करके 3D निर्माण, स्थानीय संपादन और पूर्ति के लिए एक एकीकृत दृष्टिकोण प्रस्तुत करता है।

मुख्य बिंदु और परिणाम: महत्वपूर्ण चीज़ों को बदलना
मूल शोधपत्र: SeMo3D: चयनात्मक मॉडलिंग के माध्यम से 3D जनरेशन, संपादन और पूर्णता को एकीकृत करना
नानजिंग विश्वविद्यालय के शोधकर्ताओं द्वारा प्रस्तुत SeMo3D, 3D जनरेशन, स्थानीय संपादन और पूर्णता को एक ही फ्रेमवर्क में लाता है। AI एसेट निर्माण पर काम करने वाली टीमों के लिए इसका मुख्य वादा निरंतरता है: किसी ऑब्जेक्ट को बनाना, चुने गए क्षेत्र को संशोधित करना, या मौजूदा संदर्भ को बनाए रखते हुए किसी अनुपस्थित हिस्से का पुनर्निर्माण करना। इसका नाम Selective Modeling से आया है, जो ऐसी रणनीति है जिसमें संश्लेषित किया जाने वाला क्षेत्र इन कार्यों के बीच साझा इंटरफ़ेस बनता है। आधिकारिक रिपॉज़िटरी।
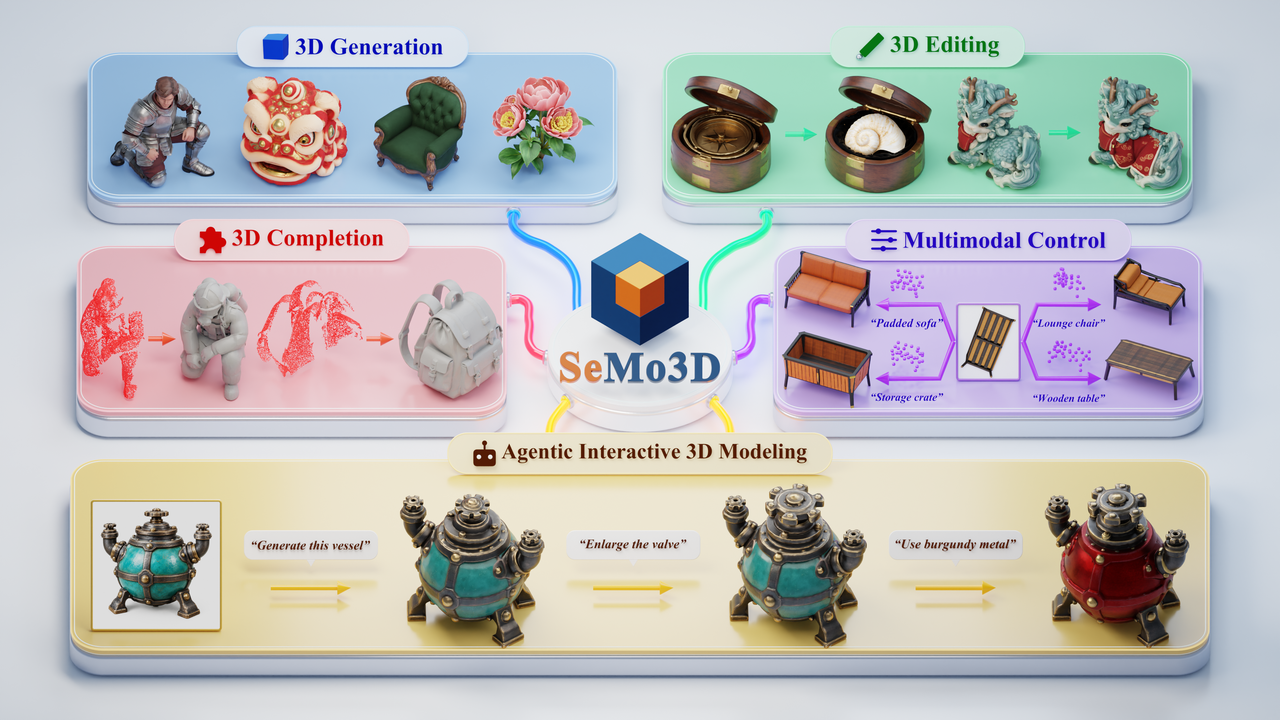
Toys4K पर, लेखक TRELLIS.2 के 0.0330 की तुलना में 0.0118 का ज्यामितीय Chamfer Distance रिपोर्ट करते हैं (कम मान बेहतर है)। संपादन संरक्षण 37.39 dB PSNR, VoxHammer के 31.55 dB की तुलना में, तक पहुँचता है। अतिरिक्त पॉइंट मार्गदर्शन के साथ पूर्णता F-score 0.541, HY3D-Omni के 0.412 की तुलना में, तक पहुँचता है। विभिन्न विधियों में समर्थित इनपुट अलग-अलग हैं, और पॉइंट संकेत ground truth से आते हैं; ये तुलनाएँ आर्किटेक्चर से होने वाले लाभों को अलग करके नहीं दिखातीं। शोधपत्र, तालिकाएँ 1–3।
यह कैसे काम करता है: चयन, संश्लेषण, संरक्षण
मुख्य अमूर्तन किसी एसेट को एक चयनित क्षेत्र S और संरक्षित संदर्भ C में विभाजित करता है। जनरेशन में सब कुछ चुना जाता है; संपादन में लक्ष्य चुना जाता है; पूर्णता में अनुपस्थित हिस्सा चुना जाता है। किसी कुर्सी के लिए, यही इंटरफ़ेस पूरी कुर्सी बना सकता है, उसकी बैकरेस्ट बदल सकता है, या अनुपस्थित पैर का पुनर्निर्माण कर सकता है। ये कार्य की परिभाषा के उदाहरणात्मक उपयोग हैं। मॉडल अलग-अलग कार्य-विशिष्ट प्रशिक्षण विधि की आवश्यकता के बजाय साझा क्षेत्रीय संश्लेषण समस्या सीखता है। रिपॉज़िटरी अवलोकन।
SeMo3D Trellis-500K पर TRELLIS.2 के तीन flow मॉडल को fine-tune करता है और इसके SC-VAE का पुनः उपयोग करता है। Sparse structure एक 16³ latent grid पर occupancy का पूर्वानुमान लगाता है; shape और texture एक 32³ grid में occupied positions पर काम करते हैं, जिससे geometry और PBR materials तैयार होते हैं। mask चरणों के बीच स्थानांतरित होता है। इस प्रकार, कार्यों का एकीकरण अभी भी तीन चरण-विशिष्ट मॉडलों का उपयोग करता है। शोधपत्र, विधि और प्रशिक्षण विवरण।
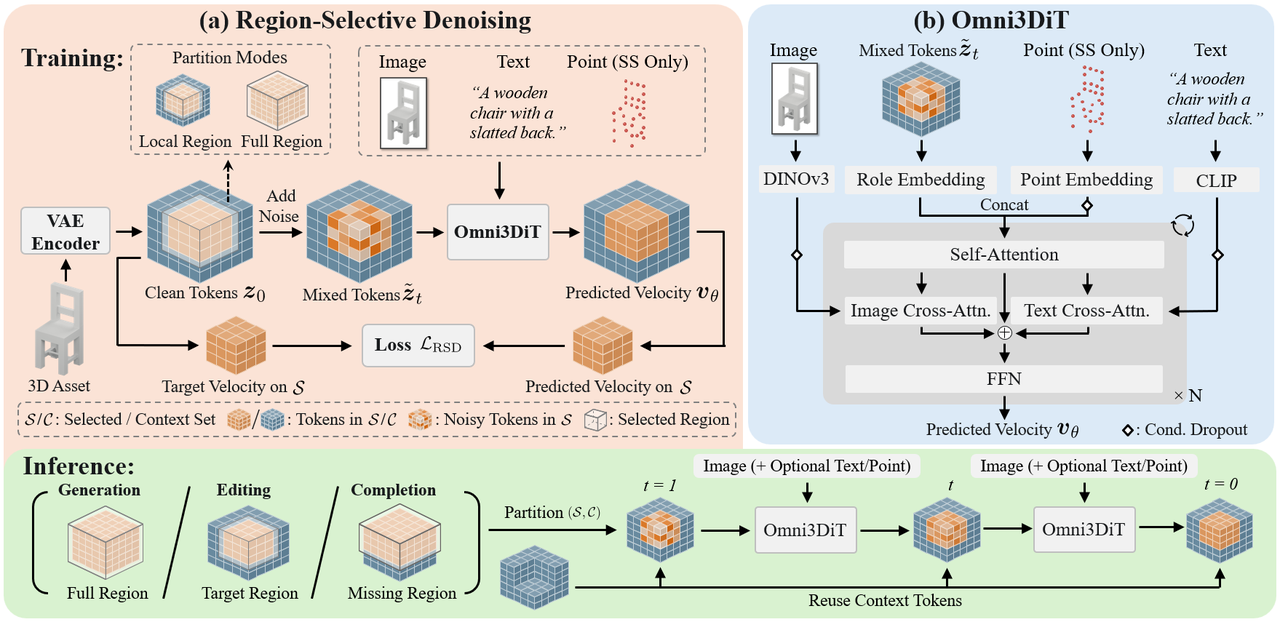
Region-selective denoising साधारण एसेट से प्रशिक्षण उदाहरण बनाता है। किसी यादृच्छिक क्षेत्र में noise जोड़ा जाता है, जबकि उसके आसपास का हिस्सा साफ रहता है; केवल उस क्षेत्र के पूर्वानुमान loss में योगदान देते हैं। प्रशिक्षण स्थानीय बॉक्स से लेकर पूर्ण एसेट तक होता है, जिससे पहले और बाद के युग्मित संपादन या पूर्णता डेटासेट की आवश्यकता नहीं रहती। inference के समय, चुने गए token noise से शुरू होते हैं और guidance के तहत विकसित होते हैं, जबकि मूल संदर्भ token हर चरण में पुनः उपयोग किए जाते हैं। इसलिए मॉडल पूरे ऑब्जेक्ट से संदर्भ ले सकता है, बिना उसके हर हिस्से का पुनः संश्लेषण किए। आधिकारिक विधि व्याख्या।
Omni3DiT इस मिश्रित इनपुट को समझने योग्य बनाता है। role embeddings चयनित और संदर्भ token की पहचान करते हैं। parallel cross-attention branches DINOv3 image features और CLIP text features को शामिल करती हैं; sparse-structure चरण में point token self-attention में प्रवेश करते हैं। Images appearance का मार्गदर्शन करती हैं, text semantic intent जोड़ता है, और points spatial layout को सीमित करते हैं। condition dropout प्रशिक्षण के दौरान उपलब्ध guidance को बदलता है, जिससे मॉडल को पूरक संकेतों का उपयोग करने के लिए प्रोत्साहित किया जाता है। आधिकारिक आर्किटेक्चर आरेख।
Image अब भी अनिवार्य है। Generation में प्रत्येक चरण के लिए 12 Euler steps का उपयोग होता है; editing/completion में structure के लिए 50 और shape तथा texture के लिए 12 steps का उपयोग होता है। कठोर संरक्षण latent token पर लागू होता है, आवश्यक रूप से प्रत्येक decoded vertex पर नहीं। शोधपत्र और inference परिशिष्ट।
अनुप्रयोग और आगे क्या है
व्यावहारिक अवसर पुनरावृत्तिमूलक कार्य में है: prop variants का अन्वेषण, अधूरे references की मरम्मत, और क्रमिक निर्देशों के माध्यम से एसेट को परिष्कृत करना। आधिकारिक प्रोजेक्ट reference images तैयार करने, edit regions की पहचान करने और SeMo3D को invoke करने वाले agent workflows का भी प्रदर्शन करता है। इससे कार्य-विभाजन का एक उपयोगी तरीका सामने आता है: agent intent को modeling request में बदलता है, जबकि 3D मॉडल क्षेत्रीय संश्लेषण संभालता है। इंटरैक्टिव प्रोजेक्ट प्रदर्शन।
तैयारी अभी सीमित है। 6 नवंबर 2026 को जाँच के अनुसार, आधिकारिक repository में documentation और demonstration assets मौजूद हैं; weights तथा training, inference और evaluation code अभी जारी नहीं किए गए हैं। इसका MIT license भविष्य के weights के लिए licensing terms निर्धारित नहीं करता। यह लेख शोधपत्र और उपलब्ध रिपॉज़िटरी की समीक्षा करता है, स्वतंत्र reproduction का दावा नहीं करता। Release checklist।
लेखक दो शोध दिशाओं की पहचान करते हैं। उच्च-निष्ठा वाले 3D representations palm fronds जैसी पतली संरचनाओं को बेहतर ढंग से पकड़ सकते हैं, जिन्हें वर्तमान structured latents स्पष्ट रूप से resolve करने में कठिनाई होती है। अधिक शक्तिशाली vision-language encoders जटिल compositional prompts की समझ में सुधार कर सकते हैं; शोधपत्र दिखाता है कि orange fruits अलग-अलग objects बनने के बजाय orange texture बन जाते हैं। सीमाएँ और भविष्य का कार्य। प्रोजेक्ट के शेष release milestones Hugging Face पर model weights और complete inference, training तथा evaluation code हैं। आधिकारिक TODO सूची।
अक्सर पूछे जाने वाले प्रश्न
क्या SeMo3D केवल टेक्स्ट से कोई एसेट जनरेट या संपादित कर सकता है?
नहीं। शोध-पत्र में इमेज मार्गदर्शन आवश्यक है; टेक्स्ट और विरल बिंदु वैकल्पिक अतिरिक्त शर्तें हैं। संपादन के लिए चयनित क्षेत्र और स्रोत संदर्भ भी आवश्यक हैं। प्राकृतिक-भाषा एजेंट के डेमोंस्ट्रेशन में इमेज हटाने के बजाय इमेज की तैयारी शामिल है। [Source](https://arxiv.org/html/2611.02568v1#S3.SS2).
क्या मैं बाकी हिस्से को बनाए रखते हुए कुर्सी की पीठ बदल सकता हूँ?
यह इच्छित स्थानीय-संपादन कार्यप्रवाह को दर्शाता है: बैकरेस्ट क्षेत्र चुनें, मार्गदर्शन प्रदान करें, और संदर्भ टोकनों का पुनः उपयोग करते हुए इसके टोकनों को संश्लेषित करें। सटीक संरक्षण latent टोकनों पर लागू होता है; इसे इस बात की गारंटी के रूप में नहीं समझना चाहिए कि प्रत्येक डिकोड किया गया शीर्षबिंदु समान रहेगा। [स्रोत](https://arxiv.org/html/2611.02568v1#S3.SS3).
क्या मैं अब SeMo3D को स्थानीय रूप से डिप्लॉय कर सकता/सकती हूँ?
6 नवंबर 2026 को जाँच के अनुसार, मॉडल वेट और पूर्ण इन्फ़रेंस, प्रशिक्षण तथा मूल्यांकन कोड अब भी ऐसे रिलीज़ माइलस्टोन हैं जिन पर काम पूरा होने की पुष्टि नहीं हुई है। सार्वजनिक शोध-पत्र और प्रदर्शन तकनीकी मूल्यांकन में सहायक हैं, लेकिन रिपॉज़िटरी अभी तक पूर्ण स्थानीय परिनियोजन स्टैक उपलब्ध नहीं कराती। [स्रोत](https://github.com/XiaokunSun/SeMo3D#-todo)




