UltraTex : Libérer la diffusion multi-vues 2K pour la texturation 3D
UltraTex est un projet de SIGGRAPH Asia 2026 qui exploite des modèles de diffusion multi-vues pour générer des textures haute résolution (2K) pour des maillages 3D à partir d'images de référence, remédiant aux limitations des résolutions inférieures comme 512 ou 768.

Points forts et résultats : plus de détails, moins de calcul gaspillé
Article original : UltraTex: Unleashing 2K Multi-View Diffusion for 3D Texturing
UltraTex génère des textures détaillées pour un maillage 3D existant à l’aide d’une image de référence. Présenté comme un projet de SIGGRAPH Asia 2026, il s’attaque à un goulot d’étranglement courant : la texturation multi-vues en résolution 512 ou 768 perd les motifs fins et les détails de surface. UltraTex augmente les vues générées à 2048 × 2048 en concentrant les calculs sur l’avant-plan de l’objet. Sa contribution centrale consiste à rendre la diffusion multi-vues haute résolution pratique grâce à des modifications coordonnées du traitement des tokens, de l’attention et du décodage. Projet officiel.
Sur 100 objets TexVerse mis de côté pour l’évaluation, UltraTex annonce un LPIPS non ombré de 0.082 contre 0.138 pour LumiTex, une valeur plus faible indiquant une meilleure concordance perceptuelle. Sur un seul H200, les auteurs rapportent des accélérations de 20.6 à 91.1× pour l’entraînement et de 22.3 à 74.6× pour l’inférence par rapport à la référence dense, avec une occupation de l’avant-plan de 10 à 30 % et une conservation de 20 % des blocs d’attention. Il s’agit de résultats dépendant de la configuration, et non d’une accélération fixe pour chaque ressource ou pour un flux de production complet. Article, expériences.
Fonctionnement : de l’image de référence à la surface texturée
Le pipeline commence par rendre six cartes de normales à partir du maillage d’entrée : quatre vues latérales, une vue du dessus et une vue du dessous. Un VAE encode les indications géométriques et l’image de référence en représentations latentes. Un transformeur de diffusion FLUX préentraîné génère ensuite six vues de texture correspondantes par appariement de flux ; le pipeline complet de l’article les reprojette sur le maillage. En 2K, six vues cibles, six vues géométriques et une référence représentent 212,992 tokens d’image, ce qui explique pourquoi le traitement dense devient coûteux. Pipeline ; explication du coût des tokens.
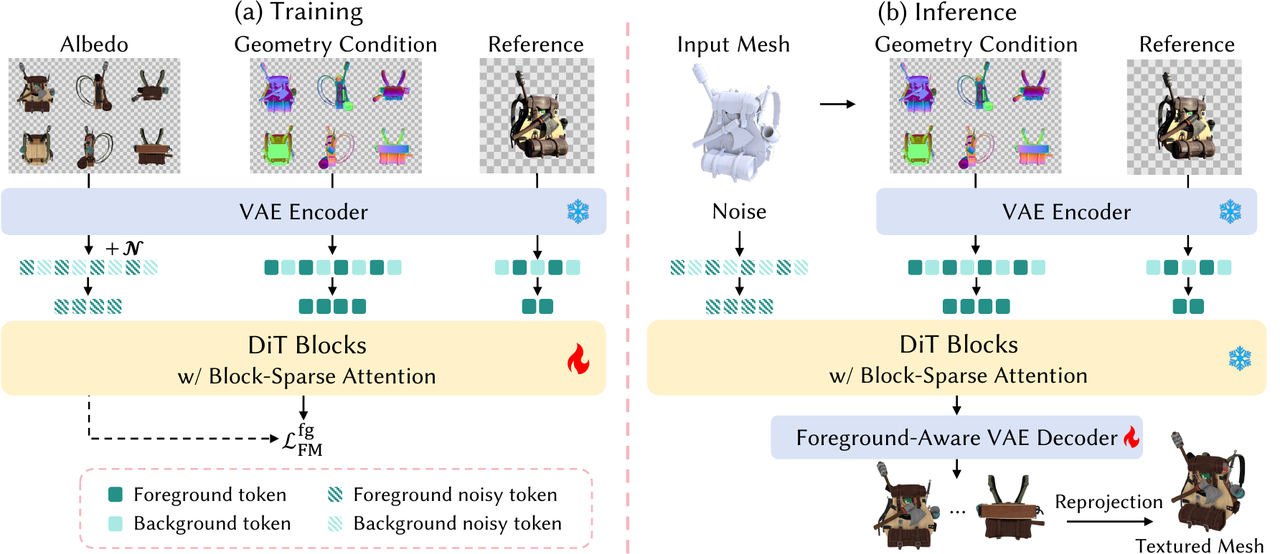
La suppression des tokens d’arrière-plan retire les tokens d’image situés hors de l’objet avant les blocs du transformeur. Les masques identifient les positions conservées, tandis que les embeddings positionnels rotatifs originaux (RoPE) correspondants restent attachés. La séquence devient plus courte sans perdre ses coordonnées spatiales. Cela réduit le travail dans tout le backbone, y compris dans les couches feed-forward. Dans l’échantillonneur fourni, les mises à jour d’Euler ne modifient que les positions sélectionnées de l’avant-plan ; le bruit d’arrière-plan reste inchangé jusqu’à la préparation du décodage. Sélection des tokens ; implémentation de l’échantillonnage.
L’attention parcimonieuse par blocs réduit le coût des interactions entre les tokens restants. L’implémentation moyenne les caractéristiques des requêtes et des clés au sein de blocs, estime leur pertinence et sélectionne les blocs de clés obtenant les scores les plus élevés pour chaque bloc de requêtes. L’attention utilise ensuite les caractéristiques originales des tokens à l’intérieur de ces blocs sélectionnés. La configuration FLUX.1 conserve 20 % des blocs de clés : elle évite de nombreuses interactions sans réduire la résolution de l’image. Sélection des blocs ; configuration de l’attention.
Décodage du VAE sensible à l’avant-plan traite la conséquence de l’omission du débruitage de l’arrière-plan. La combinaison d’un avant-plan net et d’un arrière-plan bruité peut altérer la reconstruction. UltraTex remplace l’arrière-plan par un latent encodé à partir d’une image noire unie, puis utilise un décodeur adapté à ce composite. L’encodeur reste gelé ; l’entraînement du décodeur minimise l’erreur de reconstruction uniquement sur les pixels de l’avant-plan. Après le décodage, les scripts d’inférence fournis enregistrent des images multi-vues. L’intégration de ces sorties dans une ressource maillée nécessite toujours l’étape de reprojection ou de baking. Entraînement du décodeur ; sorties d’inférence.
La base de données est G-buffer TexVerse. Sa version publique couvre 351,847 ressources BSDF, tandis qu’UltraTex utilise un sous-ensemble d’entraînement filtré de 268,365 ressources. Les rendus fournissent les normales, les coordonnées, l’albédo et les canaux de matériau disponibles jusqu’à 4096 × 4096. Il convient de distinguer cette résolution des données de la génération démontrée en 2K par UltraTex. Description du jeu de données.
Applications, disponibilité et orientations futures
UltraTex cible l’étape d’apparence de la création de ressources : fournir des textures de surface détaillées pour des géométries existantes de personnages, d’accessoires et d’objets. La sortie par défaut est l’albédo, qui représente la couleur de surface sans éclairage précalculé. Le dépôt actuel fournit également une branche FLUX.2 metallic–roughness avec des poids LoRA distincts. Cette extension disponible doit être distinguée du benchmark d’albédo principal de l’article, dans lequel UltraTex est rendu avec des valeurs fixes de rugosité et de métallicité. Sorties de matériaux disponibles ; paramètres d’évaluation.
Au 6 novembre 2026, le code d’entraînement et d’inférence ainsi que les instructions de téléchargement des poids sont publics. Le dépôt prend en charge les variantes FLUX.1-dev et FLUX.2-Klein, qui nécessitent chacune les fichiers correspondants du backbone, de LoRA et du décodeur. Son environnement testé utilise Python 3.12, CUDA 12.4 et PyTorch 2.5.1. Cet article examine l’article scientifique et l’implémentation ; il ne revendique pas une reproduction indépendante de la qualité ou de la vitesse. Dépôt officiel.
Les auteurs signalent des difficultés avec les textures très répétitives et une perte de détails due à la représentation compressée du VAE préentraîné. Leur orientation déclarée pour passer au 4K ou 8K consiste à reconcevoir des modèles de fondation DiT–VAE prenant nativement en charge ces résolutions, car le backbone FLUX existant est mieux adapté à des entrées d’environ 1K à 2K. Il s’agit encore de limitations et de pistes de recherche, et non de capacités haute résolution disponibles. Article, limitations.
FAQ
Ai-je besoin d'un maillage 3D avant d'utiliser UltraTex ?
Oui. UltraTex texture la géométrie existante à l’aide d’une image de référence et de vues normales dérivées du maillage. Il s’intègre à l’étape d’apparence après la modélisation ou la génération de géométrie ; il ne reconstruit pas un maillage complet à partir de la seule image de référence. [Source](https://arxiv.org/html/2609.23169v1#S3).
L’inférence fournit-elle directement un asset PBR terminé ?
Les scripts publiés enregistrent des images multivues, qui nécessitent encore une reprojection ou une cuisson sur le maillage. L’albédo est la sortie par défaut ; l’extension de rugosité métallique de FLUX.2 utilise des poids séparés. Cette extension ne doit pas être confondue avec l’évaluation principale de l’albédo présentée dans l’article. [Source](https://github.com/yiboz2001/UltraTex#inference).
Chaque ressource bénéficiera-t-elle de l'accélération annoncée ?
Non. L’accélération rapportée a été mesurée sur un H200 par rapport à une référence dense, avec des paramètres spécifiés d’occupation du premier plan et de rétention de l’attention. La couverture des objets, le matériel et la configuration influent sur les économies réalisées ; ces chiffres ne garantissent pas des gains de vitesse équivalents pour l’ensemble de votre pipeline de ressources. [Source](https://arxiv.org/html/2609.23169v1#S4).
Articles connexes

CoDimRecon : Reconstruction agentique de scènes 3D prêtes pour la simulation avec géométrie déformable
 v2fun · 11 nov. 2026

EasyMocap : Transformer une vidéo en mouvement humain 3D
v2fun · 11 nov. 2026
Workflow d’animation 3D par IA pour des prototypes de jeux jouables dès la première version
 Tammy · 11 août 2026