SeMo3D : Unifier la génération, l’édition et la complétion 3D par modélisation sélective
SeMo3D propose une approche unifiée de la génération 3D, de l’édition locale et de la complétion grâce à la modélisation sélective.

Points forts et résultats : changer ce qui compte
Article original : SeMo3D : unifier la génération, l’édition et la complétion 3D grâce à la modélisation sélective
SeMo3D, présenté par des chercheurs de l’université de Nankin, réunit la génération 3D, l’édition locale et la complétion au sein d’un même framework. Pour les équipes qui explorent la création d’assets par IA, sa promesse centrale est la continuité : créer un objet, modifier une région choisie ou reconstruire une section manquante tout en conservant le contexte existant. Son nom signifie Selective Modeling, une stratégie qui fait de la région à synthétiser l’interface commune entre ces tâches. Dépôt officiel.
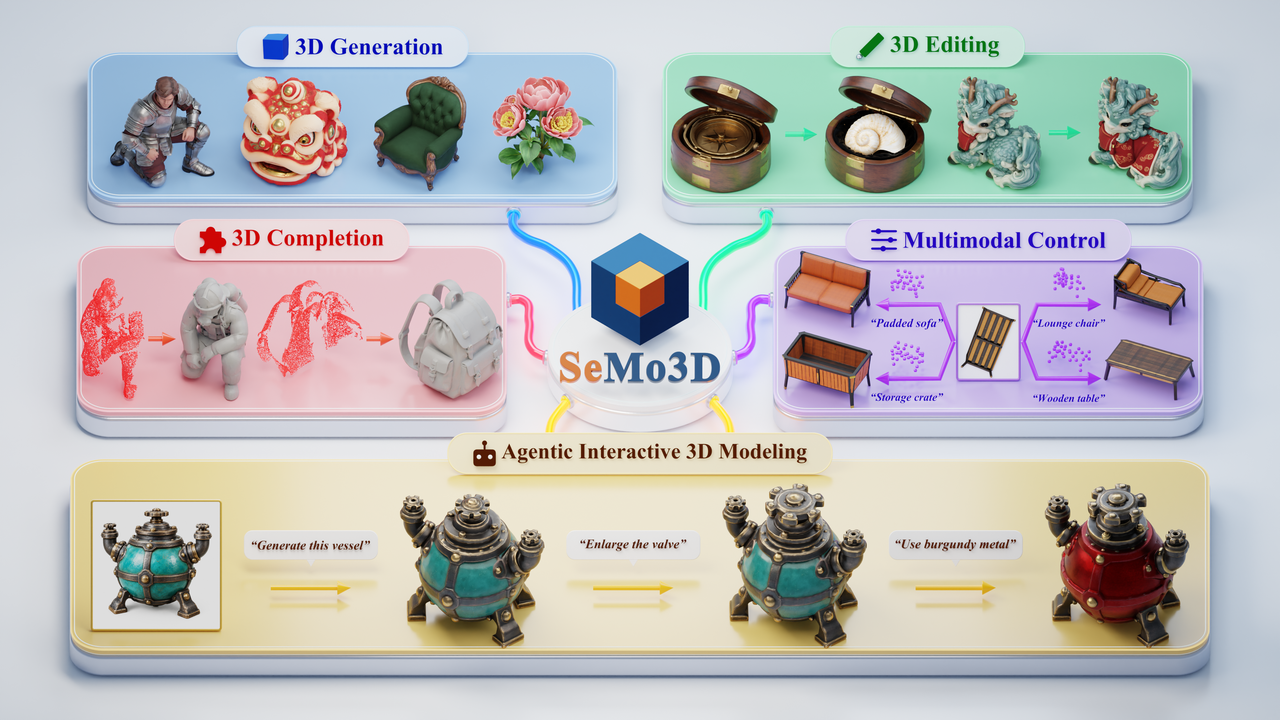
Sur Toys4K, les auteurs rapportent une distance de Chamfer géométrique de 0.0118 contre 0.0330 pour TRELLIS.2 (plus bas est préférable). La préservation lors de l’édition atteint 37.39 dB PSNR contre 31.55 dB pour VoxHammer. Le score F de complétion atteint 0.541 contre 0.412 pour HY3D-Omni avec un guidage supplémentaire par points. Les entrées prises en charge diffèrent selon les méthodes, et les indications par points proviennent de la vérité terrain ; ces comparaisons n’isolent pas les gains dus à l’architecture. Article, tableaux 1–3.
Fonctionnement : sélectionner, synthétiser, préserver
L’abstraction clé divise un asset en une région sélectionnée S et un contexte préservé C. La génération sélectionne tout ; l’édition sélectionne la cible ; la complétion sélectionne ce qui manque. Pour une chaise, la même interface pourrait créer la chaise entière, remplacer son dossier ou reconstruire un pied absent. Il s’agit d’exemples illustrant la définition de la tâche. Le modèle apprend un problème partagé de synthèse régionale au lieu de nécessiter une recette d’entraînement distincte pour chaque tâche. Vue d’ensemble du dépôt.
SeMo3D ajuste finement les trois modèles de flux de TRELLIS.2 sur Trellis-500K et réutilise son SC-VAE. La structure parcimonieuse prédit l’occupation sur une grille latente 16³ ; la forme et la texture opèrent aux positions occupées dans une grille 32³, produisant la géométrie et les matériaux PBR. Le masque est transféré entre les étapes. Ainsi, l’unification des tâches utilise toujours trois modèles spécifiques à chaque étape. Article, détails de la méthode et de l’entraînement.
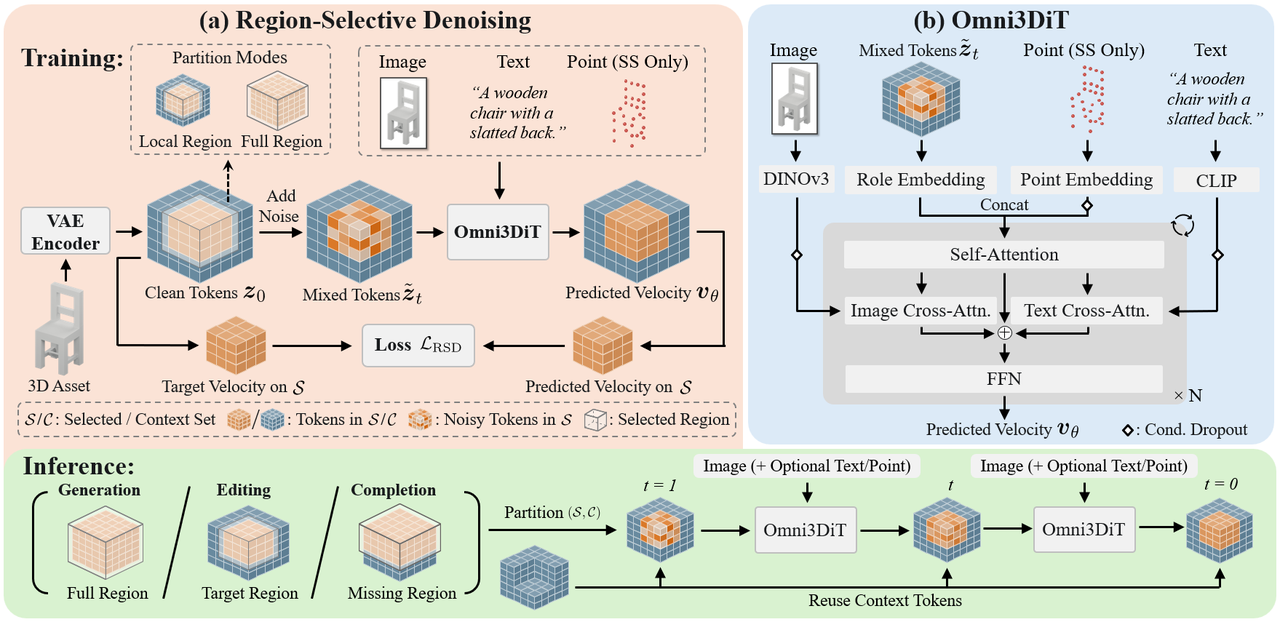
Le débruitage sélectif par région crée des exemples d’entraînement à partir d’assets ordinaires. Une région aléatoire reçoit du bruit tandis que ses environs restent propres ; seules les prédictions dans cette région contribuent à la perte. L’entraînement couvre des cadres locaux jusqu’aux assets complets, évitant les jeux de données appariés avant-après pour l’édition ou la complétion. Lors de l’inférence, les tokens sélectionnés partent du bruit et évoluent sous guidage, tandis que les tokens du contexte original sont réutilisés à chaque étape. Le modèle peut ainsi consulter l’objet entier sans le resynthétiser intégralement. Explication officielle de la méthode.
Omni3DiT permet de comprendre cette entrée mixte. Les embeddings de rôle identifient les tokens sélectionnés et ceux du contexte. Des branches d’attention croisée parallèles injectent les caractéristiques d’image DINOv3 et les caractéristiques textuelles CLIP ; les tokens de points entrent dans l’auto-attention à l’étape de la structure parcimonieuse. Les images guident l’apparence, le texte ajoute l’intention sémantique et les points contraignent la disposition spatiale. Le dropout des conditions varie les indications disponibles pendant l’entraînement, encourageant le modèle à exploiter les signaux complémentaires. Diagramme officiel de l’architecture.
Une image reste obligatoire. La génération utilise 12 étapes d’Euler par étape ; l’édition et la complétion en utilisent 50 pour la structure et 12 pour la forme et la texture. La préservation stricte s’applique aux tokens latents, pas nécessairement à chaque sommet décodé. Article et annexe sur l’inférence.
Applications et prochaines étapes
L’opportunité pratique réside dans le travail itératif : explorer des variantes d’accessoires, réparer des références incomplètes et affiner des assets au moyen d’instructions successives. Le projet officiel montre également des workflows d’agents qui préparent les images de référence, identifient les régions à modifier et appellent SeMo3D. Cela suggère une répartition utile des tâches : un agent traduit l’intention en requête de modélisation, tandis que le modèle 3D gère la synthèse régionale. Démonstrations interactives du projet.
Le niveau de préparation reste limité. Au 6 novembre 2026, le dépôt officiel contient de la documentation et des assets de démonstration ; les poids ainsi que le code d’entraînement, d’inférence et d’évaluation n’ont pas encore été publiés. Sa licence MIT ne définit pas les conditions de licence des futurs poids. Cet article examine l’article scientifique et le dépôt disponible, sans prétendre à une reproduction indépendante. Liste de contrôle de la publication.
Les auteurs identifient deux axes de recherche. Des représentations 3D plus fidèles pourraient mieux capturer les structures fines telles que les palmes de palmier, que les latents structurés actuels peinent à résoudre. Des encodeurs vision-langage plus puissants pourraient améliorer la compréhension de prompts compositionnels complexes ; l’article montre que des fruits orange deviennent une texture orange plutôt que des objets distincts. Limites et travaux futurs. Les étapes restantes de la publication du projet sont les poids du modèle sur Hugging Face ainsi que le code complet d’inférence, d’entraînement et d’évaluation. Liste TODO officielle.
FAQ
SeMo3D peut-il générer ou modifier une ressource à partir du seul texte ?
Non. L'article exige un guidage par image ; le texte et les points clairsemés sont des conditions supplémentaires facultatives. La modification nécessite également une région sélectionnée et le contexte source. Les démonstrations d'agent en langage naturel incluent la préparation de l'image plutôt que la suppression de l'exigence d'image. [Source](https://arxiv.org/html/2611.02568v1#S3.SS2).
Puis-je remplacer le dossier d’une chaise tout en gardant le reste ?
Cela illustre le flux de travail prévu pour la modification locale : sélectionner la région du dossier, fournir des indications et synthétiser ses jetons tout en réutilisant les jetons de contexte. La préservation exacte s'applique aux jetons latents ; elle ne doit pas être interprétée comme une garantie que chaque sommet décodé reste identique. [Source](https://arxiv.org/html/2611.02568v1#S3.SS3).
Puis-je déployer SeMo3D localement maintenant ?
Vérifié le 6 novembre 2026, les poids du modèle ainsi que le code complet d’inférence, d’entraînement et d’évaluation restent des jalons de publication non vérifiés. L’article public et les démonstrations permettent une évaluation technique, mais le dépôt ne fournit pas encore la pile complète de déploiement local. [Source](https://github.com/XiaokunSun/SeMo3D#-todo)




