Ling-3.2-flash : des références visuelles aux workflows 3D
Ling-3.2-flash est un modèle de fondation multimodal qui transforme des références visuelles en scripts exploitables pour les workflows 3D, permettant l’inspection et l’affinement itératifs des sorties rendues.

Points saillants et éléments probants
Ling-3.2-flash est le modèle de fondation multimodal d’Ant Ling pour interpréter des images, du texte et des vidéos, et accomplir des tâches via des outils. Pour les développeurs 3D, la démonstration intéressante est un flux de travail qui transforme une référence visuelle en scripts et inspecte à plusieurs reprises leurs résultats rendus. Les éléments probants publics concernent la création et la révision guidées par le modèle ; ils n’établissent pas l’existence d’un réseau dédié de conversion d’image en maillage.
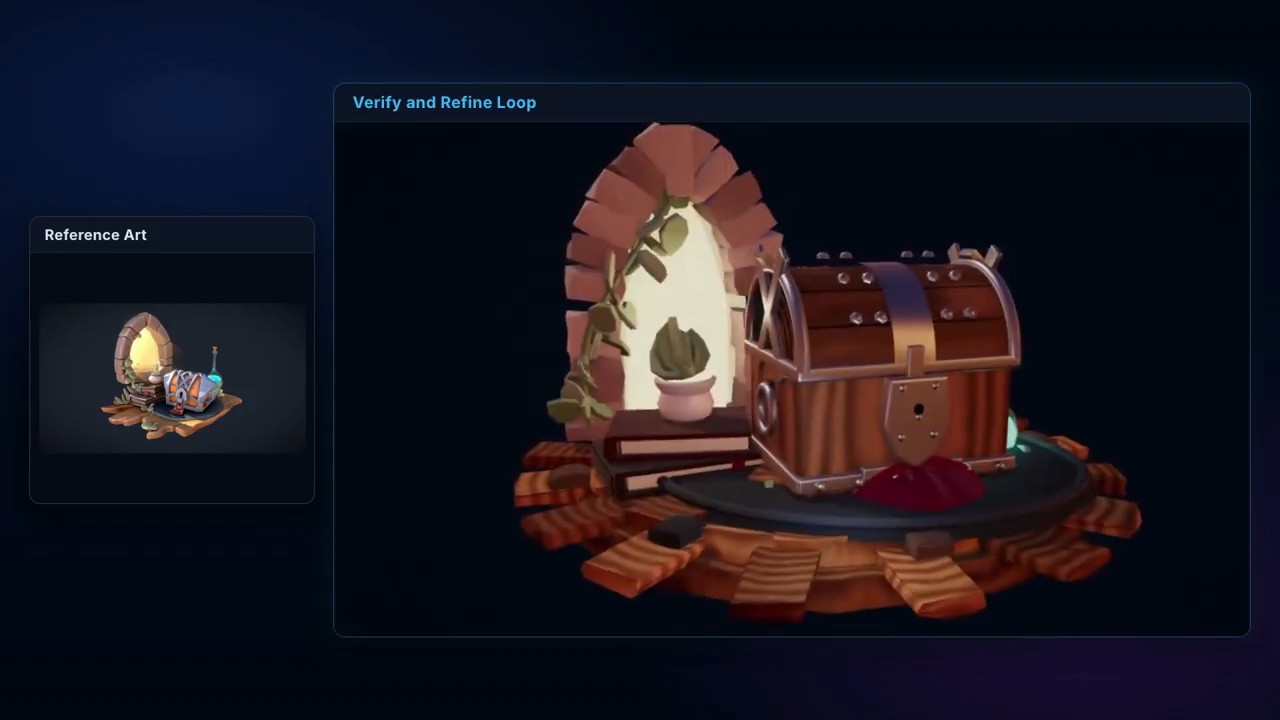
Source vidéo : Ant Ling — Scènes 3D à partir de références 2D.
Les spécifications officielles décrivent un modèle à mélange d’experts comptant 560 milliards de paramètres au total, dont environ 25 milliards sont activés par token, avec une fenêtre de contexte pouvant atteindre un million de tokens. La publication met l’accent sur la compréhension visuelle complexe, les agents multimodaux fonctionnant sur de longues durées, ainsi que sur la compréhension et l’interaction 3D.
Ant Ling rapporte un score de 92.21 sur OmniDocBench 1.5, de 43.71 sur ZEROBench (Sub) et de 85.86 sur Vision2Web, contre respectivement 90.56, 39.52 et 80.20 pour son modèle de comparaison Opus 5 max. Il s’agit de résultats rapportés par le fournisseur sur ces évaluations. Ils ne mesurent ni la précision géométrique 3D, ni l’exploitabilité des assets, ni le temps de modélisation de bout en bout. La publication examinée fournit des démonstrations plutôt qu’un benchmark standardisé de reconstruction 3D.
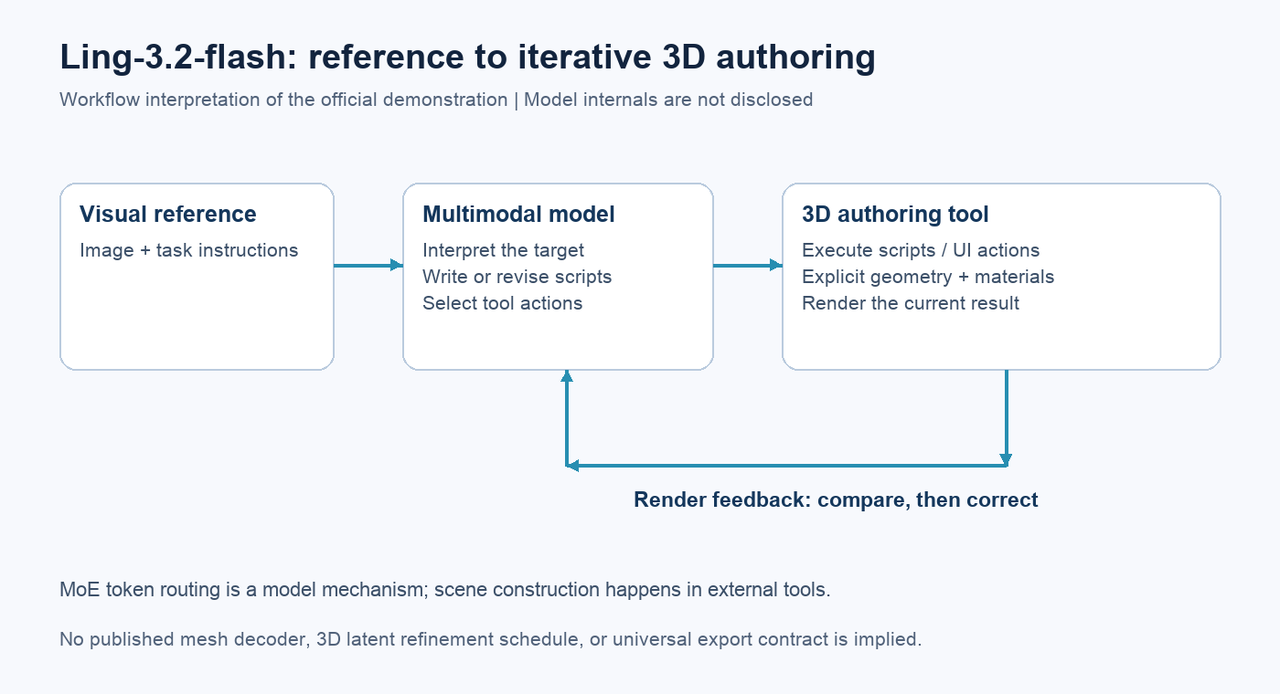
Fonctionnement du flux de travail 3D
L’exemple 3D officiel part d’une référence 2D et utilise des scripts pour recréer des assets de jeu ou de simulation. Le modèle examine des rendus headless de sphères de matériau, compare la rugosité, les effets des normal maps et les détails de bump, puis révise les scripts. Au niveau du flux de travail, la boucle consiste à interpréter la référence, construire le code, l’exécuter, inspecter visuellement le résultat et le corriger. La géométrie et les matériaux résident dans la scène générée par l’outil ; le modèle utilise des images de cette scène comme retour d’information.
Cela distingue deux représentations qu’il est facile de confondre. Le modèle neuronal traite un contexte multimodal, tandis que l’outil de création externe gère les objets de scène explicites, les paramètres de matériau et le code exécutable. Les modifications démontrées portent sur les scripts et l’état de l’outil. La publication ne révèle ni grille latente 3D, ni décodeur de tokens de maillage, ni calendrier de raffinement par diffusion, ni objectif d’entraînement géométrique ; ces mécanismes ne peuvent donc pas être déduits de la vidéo.
Le mécanisme MoE présenté concerne le calcul à l’intérieur du modèle de langage : le routage des tokens active des sous-réseaux experts sélectionnés plutôt que l’ensemble du pool de paramètres à chaque étape. Cela n’implique pas que chaque expert corresponde à une partie 3D. De même, une limite de contexte d’un million de tokens représente une capacité à conserver les informations de la tâche, et non la garantie qu’une longue session de modélisation restera précise.
Un autre exemple officiel montre une interaction avec Blender par l’intermédiaire d’actions dans l’interface et de modifications de paramètres, tandis qu’un autre convertit des dessins techniques en contenu web 3D. Ces exemples démontrent différentes interfaces d’outils, et non que chaque asset suit un pipeline fixe unique. Les documents publics ne précisent ni harnais d’agent 3D reproductible, ni budget d’itérations, ni règle d’arrêt, ni format d’export uniforme. La création d’une intégration comparable nécessite donc de fournir des outils d’exécution et de renvoyer leurs rendus ou leurs erreurs à l’agent.
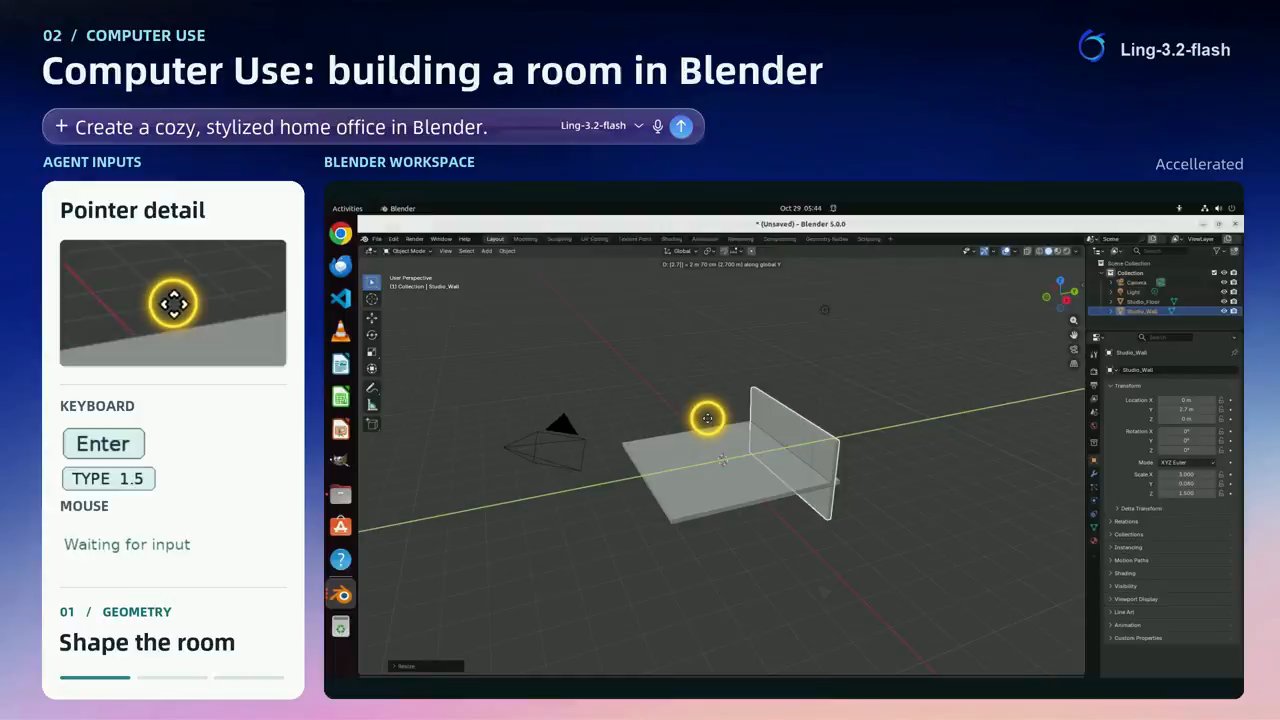
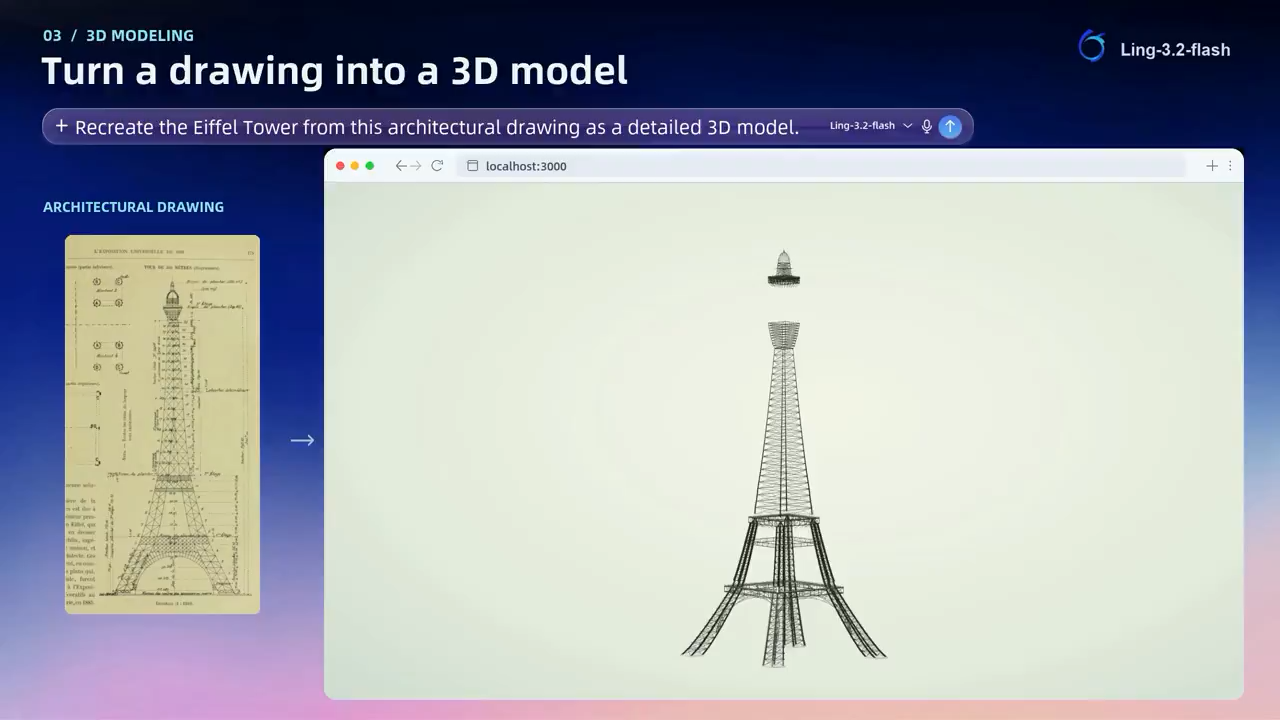
Source vidéo : Ant Ling — Conception frontend et outils professionnels. Ces exemples illustrent des flux de travail rapportés par l’auteur, et non des tests de précision indépendants.
Applications, accès et limites
Les démonstrations sont pertinentes pour le prototypage visuel, l’itération des matériaux et les assistants qui utilisent des logiciels 3D existants. Leur intérêt pratique tient au fait qu’une référence peut guider des modifications successives d’une scène, plutôt que de produire uniquement une description textuelle ponctuelle. La qualité des assets, leur éditabilité et les exports disponibles dépendent toujours des outils et de la tâche choisis.
La plateforme officielle propose un accès par chat et une documentation API avec des interfaces de requêtes compatibles avec OpenAI et Anthropic. Ces interfaces fournissent un accès au modèle ; une intégration fonctionnelle avec Blender reste distincte. La version 3.2 examinée ne fournit ni poids ouverts, ni article technique autonome, ni source du flux de travail de sa démonstration 3D. Les versions ouvertes antérieures de Ling ne doivent pas être considérées comme l’implémentation de la version 3.2.
Aucune feuille de route 3D spécifique à la version 3.2 ni liste de travaux futurs n’a été identifiée dans les documents officiels examinés. Cet article décrit donc les mécanismes et les démonstrations publiés, sans ajouter d’architectures proposées ni de capacités d’export promises. Le modèle et les démonstrations n’ont pas été exécutés indépendamment dans le cadre de cet examen.
FAQ
Le téléchargement direct d’une seule image renvoie-t-il un fichier GLB garanti ?
La démonstration officielle utilise un flux de travail de script et de rendu. Les documents examinés n’établissent ni point de terminaison fixe renvoyant un GLB ni contrat uniforme de livraison des ressources.
Le raffinement s'effectue-t-il dans un espace latent 3D publié ?
Aucun mécanisme de ce type n’est décrit. Le raffinement visible modifie les scripts et les paramètres de la scène après examen des résultats du rendu ; la représentation 3D interne du modèle n’est pas spécifiée.
De quoi a-t-on besoin pour reproduire un workflow Blender similaire ?
Un accès au modèle, une intégration qui exécute des scripts ou des actions d’interface utilisateur, et un moyen de réinjecter les rendus et les erreurs dans la conversation. Le harnais 3D officiel exact n’est pas fourni publiquement dans la version examinée.




