Frontier3DBench : benchmark des agents de programmation pour la création 3D à travers les objets, les scènes & les mondes ouverts
Frontier3DBench évalue la capacité des agents de programmation à créer des projets 3D modifiables et exécutables, couvrant les objets, les scènes et les mondes ouverts interactifs.
Article original : Frontier3DBench : évaluation comparative des agents de codage pour la création 3D à travers les objets, les scènes et les mondes ouverts interactifs (6 novembre 2026 ; v1).
Points saillants et résultats
Frontier3DBench cherche à déterminer si les agents de codage peuvent fournir des projets 3D modifiables et exécutables couvrant les objets, les scènes et les mondes interactifs. Pour les équipes qui choisissent un flux de travail de création assistée par IA, sa contribution est un cadre d’évaluation commun : 145 tâches réparties en neuf familles, dont 65 tâches d’objets Blender, 65 tâches de scènes Blender et 15 tâches de mondes Unreal Engine. Les entrées comprennent des instructions, des images de référence, des photographies et des scènes existantes.
Les auteurs évaluent 11 configurations modèle–dispositif d’exécution. GPT-6.1-sol avec Codex arrive en tête au classement général avec 66,02/100 ; GPT-6-astra avec Codex arrive en tête pour les mondes interactifs avec 61,28. Toutes les configurations obtiennent de moins bons résultats en reconstruction à partir d’une référence qu’en génération d’objets et de scènes guidée par du texte. Sur 165 soumissions de mondes, les mécanismes locaux obtiennent une moyenne de 83,08, le dégagement des pièces mobiles 20,82 et les flux de travail avec état 30,26. Il s’agit de scores de composantes, et non de pourcentages de mondes terminés avec succès.
Une étude humaine fournit un étalonnage limité : huit évaluateurs classent quatre candidats pour chacun des 45 éléments d’objets/scènes conditionnés par une référence. Les scores automatiques atteignent un tau-b de Kendall moyen de 0,727 et 79,2 % d’accord sur le gagnant, mais seulement 44,7 % d’accord sur le classement complet. Cela ne valide pas chaque famille de tâches ni les comportements des mondes. Voir les expériences.
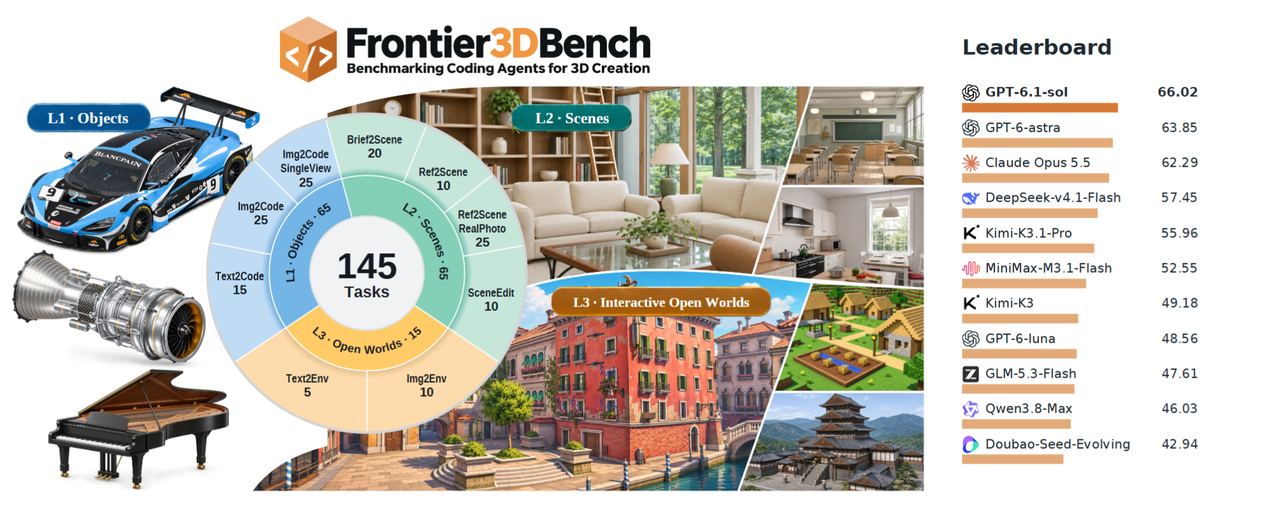
Fonctionnement de l’évaluation
L’agent reçoit un contrat de tâche : géométrie et apparence requises, images de référence le cas échéant, et ressources initiales à modifier. Les tâches de monde définissent en outre les entités, les états de départ, les opérations autorisées et les prérequis. L’agent écrit et exécute le code de construction, puis soumet un projet Blender ou Unreal natif ainsi que les exportations requises. Les fichiers d’évaluation restent en dehors de son espace de travail.
Dans l’orchestrateur publié, les vérifications publiques de l’exécution peuvent déclencher des réparations, mais l’agent reçoit des erreurs plutôt que des scores privés. Le code source accepté est figé et haché avant l’évaluation. Des évaluateurs distincts réexécutent le programme, inspectent la géométrie native, effectuent le rendu des vues et jugent la réalisation de la tâche. L’article utilise Blender 5.2.1 et Unreal Engine 5.8.3 ; la génération L1/L2 autorise jusqu’à six tentatives sur une période de 32 heures. Il s’agit de plafonds budgétaires, et non de temps d’exécution mesurés.
La notation varie selon la tâche. La reconstruction à partir d’une référence combine 50 % de similarité d’image, 20 % de localisation projetée de l’objet, 20 % de jugement visuel et 10 % de détails. La similarité d’image mesure la structure, les contours, la couleur et la tonalité ; la localisation fait correspondre les boîtes des objets et pénalise les instances manquantes ou supplémentaires. GPT-6-astra, avec un niveau d’effort moyen, juge des critères visuels fixes en masquant l’identité du générateur. La vérification des détails utilise la couverture multipliée par un moins l’écart, puis retient la variante d’exécution/exportation requise la plus faible. Les tâches L1 ordinaires inspectent quatre exécutions aux formats natif et GLB ; L2 utilise quatre variantes natives.
La modification de scènes mesure séparément la modification demandée et la préservation des environnements protégés. L’évaluation des mondes reconstruit le projet soumis avec un observateur indépendant et teste les effets visibles des actions, les intersections des pièces mobiles, le déplacement réel du personnage et la persistance de l’état. Les flux de travail continus interdisent la téléportation et les réinitialisations. L’ouverture d’une porte isolée ne peut donc pas se substituer à l’accomplissement d’un parcours nécessitant de l’atteindre, de la déverrouiller et de la franchir.
Les scores des mondes pondèrent la qualité visuelle, la fidélité à la tâche, la disposition et l’interaction à hauteur de 60/20/5/15. Le total final du benchmark pondère L1/L2/L3 à 30/30/40. Le contrat de notation distingue les défauts confirmés du candidat des preuves techniques manquantes : une défaillance d’API ou de mesure ne doit pas devenir silencieusement un zéro.
Applications et défis ouverts
Le benchmark aide à sélectionner des flux de travail reposant sur des agents de codage et à déterminer si les échecs concernent l’apparence, la géométrie, la modification ou le comportement. Son dépôt ouvert comprend les entrées des tâches, le code de génération/d’évaluation et les contrats de notation ; le logiciel du benchmark utilise Apache-2.0, tandis que les ressources des tâches conservent leurs propres licences. Blender, Unreal Engine et l’accès aux modèles nécessitent une configuration séparée.
L’article identifie deux défis ouverts centraux : faire correspondre la géométrie et les dispositions spécifiées, et coordonner les pièces mobiles, les actions et l’état persistant. Il s’agit des axes de recherche des auteurs, et non de fonctionnalités produit annoncées. Les comparaisons décrivent des configurations complètes modèle–dispositif d’exécution, et le jugement visuel conserve des limites d’étalonnage ; les tâches photographiques ne disposent pas non plus d’une vérité terrain 3D native universelle. Cette analyse s’appuie sur l’article et l’implémentation, mais ne réexécute pas le benchmark.
FAQ
Frontier3DBench lui-même est-il un modèle de génération 3D ?
Non. Il fournit des tâches et des évaluateurs pour des agents de codage qui construisent des projets Blender et Unreal. Il n'introduit ni générateur de maillages entraîné ni nouvelle représentation latente 3D.
Pourquoi les captures d’écran sont-elles insuffisantes pour une soumission ?
Le contrat exige des artefacts natifs modifiables et un comportement exécutable. Les évaluateurs inspectent la géométrie, effectuent un nouveau rendu des scènes enregistrées et testent les interactions ; l’apparence seule ne peut donc pas établir la conformité.
Le score global le plus élevé permet-il d'identifier le meilleur agent pour chaque tâche ?
Non. Les leaders diffèrent selon la famille de tâches, et le score inclut le harnais et la configuration de raisonnement. Comparez le profil de tâche pertinent avant de choisir un flux de travail.




