SeMo3D: Unificación de la generación, edición y completado 3D mediante modelado selectivo
SeMo3D presenta un enfoque unificado para la generación 3D, la edición local y la finalización mediante modelado selectivo.

Aspectos destacados y resultados: Cambiar lo que importa
Artículo original: SeMo3D: Unificación de la generación, edición y completado 3D mediante modelado selectivo
SeMo3D, presentado por investigadores de la Universidad de Nanjing, reúne la generación 3D, la edición local y el completado en un único marco. Para los equipos que exploran la creación de activos con IA, su promesa central es la continuidad: crear un objeto, revisar una región elegida o reconstruir una sección faltante conservando el contexto existente. El nombre significa Selective Modeling, una estrategia que convierte la región que se sintetizará en la interfaz común entre estas tareas. Repositorio oficial.
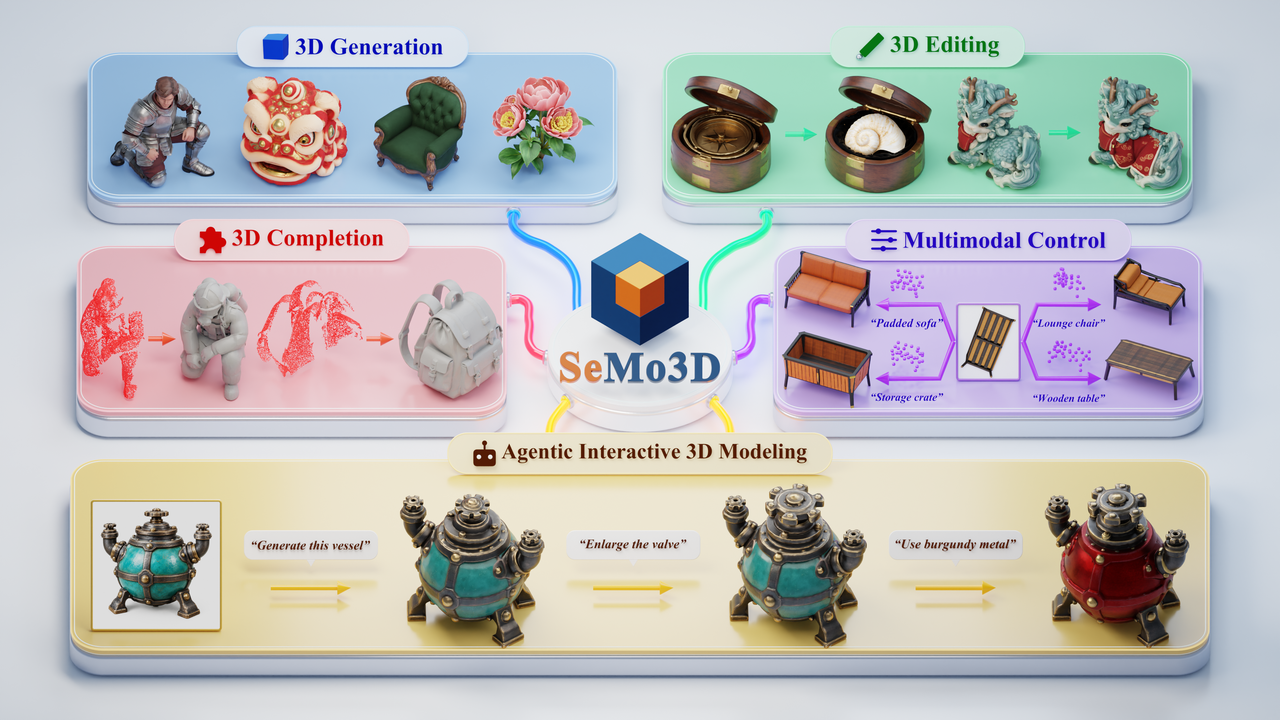
En Toys4K, los autores informan una distancia de Chamfer geométrica de 0.0118 frente a 0.0330 de TRELLIS.2 (un valor menor es mejor). La conservación durante la edición alcanza 37.39 dB PSNR frente a los 31.55 dB de VoxHammer. El F-score de completado alcanza 0.541 frente a 0.412 de HY3D-Omni con orientación adicional mediante puntos. Las entradas compatibles difieren entre los métodos, y las indicaciones de puntos proceden de la verdad fundamental; estas comparaciones no aíslan las mejoras de arquitectura. Artículo, tablas 1–3.
Cómo funciona: seleccionar, sintetizar, conservar
La abstracción clave divide un activo en una región seleccionada S y un contexto conservado C. La generación selecciona todo; la edición selecciona el objetivo; el completado selecciona lo que falta. Para una silla, la misma interfaz podría crear la silla completa, reemplazar su respaldo o reconstruir una pata ausente. Estos son usos ilustrativos de la definición de la tarea. El modelo aprende un problema compartido de síntesis regional en lugar de requerir una receta de entrenamiento específica para cada tarea. Descripción general del repositorio.
SeMo3D ajusta mediante fine-tuning los tres modelos de flujo de TRELLIS.2 en Trellis-500K y reutiliza su SC-VAE. La estructura dispersa predice la ocupación en una cuadrícula latente de 16³; la forma y la textura operan en las posiciones ocupadas de una cuadrícula de 32³, produciendo geometría y materiales PBR. La máscara se transfiere entre las etapas. Por tanto, la unificación de tareas sigue utilizando tres modelos específicos por etapa. Artículo, detalles del método y del entrenamiento.
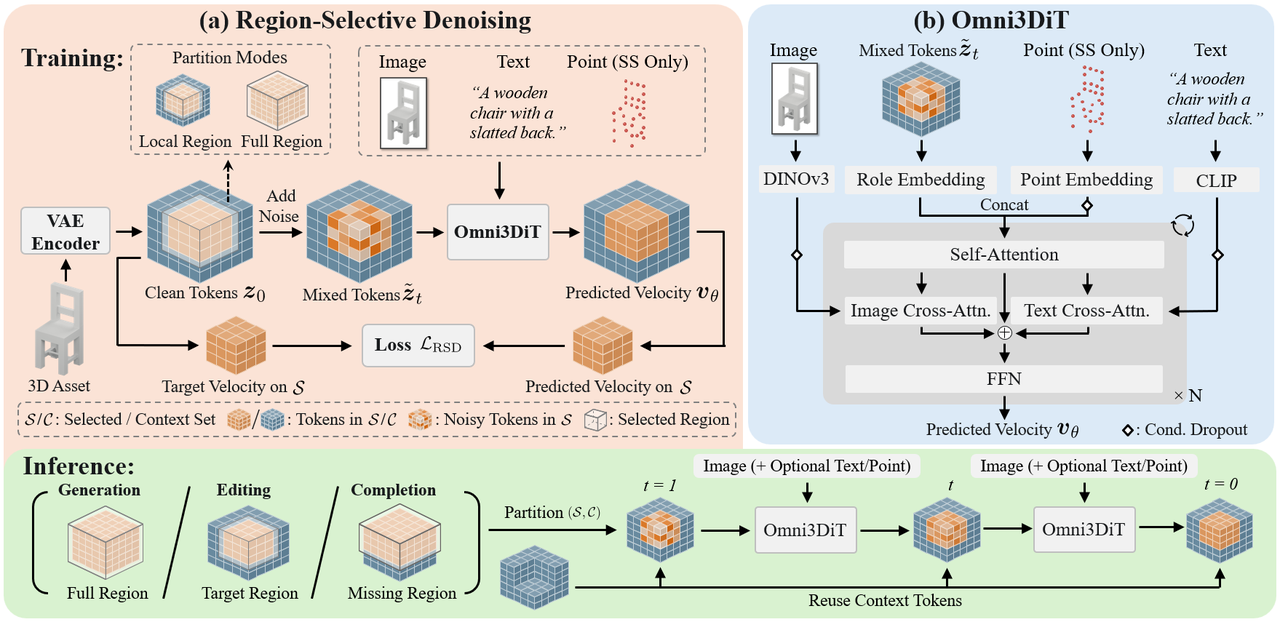
La eliminación de ruido selectiva por región crea ejemplos de entrenamiento a partir de activos ordinarios. Una región aleatoria recibe ruido mientras sus alrededores permanecen limpios; solo las predicciones de esa región contribuyen a la pérdida. El entrenamiento abarca desde recuadros locales hasta activos completos, evitando conjuntos de datos emparejados de edición o completado antes y después. Durante la inferencia, los tokens seleccionados parten del ruido y evolucionan bajo orientación, mientras que los tokens de contexto originales se reutilizan en cada paso. Por tanto, el modelo puede consultar el objeto completo sin volver a sintetizarlo en su totalidad. Explicación oficial del método.
Omni3DiT hace comprensible esa entrada mixta. Las incrustaciones de rol identifican los tokens seleccionados y de contexto. Las ramas paralelas de atención cruzada incorporan características de imagen de DINOv3 y características de texto de CLIP; los tokens de puntos entran en la autoatención en la etapa de estructura dispersa. Las imágenes orientan la apariencia, el texto añade intención semántica y los puntos restringen la disposición espacial. La eliminación de condiciones varía la orientación disponible durante el entrenamiento, lo que anima al modelo a utilizar las señales complementarias. Diagrama oficial de la arquitectura.
Una imagen sigue siendo obligatoria. La generación utiliza 12 pasos de Euler por etapa; la edición y el completado utilizan 50 para la estructura y 12 para la forma y la textura. La conservación estricta se aplica a los tokens latentes, no necesariamente a cada vértice decodificado. Artículo y apéndice de inferencia.
Aplicaciones y próximos pasos
La oportunidad práctica es el trabajo iterativo: explorar variantes de objetos, reparar referencias incompletas y perfeccionar activos mediante instrucciones sucesivas. El proyecto oficial también demuestra flujos de trabajo con agentes que preparan imágenes de referencia, identifican regiones de edición e invocan SeMo3D. Esto sugiere una división útil del trabajo: un agente traduce la intención en una solicitud de modelado, mientras el modelo 3D se encarga de la síntesis regional. Demostraciones interactivas del proyecto.
La preparación para su uso sigue siendo limitada. Según la comprobación del 6 de noviembre de 2026, el repositorio oficial contiene documentación y activos de demostración; los pesos y el código de entrenamiento, inferencia y evaluación aún no se han publicado. Su licencia MIT no establece las condiciones de licencia para futuros pesos. Este artículo revisa el trabajo y el repositorio disponible, sin afirmar que se haya realizado una reproducción independiente. Lista de comprobación de lanzamiento.
Los autores identifican dos líneas de investigación. Las representaciones 3D de mayor fidelidad podrían captar mejor estructuras delgadas, como las frondas de palmera, que los latentes estructurados actuales tienen dificultades para resolver. Los codificadores visión-lenguaje más potentes podrían mejorar la comprensión de indicaciones composicionales complejas; el artículo muestra frutas naranjas que se convierten en textura naranja en lugar de objetos separados. Limitaciones y trabajo futuro. Los hitos de lanzamiento pendientes del proyecto son los pesos del modelo en Hugging Face y el código completo de inferencia, entrenamiento y evaluación. Lista oficial de tareas pendientes.
Preguntas frecuentes
¿Puede SeMo3D generar o editar un recurso únicamente a partir de texto?
No. El artículo requiere orientación mediante imágenes; el texto y los puntos dispersos son condiciones adicionales opcionales. La edición también requiere una región seleccionada y el contexto de origen. Las demostraciones de agentes en lenguaje natural incluyen la preparación de imágenes en lugar de eliminar el requisito de imagen. [Fuente](https://arxiv.org/html/2611.02568v1#S3.SS2).
¿Puedo reemplazar el respaldo de una silla manteniendo el resto?
Eso ilustra el flujo de trabajo previsto para la edición local: seleccionar la región del respaldo, proporcionar indicaciones y sintetizar sus tokens mientras se reutilizan tokens de contexto. La preservación exacta se aplica a los tokens latentes; no debe interpretarse como una garantía de que cada vértice decodificado permanezca idéntico. [Fuente](https://arxiv.org/html/2611.02568v1#S3.SS3).
¿Puedo implementar SeMo3D localmente ahora?
Según se comprobó el 6 de noviembre de 2026, los pesos del modelo y el código completo de inferencia, entrenamiento y evaluación siguen siendo hitos de lanzamiento no verificados. El artículo público y las demostraciones permiten la evaluación técnica, pero el repositorio todavía no proporciona la pila completa de implementación local. [Fuente](https://github.com/XiaokunSun/SeMo3D#-todo).




