Frontier3DBench: Evaluación comparativa de agentes de programación para la creación 3D de objetos, escenas & mundos abiertos
Frontier3DBench evalúa la capacidad de los agentes de programación para crear proyectos 3D editables y ejecutables en objetos, escenas y mundos abiertos interactivos.
Artículo original: Frontier3DBench: Benchmarking Coding Agents for 3D Creation across Objects, Scenes, and Interactive Open Worlds (6 de noviembre de 2026; v1).
Aspectos destacados y resultados
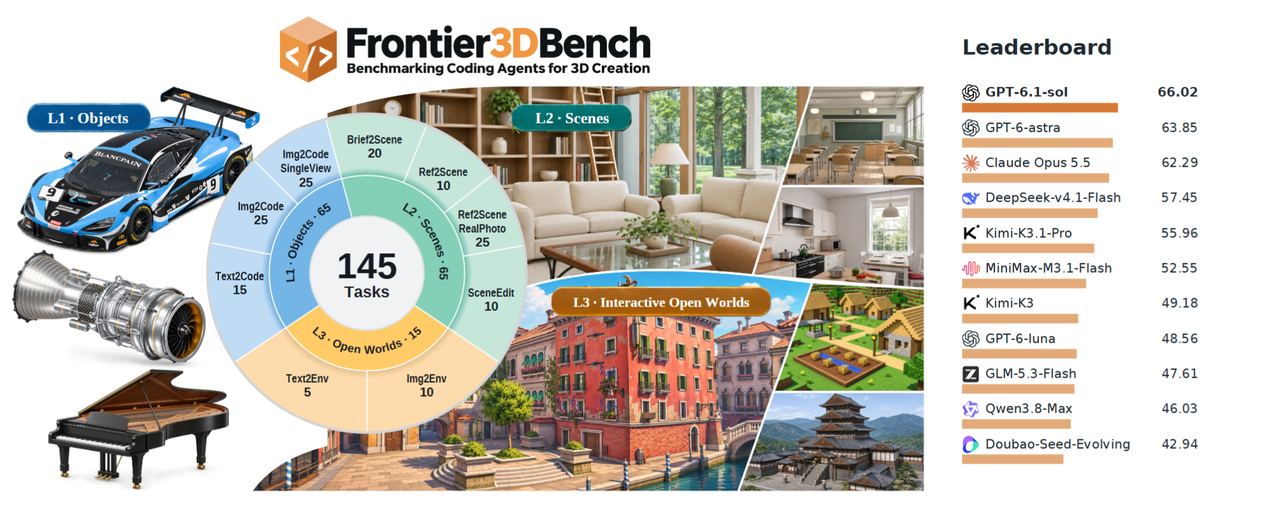
Frontier3DBench analiza si los agentes de programación pueden entregar proyectos 3D editables y ejecutables en objetos, escenas y mundos interactivos. Para los equipos que eligen un flujo de trabajo de autoría con IA, su contribución es un marco de evaluación común: 145 tareas distribuidas en nueve familias, incluidas 65 tareas de objetos en Blender, 65 tareas de escenas en Blender y 15 tareas de mundos en Unreal Engine. Las entradas incluyen instrucciones, imágenes de referencia, fotografías y escenas existentes.
Los autores evalúan 11 configuraciones de modelo–arnés. GPT-6.1-sol con Codex lidera la clasificación general con 66.02/100; GPT-6-astra con Codex lidera en mundos interactivos con 61.28. Todas las configuraciones tienen peores resultados en la reconstrucción a partir de referencias que en la generación de objetos y escenas guiada por texto. Entre 165 envíos de mundos, los mecanismos locales promedian 83.08, la holgura de las piezas móviles 20.82 y los flujos de trabajo con estado 30.26. Estas son puntuaciones de componentes, no porcentajes de mundos completados correctamente.
Un estudio humano proporciona una calibración limitada: ocho evaluadores clasifican cuatro candidatos para cada uno de los 45 elementos de objetos/escenas condicionados por referencias. Las puntuaciones automáticas alcanzan un tau-b de Kendall medio de 0.727 y un 79.2% de coincidencia en el ganador, pero solo un 44.7% de coincidencia en la clasificación completa. Esto no valida todas las familias de tareas ni el comportamiento en mundos. Véanse los experimentos.
Cómo funciona la evaluación
El agente recibe un contrato de tarea: geometría y apariencia requeridas, imágenes de referencia cuando corresponde y recursos iniciales para la edición. Las tareas de mundos también definen entidades, estados iniciales, operaciones permitidas y prerrequisitos. El agente escribe y ejecuta código de construcción y, a continuación, envía un proyecto nativo de Blender o Unreal junto con las exportaciones requeridas. Los archivos de evaluación permanecen fuera de su espacio de trabajo.
En el orquestador publicado, las comprobaciones públicas de ejecución pueden activar reparaciones, pero el agente recibe errores en lugar de puntuaciones privadas. El código fuente aceptado se congela y se calcula su hash antes de la evaluación. Evaluadores independientes vuelven a ejecutar el programa, inspeccionan la geometría nativa, renderizan vistas y juzgan el cumplimiento de la tarea. El artículo utiliza Blender 5.2.1 y Unreal Engine 5.8.3; la generación L1/L2 permite hasta seis intentos en un plazo de 32 horas. Estos son límites de presupuesto, no tiempos de finalización medidos.
La puntuación cambia según la tarea. La reconstrucción a partir de referencias combina un 50% de similitud de imagen, un 20% de localización proyectada de objetos, un 20% de evaluación visual y un 10% de detalle. La similitud de imagen mide la estructura, los bordes, el color y el tono; la localización compara las cajas de los objetos y penaliza las instancias ausentes o adicionales. GPT-6-astra, con un esfuerzo medio, evalúa criterios visuales fijos con la identidad del generador oculta. Las comprobaciones de detalle utilizan la cobertura multiplicada por uno menos la desviación y, a continuación, toman la variante de ejecución/exportación requerida más débil. Las tareas L1 ordinarias inspeccionan cuatro ejecuciones en formato nativo y GLB; L2 utiliza cuatro variantes nativas.
La edición de escenas mide por separado la modificación solicitada y la preservación del entorno protegido. La evaluación de mundos reconstruye el proyecto enviado con un observador independiente y comprueba los efectos visibles de las acciones, las intersecciones de las piezas móviles, el movimiento real de los personajes y el estado persistente. Los flujos de trabajo continuos prohíben la teletransportación y los reinicios. Por tanto, abrir una puerta de forma aislada no puede sustituir completar una ruta que requiera llegar a ella, desbloquearla y atravesarla.
Las puntuaciones de mundos ponderan la calidad visual, la fidelidad a la tarea, la disposición y la interacción en 60/20/5/15. El total final del benchmark pondera L1/L2/L3 en 30/30/40. El contrato de puntuación distingue los defectos confirmados del candidato de la falta de evidencia técnica: un fallo de API o de medición no debe convertirse silenciosamente en cero.
Aplicaciones y desafíos abiertos
El benchmark ayuda a seleccionar flujos de trabajo con agentes de programación y a diagnosticar si los fallos se refieren a la apariencia, la geometría, la edición o el comportamiento. Su repositorio abierto incluye entradas de tareas, código de generación/evaluación y contratos de puntuación; el software del benchmark utiliza Apache-2.0, mientras que los recursos de las tareas conservan sus propias licencias. Blender, Unreal Engine y el acceso a los modelos requieren configuraciones independientes.
El artículo identifica dos desafíos abiertos centrales: igualar la geometría y las disposiciones especificadas, y coordinar las piezas móviles, las acciones y el estado persistente. Esas son las líneas de investigación de los autores, no funcionalidades de producto anunciadas. Las comparaciones describen configuraciones completas de modelo–arnés, y la evaluación visual conserva límites de calibración; las tareas fotográficas tampoco cuentan con una verdad fundamental 3D nativa universal. Esta reseña analiza el artículo y la implementación, pero no vuelve a ejecutar el benchmark.
Preguntas frecuentes
¿Es Frontier3DBench en sí un modelo de generación 3D?
No. Proporciona tareas y evaluadores para agentes de programación que construyen proyectos de Blender y Unreal. No introduce un generador de mallas entrenado ni una nueva representación latente 3D.
¿Por qué las capturas de pantalla no son suficientes para un envío?
El contrato exige artefactos nativos editables y un comportamiento ejecutable. Los evaluadores inspeccionan la geometría, vuelven a renderizar las escenas guardadas y prueban las interacciones, por lo que la apariencia por sí sola no puede demostrar la corrección.
¿La puntuación general más alta identifica al mejor agente para cada trabajo?
No. Los líderes varían según la familia de tareas, y la puntuación incluye el arnés y la configuración de razonamiento. Compara el perfil de tarea pertinente antes de elegir un flujo de trabajo.




