SeMo3D: Vereinheitlichung von 3D-Generierung, -Bearbeitung und -Vervollständigung durch selektive Modellierung
SeMo3D führt einen einheitlichen Ansatz für die 3D-Generierung, lokale Bearbeitung und Vervollständigung mithilfe selektiver Modellierung ein.

Höhepunkte und Ergebnisse: Was wirklich zählt, verändern
Originalarbeit: SeMo3D: Unifying 3D Generation, Editing, and Completion via Selective Modeling
SeMo3D, von Forschern der Universität Nanjing vorgestellt, vereint 3D-Generierung, lokales Bearbeiten und Vervollständigung in einem Rahmenwerk. Für Teams, die KI-gestützte Asset-Erstellung untersuchen, liegt das zentrale Versprechen in der Kontinuität: ein Objekt erstellen, eine ausgewählte Region überarbeiten oder einen fehlenden Abschnitt rekonstruieren und dabei den vorhandenen Kontext beibehalten. Der Name steht für Selective Modeling, eine Strategie, bei der die zu synthetisierende Region die gemeinsame Schnittstelle zwischen diesen Aufgaben bildet. Offizielles Repository.
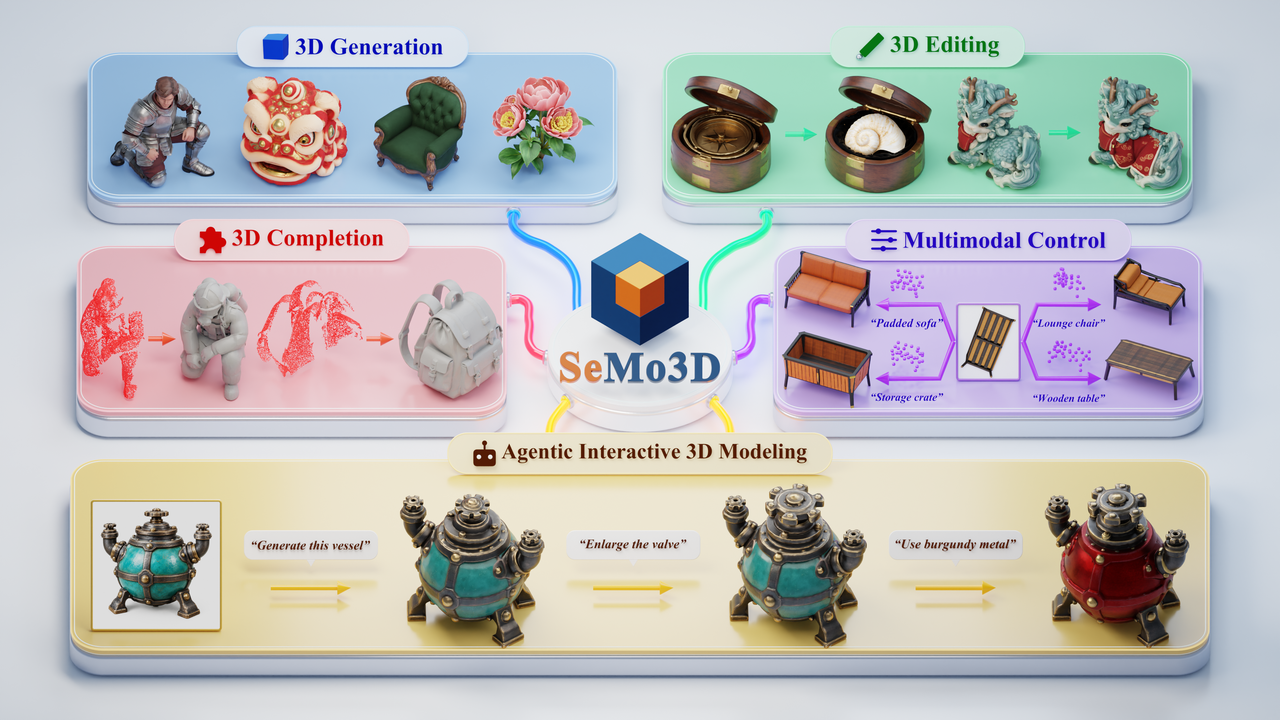
Für Toys4K berichten die Autoren eine geometrische Chamfer-Distanz von 0.0118 gegenüber 0.0330 bei TRELLIS.2 (niedriger ist besser). Die Erhaltung beim Bearbeiten erreicht 37.39 dB PSNR gegenüber 31.55 dB bei VoxHammer. Der F-Score der Vervollständigung erreicht 0.541 gegenüber 0.412 bei HY3D-Omni mit zusätzlicher Punktführung. Die unterstützten Eingaben unterscheiden sich je nach Methode, und die Punkthinweise stammen aus den Ground-Truth-Daten; diese Vergleiche isolieren keine Architekturvorteile. Arbeit, Tabellen 1–3.
Funktionsweise: Auswählen, synthetisieren, bewahren
Die zentrale Abstraktion teilt ein Asset in eine ausgewählte Region S und den bewahrten Kontext C. Bei der Generierung wird alles ausgewählt; beim Bearbeiten wird das Ziel ausgewählt; bei der Vervollständigung wird das Fehlende ausgewählt. Bei einem Stuhl könnte dieselbe Schnittstelle den gesamten Stuhl erstellen, seine Rückenlehne ersetzen oder ein fehlendes Bein rekonstruieren. Dies sind beispielhafte Anwendungen der Aufgabendefinition. Das Modell lernt ein gemeinsames Problem der regionalen Synthese, anstatt ein separates aufgabenspezifisches Trainingsverfahren zu benötigen. Repository-Übersicht.
SeMo3D optimiert die drei Flow-Modelle von TRELLIS.2 auf Trellis-500K und verwendet dessen SC-VAE wieder. Die Sparse-Struktur sagt die Belegung auf einem 16³-Latent-Raster voraus; Form und Textur arbeiten an belegten Positionen in einem 32³-Raster und erzeugen Geometrie und PBR-Materialien. Die Maske wird über die Stufen hinweg übertragen. Die Vereinheitlichung der Aufgaben verwendet somit weiterhin drei stufenspezifische Modelle. Arbeit, Methoden- und Trainingsdetails.
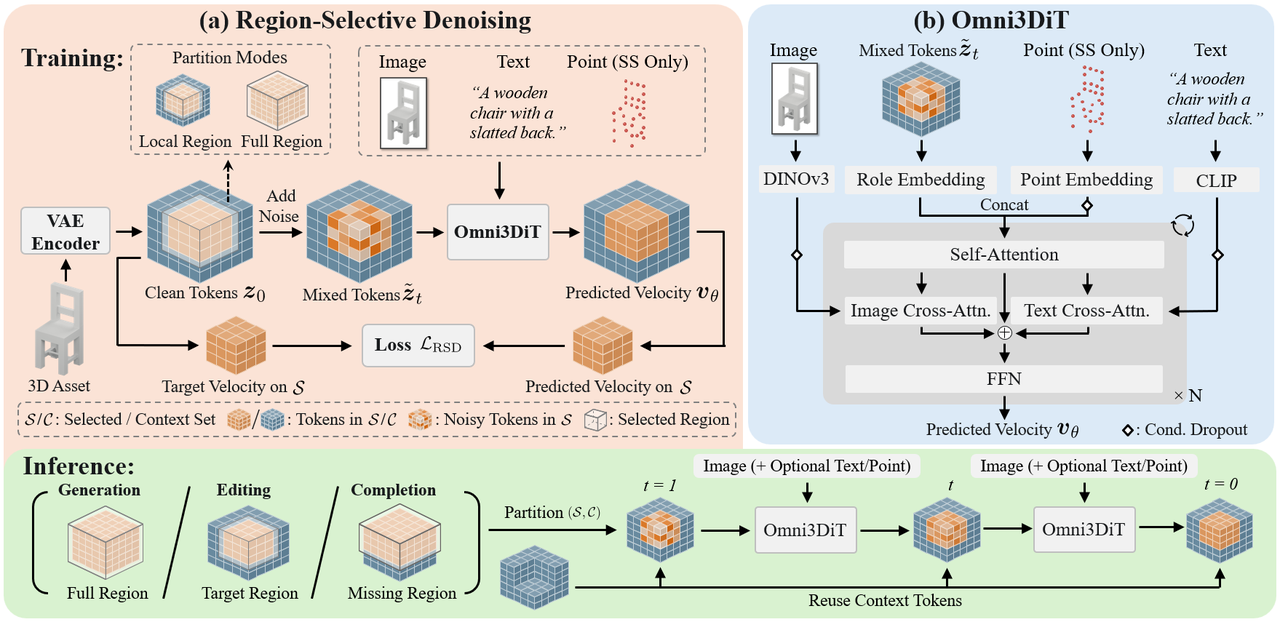
Regionsselektives Denoising erzeugt Trainingsbeispiele aus gewöhnlichen Assets. Eine zufällige Region erhält Rauschen, während ihre Umgebung unverändert bleibt; nur die Vorhersagen in dieser Region tragen zum Verlust bei. Das Training erstreckt sich von lokalen Boxen bis hin zu vollständigen Assets und vermeidet gepaarte Datensätze für Bearbeitungen oder Vervollständigungen mit Vorher-Nachher-Beispielen. Bei der Inferenz starten ausgewählte Tokens mit Rauschen und entwickeln sich unter Führung weiter, während die ursprünglichen Kontext-Tokens bei jedem Schritt wiederverwendet werden. Das Modell kann daher das gesamte Objekt berücksichtigen, ohne es vollständig neu zu synthetisieren. Offizielle Methodenerklärung.
Omni3DiT macht diese gemischte Eingabe verständlich. Rollen-Embeddings kennzeichnen ausgewählte und Kontext-Tokens. Parallele Cross-Attention-Zweige speisen DINOv3-Bildmerkmale und CLIP-Textmerkmale ein; Punkt-Tokens gelangen in der Sparse-Strukturstufe in die Self-Attention. Bilder steuern das Erscheinungsbild, Text fügt semantische Absicht hinzu und Punkte schränken die räumliche Anordnung ein. Condition Dropout variiert während des Trainings die verfügbare Führung und ermutigt das Modell, die komplementären Signale zu nutzen. Offizielles Architekturdiagramm.
Ein Bild bleibt zwingend erforderlich. Bei der Generierung werden pro Stufe 12 Euler-Schritte verwendet; beim Bearbeiten und Vervollständigen 50 für die Struktur und 12 für Form und Textur. Die strikte Erhaltung gilt für Latent-Tokens, nicht notwendigerweise für jeden dekodierten Vertex. Arbeit und Inferenzanhang.
Anwendungen und nächste Schritte
Die praktische Chance liegt in iterativen Arbeitsabläufen: Varianten von Requisiten erkunden, unvollständige Referenzen reparieren und Assets durch aufeinanderfolgende Anweisungen verfeinern. Das offizielle Projekt demonstriert außerdem agentenbasierte Workflows, die Referenzbilder vorbereiten, Bearbeitungsregionen identifizieren und SeMo3D aufrufen. Dies deutet auf eine sinnvolle Arbeitsteilung hin: Ein Agent übersetzt die Absicht in eine Modellierungsanfrage, während das 3D-Modell die regionale Synthese übernimmt. Interaktive Projektdemonstrationen.
Die Einsatzbereitschaft bleibt begrenzt. Nach Prüfung am 6. November 2026 enthält das offizielle Repository Dokumentation und Demonstrations-Assets; Gewichte sowie Trainings-, Inferenz- und Evaluierungscode sind weiterhin nicht veröffentlicht. Die MIT-Lizenz legt keine Lizenzbedingungen für künftige Gewichte fest. Dieser Artikel bespricht die Arbeit und das verfügbare Repository, ohne eine unabhängige Reproduktion zu beanspruchen. Veröffentlichungs-Checkliste.
Die Autoren nennen zwei Forschungsrichtungen. Höherwertige 3D-Repräsentationen könnten dünne Strukturen wie Palmwedel besser erfassen, die mit den aktuellen strukturierten Latents nur schwer aufgelöst werden können. Leistungsfähigere Vision-Language-Encoder könnten das Verständnis komplexer kompositorischer Prompts verbessern; die Arbeit zeigt, dass orangefarbene Früchte zu einer orangefarbenen Textur statt zu separaten Objekten werden. Einschränkungen und zukünftige Arbeiten. Die verbleibenden Veröffentlichungsschritte des Projekts sind Modellgewichte auf Hugging Face sowie vollständiger Inferenz-, Trainings- und Evaluierungscode. Offizielle TODO-Liste.
Häufig gestellte Fragen
Kann SeMo3D ein Asset allein aus Text generieren oder bearbeiten?
Nein. Das Paper erfordert Bildführung; Text und spärliche Punkte sind optionale zusätzliche Bedingungen. Die Bearbeitung erfordert außerdem eine ausgewählte Region und Quellkontext. Demonstrationen von Agenten in natürlicher Sprache umfassen die Bildvorbereitung, anstatt die Bildanforderung zu entfernen. [Quelle](https://arxiv.org/html/2611.02568v1#S3.SS2).
Kann ich die Rückenlehne eines Stuhls austauschen und den Rest behalten?
Das veranschaulicht den vorgesehenen Workflow für die lokale Bearbeitung: Wählen Sie den Bereich der Rückenlehne aus, geben Sie Anweisungen vor und synthetisieren Sie dessen Tokens, während Sie Kontext-Tokens wiederverwenden. Die exakte Erhaltung gilt für latente Tokens; sie sollte nicht als Garantie dafür verstanden werden, dass jeder dekodierte Vertex identisch bleibt. [Quelle](https://arxiv.org/html/2611.02568v1#S3.SS3).
Kann ich SeMo3D jetzt lokal bereitstellen?
Bei einer Prüfung am 6. November 2026 galten die Modellgewichte sowie der vollständige Code für Inferenz, Training und Evaluierung weiterhin als nicht überprüfte Meilensteine der Veröffentlichung. Die öffentliche Publikation und die Demonstrationen ermöglichen eine technische Bewertung, aber das Repository stellt noch nicht den vollständigen Stack für die lokale Bereitstellung bereit. [Quelle](https://github.com/XiaokunSun/SeMo3D#-todo).




