sand3D: 3D-Assets, die Sie als Code lesen und bearbeiten können
sand3D ermöglicht Sprachmodellen, bearbeitbare 3D-Assets mithilfe eines kompakten Python-Vokabulars zu erstellen, wobei Blenders bpy für parametrische Modellierung genutzt wird.

Höhepunkte und Ergebnisse
sand3D gibt Sprachmodellen ein kompaktes Vokabular zum Erstellen von 3D-Objekten in Python. Entwickelt von Thibault Neveu und Andréa Loy bei Sandflow, wandelt es Programme mithilfe von Blenders bpy in benannte Teile, Materialien und gegliederte Baugruppen um. Wird eine Dimension geändert und das Programm erneut ausgeführt, wird das Asset neu erstellt. Die öffentliche Veröffentlichung kombiniert eine Modellierungsbibliothek mit Datensätzen; sie stellt kein eigenständiges trainiertes Text-zu-3D-Modell bereit. Offizielles Repository.
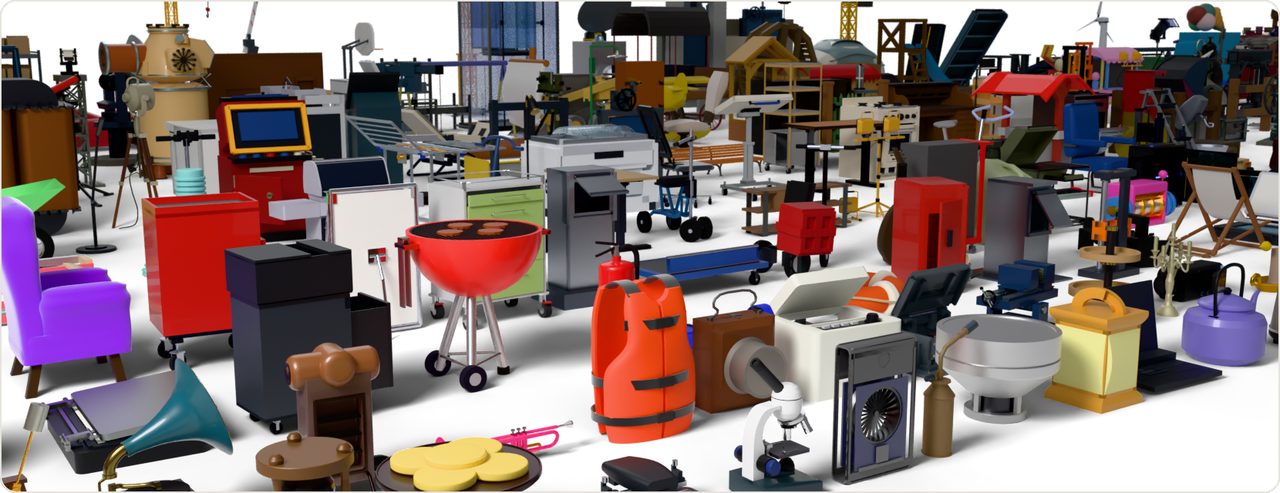
Die fünf Datensatzkarten führen 66.887 Objaverse-Objekte, 24.495 CAD-Objekte, 9.209 Articraft-Objekte, 2.334 SimReady-Objekte und 3.169 AutoMate-Datensätze auf: insgesamt 106.094, darunter 10.456 gegliederte Objekte. Die Zahl für AutoMate umfasst 2.297 einzelne Teile und 872 Baugruppen. Jeder Datensatz verknüpft ausführbaren Code mit einem Rendering und einem exportierten OpenUSD-Asset. Dies ist eine Sammlung rekonstruierter Quell-Assets, nicht von 100.000 neu entworfenen Mechanismen. Offizielle Datensätze.
Der Tokenvergleich des Repositorys verwendet o200k_base und schließt Kommentare sowie Docstrings aus. Die medianen Verhältnisse zwischen Baseline und sand3D betragen 4,0× für von LLMs geschriebenes Blender-Python bei 30 CAD-Teilen, 2,3× für 17 CadQuery-Programme, 6,0× für 13 FeatureScript-Programme und 2,0× für 12 Articraft-Programme. Dies sind kleine Vergleiche aus unterschiedlichen Quellen mit kuratierten sand3D-Programmen; nur 9/30 Blender-Baselines erstellen das richtige Teil, und Articraft repräsentiert außerdem Dynamik. Sie stützen die Aussage zur Kompaktheit, nicht eine universelle Verbesserung der Generierungsqualität. Details zur Evaluation.
Funktionsweise
Für die Erstellung lautet der Arbeitsablauf: die API einem LLM bereitstellen oder direkt Python schreiben; die Baugruppe und ihre Parameter beschreiben; einzelne Teile erstellen und platzieren; Gelenke und Materialien deklarieren; das Programm in bpy ausführen; prüfen, überarbeiten und exportieren. Die API mit ungefähr 3.600 Tokens passt in einen Prompt. Das empfohlene Programmlayout beschreibt zuerst den Baugruppenplan und implementiert anschließend jedes Teil separat, sodass Abmessungen und Platzierungsbeziehungen lesbar bleiben. Die bearbeitbare Repräsentation besteht aus ausführbarem Geometriecode und einer Szenenhierarchie; die Bibliothek implementiert weder latente Kodierung noch Diffusions-Entrauschung. Richtlinien zum Schreiben; API.
Das Geometrievokabular geht von 2D-Profilen zu Volumenkörpern über: rect und circle definieren Querschnitte; extrude, revolve, sweep und loft erstellen Volumen; cut, pocket, shell und fillet bearbeiten sie. Frame-Objekte beschreiben Position und Ausrichtung, sodass eine Komponente auf einer benannten Fläche oder einem lokalen Anker statt anhand einer langen Liste von Weltkoordinaten platziert werden kann. group bewahrt separate Meshes und Materialien unter einem gemeinsamen übergeordneten Objekt; join führt eine Verschmelzung durch; assembly fügt einem gruppierten Stammobjekt benannte Anker hinzu. Diese Unterscheidungen bewahren, welche Teile zusammengehören und welche separat bearbeitbar bleiben. Implementierung der Baugruppe.
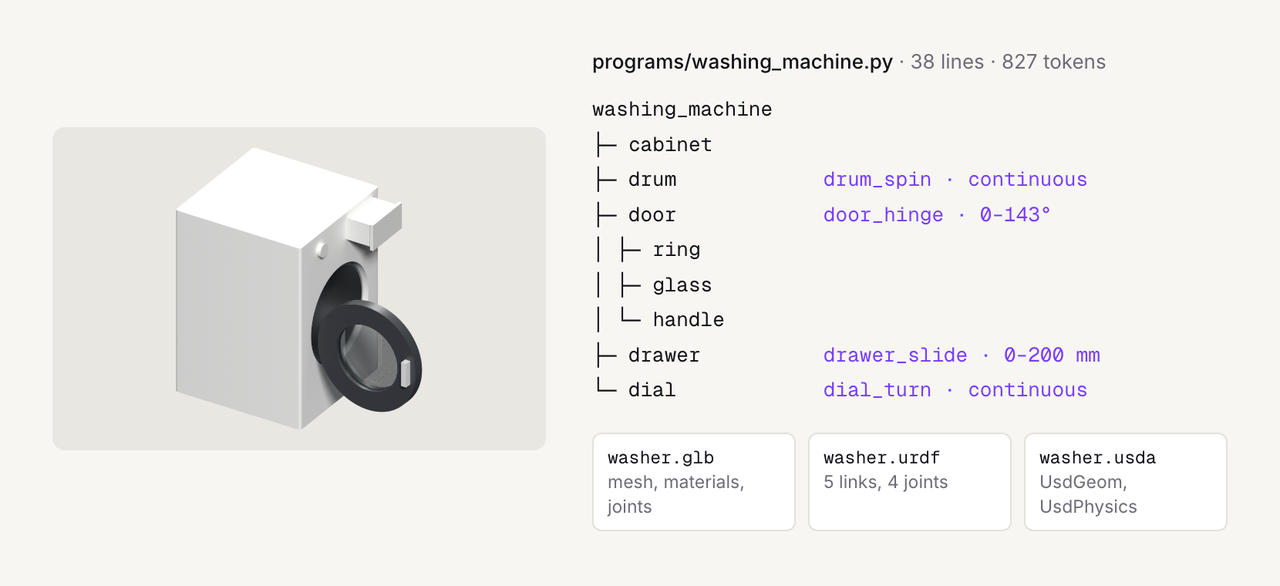
Das Beispiel einer Waschmaschine macht die Mechanik konkret: Ein Gehäuse trägt eine Trommel, eine Tür mit Ring, Glas und Griff, eine Schublade und einen Drehknopf. Nachdem diese Teile in ihrer Ruheposition platziert wurden, zeichnet joint übergeordnetes Objekt, Drehpunkt, Achse, Typ und zulässigen Bereich auf. Die Tür dreht sich durch 0–143°, die Schublade gleitet 0–200 mm, und Trommel sowie Drehknopf drehen sich kontinuierlich. pose validiert den angeforderten Wert und propagiert Transformationen durch Vorwärtskinematik; die Geometrie wird dabei nicht neu erzeugt. seat entfernt das Volumen, das ein eingesetztes Teil in Ruheposition einnimmt, anstatt seine vollständige Bewegungsbahn zu berechnen. Beispiel; Implementierung von Gelenken.
Die Datensatzproduktion ergänzt eine agentische Rekonstruktionsschleife: Code schreiben, ihn ausführen, die resultierende Oberfläche mit einem vorhandenen Quell-Asset vergleichen und überarbeiten. Die Autoren haben die vollständige Methode dieser Pipeline noch nicht veröffentlicht. Die F-Scores der Datensätze verwenden eine Toleranz von 1 % der Diagonale der Bounding Box. Die Akzeptanzgrenzen liegen bei 0,70 für Objaverse und statische SimReady-Objekte, bei 0,90 für CAD und starre Articraft-Objekte sowie bei 0,90 pro beweglichem Teil plus korrekten Gelenken für gegliederte Assets. Dies sind von der Pipeline gemeldete Qualitätsfilter, keine unabhängig gemessenen Testergebnisse. Fehlgeschlagene Ausführung oder statische Prüfungen schließen ein Programm aus. Methodik des Datensatzes.
Anwendungen, Verfügbarkeit und zukünftige Richtungen
Die Repräsentation eignet sich für bearbeitbare Asset-Varianten, interaktive Mechanismen und Forschung zur LLM-basierten 3D-Erstellung. GLB exportiert die aktuelle Pose, Materialien und Gelenkmetadaten in Node-Extras; generische Viewer benötigen zusätzliche Logik, um diese Gelenke zu bedienen. URDF und USDA bewahren den Mechanismus in Ruheposition, wobei USDA UsdGeom und UsdPhysics verwendet. OBJ/STL enthalten ausschließlich Meshes. Beim Export werden Längen auf Meter skaliert. Masse-, Reibungs- und Betätigungsparameter liegen außerhalb der Dynamikbeschreibung der Bibliothek, daher erfordert die Simulationsintegration weiterhin Arbeit. Implementierung des Exports.
Die Bibliothek steht unter Apache-2.0; für die Datensatzveröffentlichungen gilt CC BY 4.0, wobei die Lizenzierung und Namensnennung der Quellen beibehalten werden. Der derzeitige Umfang konzentriert sich auf Objekte mit harten Oberflächen, und bei der Rekonstruktion können kleine Details fehlen. Die Autoren nennen organische Formen als zukünftige Arbeit; mögliche Ergänzungen umfassen implizites Blending, Subdivision mit Kontrollkäfigen, Sweeps und Lofts mit variablen Querschnitten, Skelette mit Skinning sowie prozedurale Verschiebung. Sie versprechen außerdem weitere Domänen und einen bevorstehenden Preprint; dies sind weiterhin Pläne. Diese Besprechung untersuchte die offizielle Dokumentation und den Quellcode zum Commit 0d589a5, Version 1.6.2, am 6. November 2026; die Benchmarks wurden nicht unabhängig ausgeführt. Offizielle Veröffentlichung und Einschränkungen.
FAQ
Erhalte ich durch die Installation von sand3D ein Text-zu-3D-Modell?
Installiert wird eine Python-Modellierungsbibliothek. Ein LLM oder eine Person muss Programme unter Verwendung der API schreiben; bpy führt sie aus, um die Assets zu erstellen. Die Datensätze stellen Codebeispiele bereit, keinen eigenständigen trainierten Generator. Quelle.
Wie würde ich ein Asset mit einer anderen Größe erstellen?
Bearbeite die von seinem Programm bereitgestellten Abmessungen und führe es erneut aus. Platzierungsbeziehungen und benannte Teile machen solche Änderungen überprüfbar. Nur Beziehungen, die tatsächlich im Programm kodiert sind, werden automatisch aktualisiert; prüfe daher das neu erstellte Ergebnis. Quelle.
Sind exportierte Mechanismen sofort für physikalische Simulationen bereit?
URDF und USDA übertragen die Gelenkstruktur, für die Simulation werden jedoch weiterhin Dynamikparameter wie Masse, Reibung und Betätigung benötigt. GLB speichert Gelenkmetadaten in Extras; eine Anwendung muss sie interpretieren, um den Mechanismus zu animieren. Quelle.




