Ling-3.2-flash: Von visuellen Referenzen zu 3D-Workflows
Ling-3.2-flash ist ein multimodales Basismodell, das visuelle Referenzen in umsetzbare Skripte für 3D-Workflows umwandelt und so eine iterative Prüfung und Verfeinerung gerenderter Ergebnisse ermöglicht.

Höhepunkte und Belege
Ling-3.2-flash ist Ant Lings multimodales Basismodell zur Interpretation von Bildern, Text und Videos sowie zur Ausführung von Aufgaben mithilfe von Tools. Für 3D-Entwickler ist die interessante Demonstration ein Workflow, der eine visuelle Referenz in Skripte umwandelt und deren gerenderte Ergebnisse wiederholt überprüft. Die öffentlich zugänglichen Belege betreffen modellgesteuerte Erstellung und Überarbeitung; sie belegen kein dediziertes Image-to-Mesh-Netzwerk.
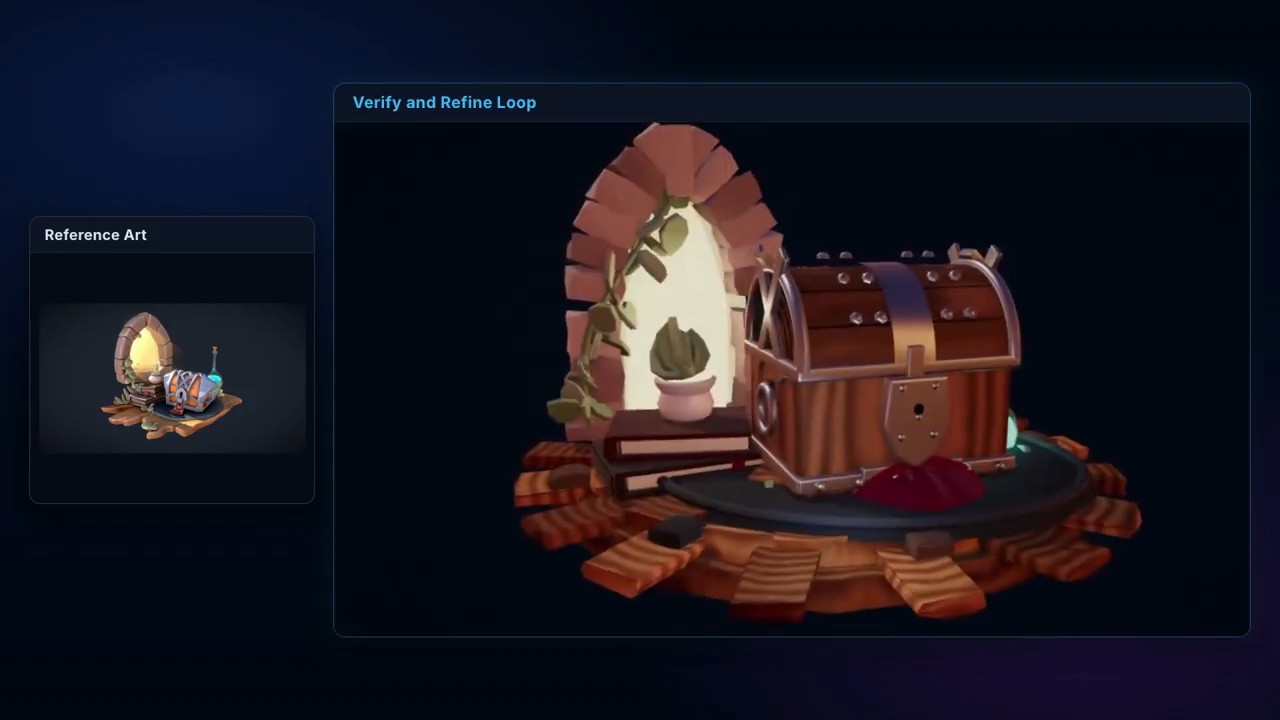
Videoquelle: Ant Ling — 3D-Szenen aus 2D-Referenzen.
Offizielle Spezifikationen beschreiben ein Mixture-of-Experts-Modell mit insgesamt 560 Milliarden Parametern, von denen pro Token etwa 25 Milliarden aktiviert werden, sowie einem Kontextfenster von bis zu einer Million Tokens. Die Veröffentlichung betont komplexes visuelles Verständnis, lang laufende multimodale Agenten sowie 3D-Verständnis und -Interaktion.
Ant Ling berichtet 92,21 bei OmniDocBench 1.5, 43,71 bei ZEROBench (Sub) und 85,86 bei Vision2Web, verglichen mit jeweils 90,56, 39,52 und 80,20 für den Vergleich mit Opus 5 max. Dies sind vom Anbieter berichtete Ergebnisse für diese Evaluierungen. Sie messen weder die geometrische Genauigkeit in 3D noch die Nutzbarkeit von Assets oder die End-to-End-Modellierungszeit. Die geprüfte Veröffentlichung liefert Demonstrationen statt eines standardisierten Benchmarks für 3D-Rekonstruktion.
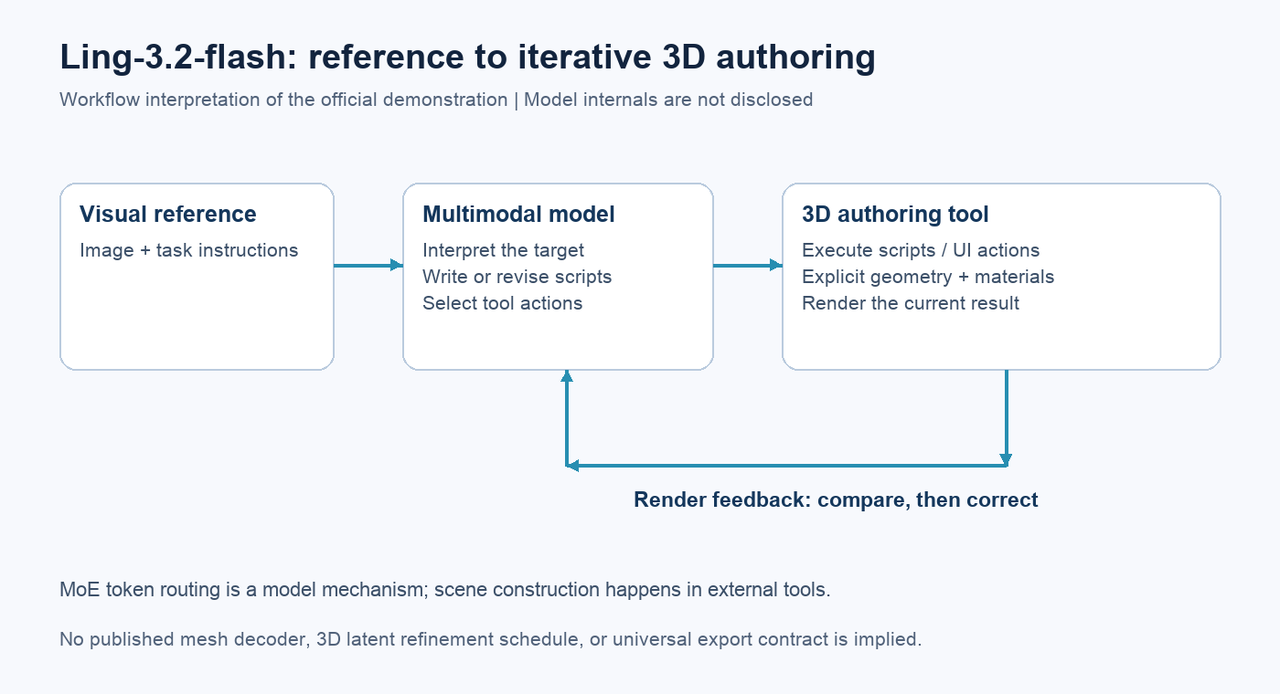
Funktionsweise des 3D-Workflows
Das offizielle 3D-Beispiel geht von einer 2D-Referenz aus und verwendet Skripte, um Spiel- oder Simulations-Assets nachzubilden. Das Modell untersucht headless Renderings von Materialkugeln, vergleicht Rauheit, Normal-Map-Effekte und Bump-Details und überarbeitet anschließend die Skripte. Auf Workflow-Ebene betrachtet besteht die Schleife aus Referenzinterpretation, Codeerstellung, Ausführung, visueller Prüfung und Korrektur. Geometrie und Materialien befinden sich in der durch das Tool erzeugten Szene; das Modell verwendet Bilder dieser Szene als Feedback.
Damit werden zwei Repräsentationen voneinander getrennt, die leicht miteinander verwechselt werden können. Das neuronale Modell verarbeitet multimodalen Kontext, während das externe Erstellungstool explizite Szenenobjekte, Materialparameter und ausführbaren Code verwaltet. Die demonstrierten Änderungen wirken auf Skripte und den Tool-Zustand. Die Veröffentlichung legt weder ein latentes 3D-Raster noch einen Mesh-Token-Decoder, einen Zeitplan für die Diffusionsverfeinerung oder ein Trainingsziel für Geometrie offen, daher können diese Mechanismen nicht aus dem Video abgeleitet werden.
Der offengelegte MoE-Mechanismus betrifft die Berechnung innerhalb des Sprachmodells: Beim Token-Routing werden ausgewählte Experten-Teilnetze aktiviert, statt bei jedem Schritt den gesamten Parameterpool zu verwenden. Daraus folgt nicht, dass jeder Experte einem 3D-Teil entspricht. Ebenso ist ein Kontextlimit von einer Million Tokens eine Kapazität zur Aufrechterhaltung von Aufgabeninformationen und keine Garantie dafür, dass eine lange Modellierungssitzung korrekt bleibt.
Ein separates offizielles Beispiel zeigt die Interaktion mit Blender über UI-Aktionen und Parameteränderungen, während ein anderes technische Zeichnungen in 3D-Webinhalte umwandelt. Diese Beispiele demonstrieren alternative Tool-Schnittstellen und sind kein Beleg dafür, dass jedes Asset einer einheitlichen Pipeline folgt. Öffentliche Materialien spezifizieren weder ein reproduzierbares 3D-Agenten-Harness noch ein Iterationsbudget, eine Abbruchregel oder ein einheitliches Exportformat. Für den Aufbau einer vergleichbaren Integration müssen daher Ausführungstools bereitgestellt und deren Renderings oder Fehler an den Agenten zurückgegeben werden.
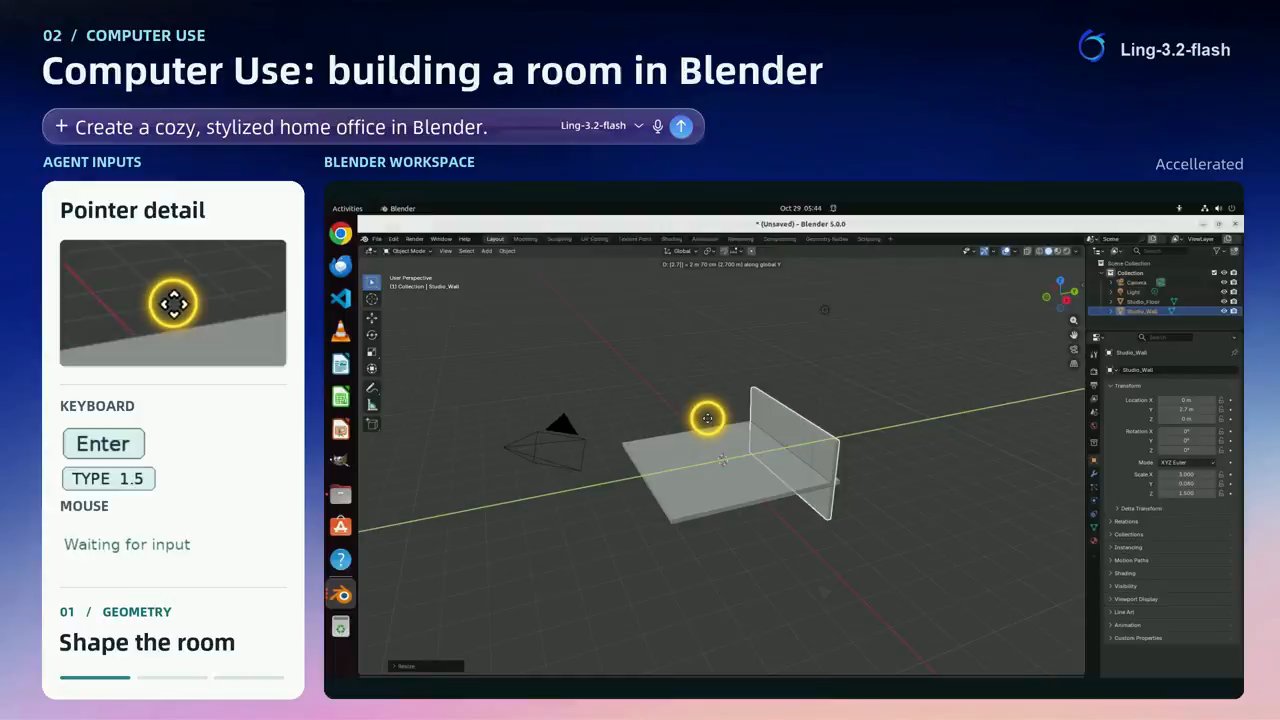
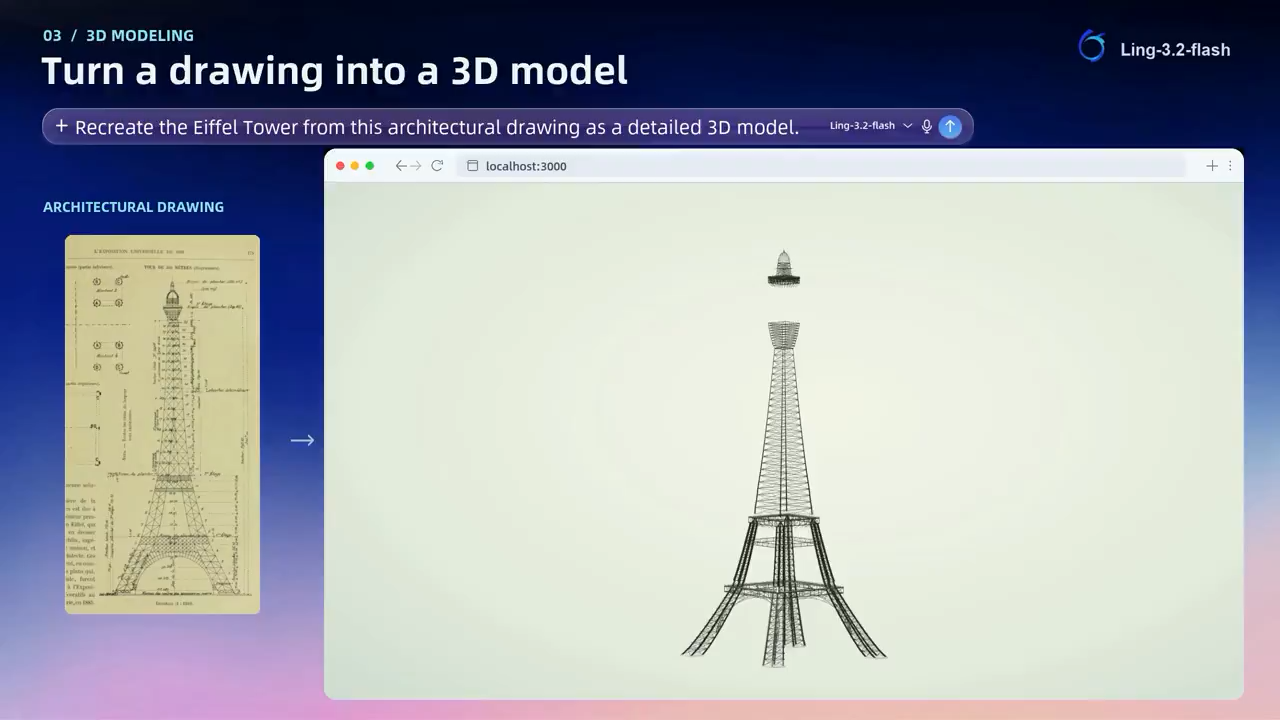
Videoquelle: Ant Ling — Frontend-Design und professionelle Tools. Diese Beispiele veranschaulichen von den Autoren berichtete Workflows und sind keine unabhängigen Genauigkeitstests.
Anwendungen, Zugang und Grenzen
Die Demonstrationen sind für visuelles Prototyping, Materialiteration und Assistenten relevant, die vorhandene 3D-Software bedienen. Ihr praktischer Reiz liegt darin, dass eine Referenz aufeinanderfolgende Änderungen an einer Szene anleiten kann, statt nur eine einmalige textuelle Beschreibung zu liefern. Die Qualität und Editierbarkeit der Assets sowie die verfügbaren Exportformate hängen weiterhin von den gewählten Tools und der jeweiligen Aufgabe ab.
Die offizielle Plattform bietet Chat-Zugang und API-Dokumentation mit OpenAI- und Anthropic-kompatiblen Request-Schnittstellen. Diese Schnittstellen ermöglichen den Modellzugang; eine funktionierende Blender-Integration bleibt davon getrennt. Die geprüfte Version 3.2 stellt weder offene Gewichte noch ein eigenständiges technisches Paper oder die Quelle ihres 3D-Demonstrationsworkflows bereit. Frühere offene Ling-Versionen sollten nicht als Implementierung von 3.2 betrachtet werden.
In den geprüften offiziellen Materialien wurde keine spezifische 3D-Roadmap für 3.2 oder Liste zukünftiger Arbeiten identifiziert. Dieser Artikel beschreibt daher offengelegte Mechanismen und Demonstrationen, ohne vorgeschlagene Architekturen oder zugesagte Exportfunktionen hinzuzufügen. Das Modell und die Demonstrationen wurden für diese Prüfung nicht unabhängig ausgeführt.
Häufig gestellte Fragen
Liefert das direkte Hochladen eines Bildes garantiert eine GLB-Datei zurück?
Die offizielle Demonstration verwendet einen Workflow aus Skripterstellung und Rendering. Ein fester Endpunkt, der GLB-Dateien zurückgibt, und ein einheitlicher Vertrag für die Asset-Bereitstellung sind in den geprüften Materialien nicht festgelegt.
Findet die Verfeinerung in einem veröffentlichten 3D-Latentraum statt?
Ein solcher Mechanismus wird nicht offengelegt. Die sichtbare Verfeinerung ändert Skripte und Szenenparameter nach der Prüfung gerenderter Rückmeldungen; die interne 3D-Darstellung des Modells ist nicht spezifiziert.
Was wird benötigt, um einen ähnlichen Blender-Workflow nachzubilden?
Modellzugriff, eine Integration, die Skripte oder UI-Aktionen ausführt, und eine Möglichkeit, Renderings und Fehler zurück in die Unterhaltung zu übertragen. Das genaue offizielle 3D-Harness wird in der überprüften Version nicht öffentlich bereitgestellt.




