Frontier3DBench: Benchmarking von Coding-Agenten für die 3D-Erstellung über Objekte, Szenen & offene Welten hinweg
Frontier3DBench bewertet die Fähigkeit von Programmieragenten, bearbeitbare und ausführbare 3D-Projekte mit Objekten, Szenen und interaktiven offenen Welten zu erstellen.
Originalarbeit: Frontier3DBench: Benchmarking von Coding-Agenten für die 3D-Erstellung über Objekte, Szenen und interaktive offene Welten (6. November 2026; v1).
Höhepunkte und Ergebnisse
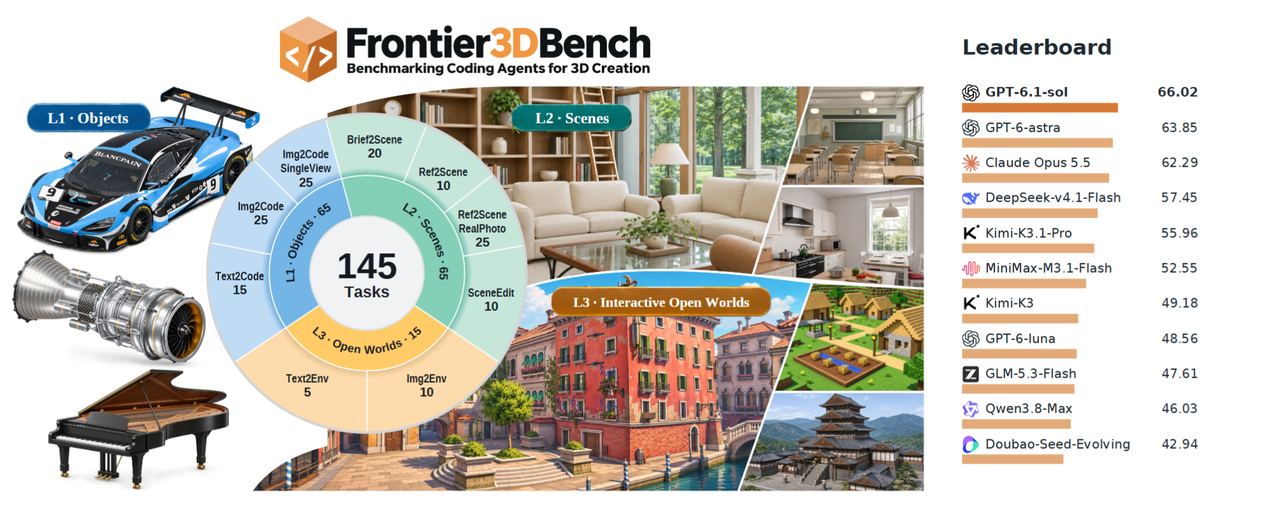
Frontier3DBench untersucht, ob Coding-Agenten editierbare, ausführbare 3D-Projekte für Objekte, Szenen und interaktive Welten erstellen können. Für Teams, die einen KI-gestützten Authoring-Workflow auswählen, besteht der Beitrag in einem gemeinsamen Bewertungsrahmen: 145 Aufgaben aus neun Familien, darunter 65 Blender-Objektaufgaben, 65 Blender-Szenenaufgaben und 15 Aufgaben zu Welten in der Unreal Engine. Zu den Eingaben gehören Anweisungen, Referenzbilder, Fotografien und bestehende Szenen.
Die Autoren bewerten 11 Modell-Harness-Konfigurationen. GPT-6.1-sol mit Codex führt insgesamt mit 66,02/100; GPT-6-astra mit Codex führt bei interaktiven Welten mit 61,28. Jede Konfiguration schneidet bei der Rekonstruktion von Referenzen schlechter ab als bei der textgesteuerten Erzeugung von Objekten und Szenen. Bei 165 Welt-Einreichungen erreichen lokale Mechanismen durchschnittlich 83,08, die Freigängigkeit beweglicher Teile 20,82 und zustandsbehaftete Workflows 30,26. Dies sind Komponentenwerte, keine Prozentsätze erfolgreich abgeschlossener Welten.
Eine Human Study liefert eine begrenzte Kalibrierung: Acht Bewerter ordnen bei jedem von 45 referenzbedingten Objekt-/Szenenelementen vier Kandidaten. Automatische Bewertungen erreichen ein mittleres Kendall-Tau-b von 0,727 und stimmen in 79,2 % der Fälle beim Gewinner überein, aber nur in 44,7 % der Fälle bei der vollständigen Rangfolge. Dies validiert nicht jede Aufgabenfamilie oder jedes Verhalten in Welten. Siehe die Experimente.
So funktioniert die Bewertung
Der Agent erhält einen Aufgabenvertrag: erforderliche Geometrie und Darstellung, gegebenenfalls Referenzbilder sowie Ausgangs-Assets zur Bearbeitung. Weltaufgaben definieren zusätzlich Entitäten, Ausgangszustände, zulässige Operationen und Voraussetzungen. Der Agent schreibt und führt Konstruktionscode aus und reicht anschließend ein natives Blender- oder Unreal-Projekt sowie die erforderlichen Exporte ein. Bewertungsdateien verbleiben außerhalb seines Arbeitsbereichs.
Im veröffentlichten Orchestrator können öffentliche Ausführungsprüfungen Reparaturen auslösen, der Agent erhält jedoch Fehler statt privater Bewertungen. Akzeptierter Quellcode wird vor der Bewertung eingefroren und gehasht. Separate Bewerter führen das Programm erneut aus, untersuchen die native Geometrie, rendern Ansichten und beurteilen die Erfüllung der Aufgabe. Die Arbeit verwendet Blender 5.2.1 und Unreal Engine 5.8.3; die L1-/L2-Erzeugung erlaubt bis zu sechs Versuche innerhalb von 32 Stunden. Dies sind Budgetobergrenzen, keine gemessenen Abschlusszeiten.
Die Bewertung ändert sich je nach Aufgabe. Die Rekonstruktion von Referenzen kombiniert 50 % Bildähnlichkeit, 20 % projizierte Objektlokalisierung, 20 % visuelle Beurteilung und 10 % Detailtreue. Die Bildähnlichkeit misst Struktur, Kanten, Farbe und Ton; die Lokalisierung gleicht Objektboxen ab und bestraft fehlende oder zusätzliche Instanzen. GPT-6-astra beurteilt bei mittlerem Aufwand festgelegte visuelle Kriterien, wobei die Identität des Generators verborgen bleibt. Bei der Detailprüfung wird die Abdeckung mit eins minus Abweichung multipliziert; anschließend wird die schwächste erforderliche Ausführungs-/Exportvariante verwendet. Gewöhnliche L1-Aufgaben prüfen vier Ausführungen in nativer Form und als GLB; L2 verwendet vier native Varianten.
Bei der Szenenbearbeitung werden die angeforderte Änderung und die Erhaltung geschützter Umgebungen getrennt gemessen. Bei der Weltbewertung wird das eingereichte Projekt mit einem unabhängigen Beobachter neu aufgebaut und auf sichtbare Aktionsauswirkungen, Überschneidungen beweglicher Teile, tatsächliche Charakterbewegung und persistenten Zustand geprüft. Kontinuierliche Workflows verbieten Teleportation und Zurücksetzen. Das isolierte Öffnen einer Tür kann daher nicht den Abschluss einer Route ersetzen, bei der man sie erreichen, entriegeln und durch sie hindurchgehen muss.
Weltbewertungen gewichten visuelle Qualität, Aufgabentreue, Layout und Interaktion mit 60/20/5/15. Die Gesamtpunktzahl des Benchmarks gewichtet L1/L2/L3 mit 30/30/40. Der Bewertungsvertrag unterscheidet bestätigte Fehler des Kandidaten von fehlenden technischen Nachweisen: Ein API- oder Messfehler darf nicht stillschweigend zu null werden.
Anwendungen und offene Herausforderungen
Der Benchmark unterstützt bei der Auswahl von Coding-Agent-Workflows und bei der Diagnose, ob Fehler die Darstellung, Geometrie, Bearbeitung oder das Verhalten betreffen. Sein offenes Repository umfasst Aufgabeneingaben, Erzeugungs-/Bewertungscode und Bewertungsverträge; die Benchmark-Software verwendet Apache-2.0, während Aufgaben-Assets ihren eigenen Lizenzen unterliegen. Für Blender, Unreal Engine und den Modellzugang ist eine separate Einrichtung erforderlich.
Die Arbeit benennt zwei zentrale offene Herausforderungen: die Übereinstimmung mit vorgegebener Geometrie und vorgegebenen Layouts sowie die Koordination beweglicher Teile, Aktionen und persistenter Zustände. Dies sind Forschungsrichtungen der Autoren, keine angekündigten Produktfunktionen. Vergleiche beschreiben vollständige Modell-Harness-Setups, und die visuelle Beurteilung behält ihre Kalibrierungsgrenzen; auch bei fotografischen Aufgaben fehlt eine universelle native 3D-Grundwahrheit. Diese Besprechung liest die Arbeit und die Implementierung, führt den Benchmark jedoch nicht erneut aus.
Häufig gestellte Fragen
Ist Frontier3DBench selbst ein 3D-Generierungsmodell?
Nein. Es stellt Aufgaben und Evaluatoren für Coding-Agenten bereit, die Blender- und Unreal-Projekte erstellen. Es führt weder einen trainierten Mesh-Generator noch eine neue latente 3D-Repräsentation ein.
Warum sind Screenshots für eine Einreichung nicht ausreichend?
Der Vertrag verlangt bearbeitbare native Artefakte und ausführbares Verhalten. Die Evaluatoren prüfen die Geometrie, rendern gespeicherte Szenen erneut und testen Interaktionen, daher kann das Erscheinungsbild allein die Korrektheit nicht belegen.
Identifiziert die höchste Gesamtpunktzahl für jeden Auftrag den besten Agenten?
Nein. Die Spitzenreiter unterscheiden sich je nach Aufgabenfamilie, und die Bewertung umfasst die Harness- und Reasoning-Konfiguration. Vergleiche das relevante Aufgabenprofil, bevor du einen Workflow auswählst.




