Frontier3DBench: Benchmarkování agentů pro programování 3D tvorby napříč objekty, scénami a otevřenými světy
Frontier3DBench hodnotí schopnost programovacích agentů vytvářet upravitelné a spustitelné 3D projekty zahrnující objekty, scény a interaktivní otevřené světy.
Původní článek: Frontier3DBench: Benchmarking kódovacích agentů pro tvorbu 3D obsahu napříč objekty, scénami a interaktivními otevřenými světy (6. listopadu 2026; v1).
Hlavní body a výsledky
Frontier3DBench zkoumá, zda kódovací agenti dokážou vytvářet upravitelné a spustitelné 3D projekty napříč objekty, scénami a interaktivními světy. Pro týmy vybírající pracovní postup pro tvorbu pomocí AI představuje jeho přínos společný evaluační rámec: 145 úloh v devíti rodinách, včetně 65 úloh s objekty v Blenderu, 65 úloh se scénami v Blenderu a 15 úloh se světy v Unreal Engine. Vstupy zahrnují instrukce, referenční obrázky, fotografie a existující scény.
Autoři vyhodnocují 11 konfigurací modelu a harnessu. GPT-6.1-sol s Codexem vede v celkovém hodnocení se skóre 66,02/100; GPT-6-astra s Codexem vede u interaktivních světů se skóre 61,28. Každá konfigurace dosahuje horších výsledků při rekonstrukci podle reference než při generování objektů a scén řízeném textem. Z 165 odevzdání světů dosahují lokální mechanismy průměru 83,08, průchodnost pohyblivých částí 20,82 a stavové pracovní postupy 30,26. Jde o dílčí skóre, nikoli o procenta úspěšně dokončených světů.
Studie s lidmi poskytuje omezenou kalibraci: osm hodnotitelů řadí čtyři kandidáty u každé ze 45 položek objektů/scén podmíněných referencí. Automatická skóre dosahují průměrného Kendallova tau-b 0,727 a shody na vítězi v 79,2 % případů, ale pouze 44,7% shody na úplném pořadí. To nevaliduje každou rodinu úloh ani chování světů. Viz experimenty.
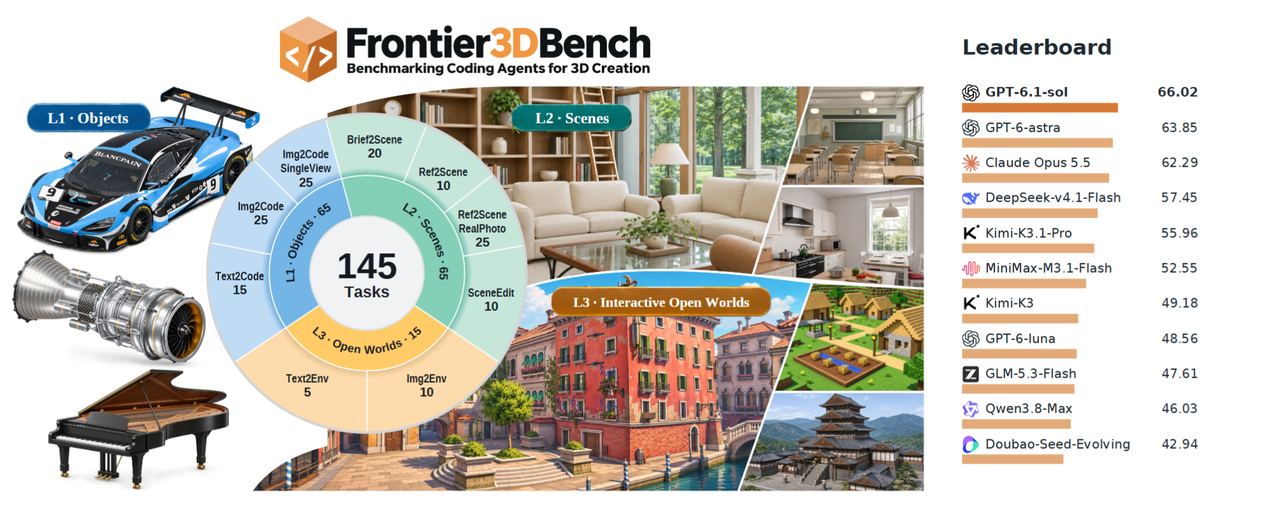
Jak hodnocení funguje
Agent obdrží kontrakt úlohy: požadovanou geometrii a vzhled, referenční obrázky, pokud jsou relevantní, a počáteční podklady k úpravám. Úlohy se světy navíc definují entity, počáteční stavy, povolené operace a předpoklady. Agent zapisuje a spouští kód pro konstrukci, poté odevzdá nativní projekt Blenderu nebo Unreal Engine spolu s požadovanými exporty. Vyhodnocovací soubory zůstávají mimo jeho pracovní prostor.
Ve zveřejněném orchestrátoru mohou veřejné kontroly spuštění vyvolat opravy, agent však obdrží chyby, nikoli neveřejná skóre. Přijatý zdrojový kód je před vyhodnocením zmrazen a opatřen hashem. Oddělení evaluátoři program znovu spustí, zkontrolují nativní geometrii, vyrenderují pohledy a posoudí splnění úlohy. Článek používá Blender 5.2.1 a Unreal Engine 5.8.3; generování L1/L2 umožňuje až šest pokusů během 32 hodin. Jde o horní hranice rozpočtu, nikoli o naměřené časy dokončení.
Bodování se mění podle úlohy. Rekonstrukce podle reference kombinuje 50 % podobnosti obrazu, 20 % lokalizace objektu v projekci, 20 % vizuálního posouzení a 10 % detailu. Podobnost obrazu měří strukturu, hrany, barvu a tón; lokalizace porovnává ohraničující rámečky objektů a penalizuje chybějící nebo nadbytečné instance. GPT-6-astra při střední úrovni úsilí posuzuje pevně stanovená vizuální kritéria, přičemž identita generátoru je skryta. Kontroly detailu používají pokrytí vynásobené jednou minus odchylka a poté zvolí nejslabší požadovanou variantu spuštění/exportu. Běžné úlohy L1 kontrolují čtyři spuštění v nativní podobě a ve formátu GLB; L2 používá čtyři nativní varianty.
Úpravy scén samostatně měří požadovanou změnu a zachování chráněného okolí. Vyhodnocení světa znovu sestaví odevzdaný projekt s nezávislým pozorovatelem a testuje viditelné účinky akcí, průsečíky pohyblivých částí, skutečný pohyb postavy a trvalý stav. Kontinuální pracovní postupy zakazují teleportaci a resetování. Otevření dveří v izolaci proto nemůže nahradit dokončení trasy, která vyžaduje dojít ke dveřím, odemknout je a projít jimi.
Skóre světa váží vizuální kvalitu, věrnost úloze, uspořádání a interakci poměrem 60/20/5/15. Celkové skóre benchmarku váží L1/L2/L3 poměrem 30/30/40. Kontrakt bodování rozlišuje potvrzené vady kandidáta od chybějících technických důkazů: selhání API nebo měření se nesmí bez upozornění změnit na nulu.
Použití a otevřené výzvy
Benchmark podporuje výběr pracovních postupů s kódovacími agenty a diagnostiku toho, zda se selhání týkají vzhledu, geometrie, úprav nebo chování. Jeho otevřený repozitář obsahuje vstupy úloh, kód pro generování a vyhodnocování a kontrakty bodování; software benchmarku používá Apache-2.0, zatímco podklady úloh si zachovávají vlastní licence. Blender, Unreal Engine a přístup k modelům vyžadují samostatné nastavení.
Článek identifikuje dvě hlavní otevřené výzvy: sladění specifikované geometrie a uspořádání a koordinaci pohyblivých částí, akcí a trvalého stavu. Jde o výzkumné směry autorů, nikoli o oznámené produktové funkce. Srovnání popisují kompletní nastavení modelu a harnessu a vizuální hodnocení si zachovává omezení kalibrace; fotografické úlohy také postrádají univerzální nativní 3D referenční pravdu. Tato recenze vychází z článku a implementace, benchmark však znovu nespouští.
Časté dotazy
Je Frontier3DBench sám o sobě modelem pro generování 3D?
Ne. Poskytuje úkoly a evaluátory pro kódovací agenty, kteří vytvářejí projekty v Blenderu a Unreal Engine. Nepředstavuje natrénovaný generátor 3D sítí ani novou latentní reprezentaci 3D.
Proč jsou snímky obrazovky pro odevzdání nedostatečné?
Smlouva vyžaduje upravitelné nativní artefakty a spustitelné chování. Hodnotitelé kontrolují geometrii, znovu vykreslují uložené scény a testují interakce, takže samotný vzhled nemůže potvrdit správnost.
Určuje nejvyšší celkové skóre nejlepšího agenta pro každou práci?
Ne. Vedoucí se liší podle rodiny úloh a skóre zahrnuje konfiguraci harnessu a uvažování. Před výběrem pracovního postupu porovnejte relevantní profil úlohy.




