 01:05
テキストから 3D画像生成モデルのエクスポート
テキストから 3D クイックガイド

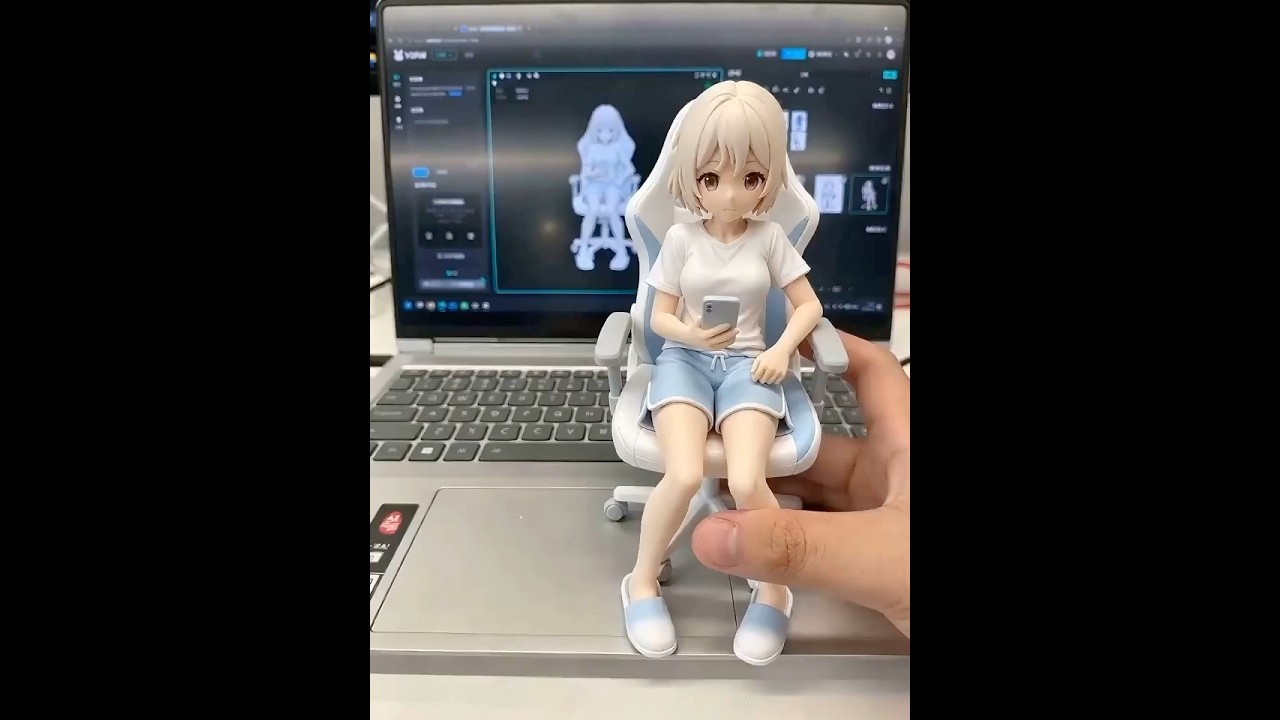
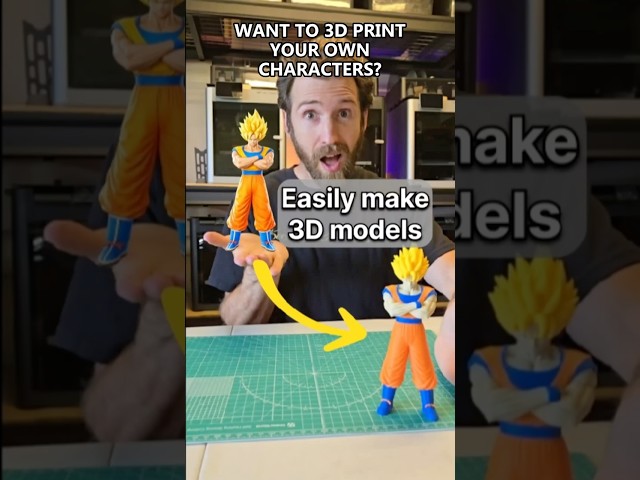
テキストプロンプトを、3D ワークフローですぐに使えるコンセプトアートに変えるにはどうすればよいでしょうか?この V2Fun の text-to-image チュートリアルでは、最初のプロンプトの作成から完成した画像を Image-to-3D に直接送信するまでの一連の手順を紹介します。
まず、プロンプトボックスにアイデアを入力します。Prompt Refine を有効にして、より明確な 3D セマンティクスでプロンプトを強化し、GPT Image2 や Nano Banana シリーズのオプションなどの Base Mode を選択して、コンセプトに合ったアスペクト比を指定します。
画像が生成されたら、次の段階に向けて出力を調整します:
リギングやアニメーション用のキャラクターには T-pose を使用
参照画像とプロンプトを組み合わせ、目的の構造を維持するには Image-to-Image を使用
位置合わせされた正投影図を作成し、3D モデリング中の死角を減らすには Multi-view Generation を使用
選択した画像をワンクリックで Image-to-3D に送信
生成した画像は V2Fun に自動保存されるため、ファイルをダウンロードして再アップロードしなくてもワークフローを続行できます。
このクイックガイドに従って、テキストプロンプトからコンセプトアート、マルチビューの参照画像、そして 1 つの統合されたワークスペース内で 3D モデルまで進めましょう。
無限の 3D クリエイティブインスピレーションを解き放つ